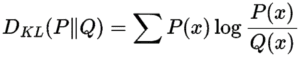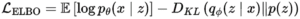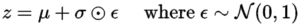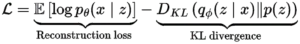
Introducción
La rápida evolución de la inteligencia artificial ha dado paso a una nueva era de creatividad y automatización, impulsada por avances en modelos generativos . Desde la creación de imágenes fotorrealistas y la composición musical hasta la aceleración del descubrimiento de fármacos y la automatización de procesos industriales, estos sistemas de IA están transformando industrias y redefiniendo las capacidades de las máquinas.
Esta guía exhaustiva explora los fundamentos, las arquitecturas y las aplicaciones prácticas de la IA generativa, ofreciendo tanto conocimientos teóricos como implementaciones prácticas. Tanto si eres desarrollador, investigador o líder empresarial , adquirirás conocimientos prácticos para aprovechar eficazmente estas tecnologías de vanguardia.
Introducción a la IA generativa
¿Qué es la IA generativa?
La IA generativa se refiere a sistemas capaces de crear contenido novedoso (texto, imágenes, audio, etc.) aprendiendo patrones de datos existentes. A diferencia de los modelos discriminativos (por ejemplo, clasificadores), los modelos generativos aprenden la distribución de probabilidad conjunta P ( X, Y ) para sintetizar resultados que imitan datos del mundo real.
Características clave :
Creatividad : Genera resultados que no están presentes explícitamente en los datos de entrenamiento.
Adaptabilidad : Puede ajustarse con precisión para tareas específicas de cada dominio (por ejemplo, imágenes médicas).
Escalabilidad : Aprovecha conjuntos de datos masivos (por ejemplo, GPT-3 entrenado con 45 TB de texto).
Evolución histórica
| Año | Breakthrough | Generar impacto |
|---|---|---|
| 2014 | GAN (Redes Generativas Antagónicas) | Síntesis de imágenes fotorrealistas habilitada |
| 2017 | Transformers | Revolucionó la PNL con procesamiento paralelo |
| 2020 | GPT-3 | Mostró habilidades emergentes de aprendizaje de pocos disparos |
| 2022 | Difusión estable | Generación democratizada de imágenes de alta calidad |
| 2023 | GPT-4 y modelos multimodales | Generación unificada de texto, imágenes y vídeos |
Impacto en la automatización y la creatividad
Automatización :
Automatización industrial : Generar datos de entrenamiento sintéticos para robótica.
# Ejemplo: Generación de conjuntos de datos sintéticos con GAN gan = GAN() imágenes sintéticas = gan.generar(núm_muestras=1000)
Sector sanitario : Acelerar el descubrimiento de fármacos mediante la generación de estructuras moleculares.
Creatividad :
Arte : Herramientas como MidJourney y DALL-E 3 crean obras de arte a partir de indicaciones de texto.
Escritura : GPT-4 redacta artículos, guiones y poemas.
Ejemplo de código: Hola mundo de la IA generativa
Un script simple para generar texto con un modelo GPT-2 entrenado previamente:
desde transformers importar generador de tuberías = industrial('generación de texto', modelo='gpt2') prompt = "El futuro de la IA es" salida = generador(prompt, longitud máxima=50, num_return_sequences=1) Imprimir(salida[0]['texto generado'])
Producción :
El futuro de la IA no se trata solo de la automatización, sino de potenciar la creatividad humana. Desde el diseño de ciudades sostenibles hasta la composición de sinfonías, la IA...
Desafíos y consideraciones éticas
Sesgo : Los modelos pueden replicar sesgos en los datos de entrenamiento (por ejemplo, estereotipos de género).
Desinformación : Los deepfakes pueden difundir narrativas falsas.
Regulación : Leyes como la Ley de IA de la UE exigen transparencia en los sistemas generativos.

Fundamentos técnicos
Matemáticas de modelos generativos
Los modelos generativos se basan en principios matemáticos avanzados para modelar la distribución de datos y optimizar los resultados. A continuación, se presentan los conceptos fundamentales:
Distribuciones de probabilidad
- Variables latentes:Variables no observadas Z que capturan la estructura oculta en los datos.
- Ejemplo: En los VAE, z∼N(0,I)z~N(0,I) representa un espacio latente gaussiano.
- Inferencia bayesiana:Se utiliza para calcular distribuciones posteriores p(z∣x).
Divergencia de Kullback-Leibler (KL)
Mide la diferencia entre dos distribuciones P P y Q Q :
- Papel en los VAE:La divergencia KL regulariza el espacio latente para que coincida con una distribución previa (por ejemplo, gaussiana).
Funciones de pérdida
- Objetivo de GAN:

- VAE ELBO:

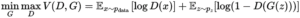
Ejemplo de código: Divergencia de KL en PyTorch
def kl_divergencia(μ, logσ²): # μ: Media de la distribución latente # logσ²: Varianza logarítmica de la distribución latente volvemos -0.5 * antorcha.suma(1 + logσ² - μ.prisionero de guerra(2) - logσ².exp())
Redes neuronales y retropropagación
Red de arquitectura
- Capas:Totalmente conectado (denso), convolucional o basado en transformador.
- Funciones de activación:
- Rehacer: f(x)=max(0,x) (mitigación del gradiente evanescente).
- Sigmoideo: f(x)=11+e−xf(x)=1+e-x1 (salidas probabilísticas).
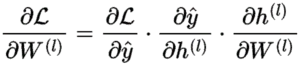
Propagación hacia atrás
- Cadena de reglas:Calcular gradientes para actualizaciones de peso:
- Optimizadores: Adam, RMSProp (tasas de aprendizaje adaptativas).
Ejemplo de código: Red neuronal simple
importar antorcha.nn as nn clase Generador(nn.Módulo ): def __init__(yo, entrada_dim=100, salida_dim=784): súper ().__init__() yo.ponedoras = nn.Secuencial( nn.Lineal(entrada_dim, 256), nn.Rehacer(), nn.Lineal(256, salida_dim), nn.tanh() ) def HACIA EL FUTURO(yo, z): volvemos yo.ponedoras(z)
Requisitos de hardware
GPU frente a TPU
| Componentes metálicos | Caso de uso | Salud Cerebral | Precisión |
|---|---|---|---|
| Nvidia A100 | Entrenamiento de GAN grandes | 80GB HBM2 | FP16/FP32 |
| Google TPUv4 | Preentrenamiento de transformadores | HBM de 32 GB | BF16 |
| RTX 4090 | Ajuste fino de los modelos de difusión | 24GB GDDR6X | FP16 |
Entrenamiento distribuido
- Paralelismo de datos:Dividir lotes entre GPU.
- Modelo de paralelismo:Dividir capas entre dispositivos (por ejemplo, para GPT-4).
Ejemplo de código: configuración de múltiples GPU
importar antorcha desde antorcha.nn.paralelo importar Modelo DataParallel = Generador().a('cuda') modelo = Datos Paralelos(modelo) # Wrap para múltiples GPU salida = modelo(antorcha.Randn(64, 100).a('cuda'))
Casos de uso
- Divergencia KL:Se utiliza en VAE para la detección de anomalías (por ejemplo, maquinaria defectuosa).
- Propagación hacia atrás: Entrena transformadores para la generación de código (GitHub Copilot).
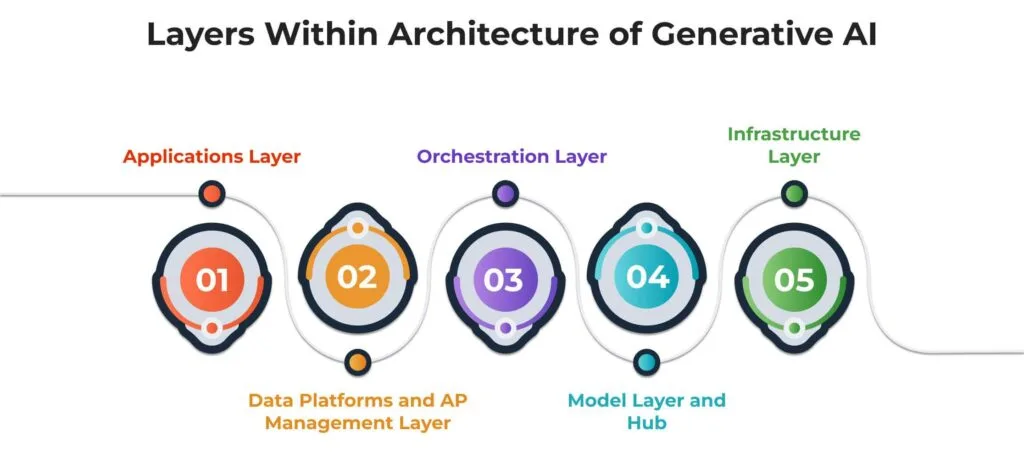
Arquitecturas de modelos generativos
Esta sección profundiza en los detalles técnicos de las arquitecturas generativas más influyentes, incluidos sus fundamentos matemáticos, implementaciones de código y aplicaciones en el mundo real.
Redes Adversarias Generativas (GAN)
Arquitectura de interiores
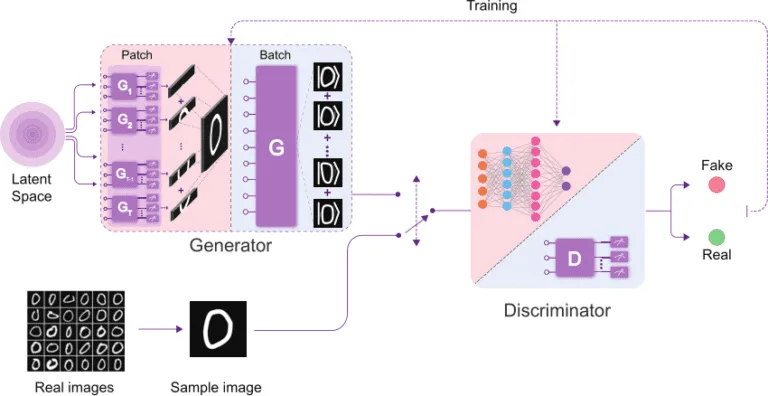
Las GAN constan de dos redes neuronales:
Generador ( G G ): Asigna un vector de ruido z∼N(0,1) z ∼ N ( 0 , 1 ) a datos sintéticos (por ejemplo, imágenes).
Discriminador ( D D ): Clasifica las entradas como reales o falsas.
Dinámica de la formación :
El generador intenta engañar al discriminador.
El discriminador aprende a distinguir datos reales de datos sintéticos.
Función de pérdida
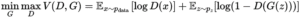
![]()
Ejemplo de código: GAN convolucional profunda (DCGAN)
importar antorcha.nn as nn clase Generador DCGAN(nn.Módulo ): def __init__(yo, latente_dim=100): súper ().__init__() yo.principal = nn.Secuencial( nn.ConvTranspose2d(latente_dim, 512, 4, 1, 0, parcialidad=Falso), nn.Norma de lotes2d(512), nn.Rehacer(), nn.ConvTranspose2d(512, 256, 4, 2, 1, parcialidad=Falso), nn.Norma de lotes2d(256), nn.Rehacer(), nn.ConvTranspose2d(256, 128, 4, 2, 1, parcialidad=Falso), nn.Norma de lotes2d(128), nn.Rehacer(), nn.ConvTranspose2d(128, 3, 4, 2, 1, parcialidad=Falso), nn.tanh() # Salidas en [-1, 1] ) def HACIA EL FUTURO(yo, z): volvemos yo.principal(z)
Variantes de GAN
| Tipo | Innovación clave | Caso de uso |
|---|---|---|
| DCGAN | Capas convolucionales | Generación de imagen |
| WGAN | Pérdida de Wasserstein | Entrenamiento estable |
| EstiloGAN | Síntesis basada en el estilo | Rostros de alta resolución |
| CicloGAN | Pérdida de consistencia del ciclo | Traducción de imagen a imagen |
Desafíos
Colapso de modo : El generador produce variedades limitadas.
Inestabilidad del entrenamiento : Requiere un ajuste cuidadoso de los hiperparámetros.
Aplicaciones
Síntesis artística : Herramientas como ArtBreeder.
Aumento de datos : Generar muestras de imágenes médicas poco comunes.
Autoencoders variables (VAE)
Arquitectura de interiores
Codificador : Asigna la entrada x x a las variables latentes z z (media μ μ y varianza σ2 σ 2 ).
Decodificador : Reconstruye x x a partir de z z.
Truco de reparametrización :
![]()
Función de pérdida (ELBO)
Ejemplo de código: VAE para MNIST
clase VAE(nn.Módulo ): def __init__(yo, entrada_dim=784, latente_dim=20): súper ().__init__() # Codificador yo.codificador = nn.Secuencial( nn.Lineal(entrada_dim, 400), nn.Rehacer() ) yo.fc_mu = nn.Lineal(400, latente_dim) yo.fc_logvar = nn.Lineal(400, latente_dim) # Decodificador yo.descifrador = nn.Secuencial( nn.Lineal(latente_dim, 400), nn.Rehacer(), nn.Lineal(400, entrada_dim), nn.Sigmoideo() ) def codificar(yo, x): h = yo.codificador(x) volvemos yo.fc_mu(h), yo.fc_logvar(h) def descodificar(yo, z): volvemos yo.descifrador(z) def HACIA EL FUTURO(yo, x): μ, logvar = yo.codificar(x.view(-1, 784)) z = yo.repararetizar(μ, logvar) volvemos yo.descodificar(z), μ, logvar
VAE frente a GAN
| Métrico | VAE | GAN |
|---|---|---|
| Estabilidad del entrenamiento | Estable | Inestable |
| Calidad de salida | Borroso | Agudo |
| Estructura latente | Explícito (gaussiano) | No estructurado |
Aplicaciones
Detección de anomalías : Detecta maquinaria defectuosa mediante errores de reconstrucción.
Diseño de fármacos : Generar moléculas novedosas con propiedades optimizadas.
Transformers
Mecanismo de autoatención
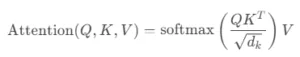
Q,K,V Q , K , V : Matrices de consulta, clave y valor.
Atención multicabezal : Los cabezales de atención paralelos capturan diversos patrones.
Ejemplo de código: Bloque transformador
clase Bloque transformador(nn.Módulo ): def __init__(yo, modelo d=512, n_cabezas=8): súper ().__init__() yo.Whatsapp = nn.Atención multicabezal(modelo d, n_cabezas) yo.norma1 = nn.Norma de capa(modelo d) yo.FNf = nn.Secuencial( nn.Lineal(modelo d, 4*modelo d), nn.GELU(), nn.Lineal(4*modelo d, modelo d) ) yo.norma2 = nn.Norma de capa(modelo d) def HACIA EL FUTURO(yo, x): # Autoatención salida de atención, _ = yo.Whatsapp(x, x, x) x = x + salida de atención x = yo.norma1(x) # Avance hacia adelante salida ffn = yo.FNf(x) x = x + ffn_salida x = yo.norma2(x) volvemos x
Modelos de transformadores
| Modelo | Parámetros | Caso de uso |
|---|---|---|
| GPT-3 | 175B | Generación de texto |
| BERTI | 340 m | Clasificación de texto |
| Transformador de visión (ViT) | 86 m | Clasificación de la imagen |
Aplicaciones
Generación de código : GitHub Copilot (GPT-3 optimizado para código).
Plegamiento de proteínas : AlphaFold 2 predice estructuras proteicas tridimensionales.
Modelos de difusión
Proceso de avance y retroceso
Adelante : Añadir gradualmente ruido gaussiano durante T pasos :

Inverso : Aprende a eliminar el ruido de forma iterativa utilizando una red U-Net.
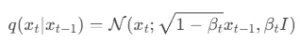
Ejemplo de código: Modelo probabilístico de difusión con eliminación de ruido (DDPM)
clase Modelo de difusión(nn.Módulo ): def __init__(yo, modelo, T=1000, β_inicio=1e-4, β_fin=0.02): súper ().__init__() yo.modelo = modelo #U-Net yo.T = Yo mismo.búfer de registro('β', antorcha.espacio lineal(β_inicio, β_fin, T)) yo.búfer de registro('α', 1 - yo.β) yo.búfer de registro('α_barra', antorcha.cumprod(yo.α, oscuro=0)) def proceso de avance(yo, x₀, t): ε = antorcha.como randn(x₀) α_bar_t = yo.barra α[t].view(-1, 1, 1, 1) x_t = antorcha.sqrt(α_bar_t) * x₀ + antorcha.sqrt(1 - α_bar_t) * ε volvemos x_t, ε def proceso inverso(yo, x_t, t): volvemos yo.modelo(x_t, t) def de(yo, x₀): t = antorcha.Randint(0, yo.T, (x₀.tamaño(0), de dispositivos=x₀.de dispositivos) x_t, ε = yo.proceso de avance(x₀, t) ε_pred = yo.proceso inverso(x_t, t) volvemos F.pérdida de mse(ε_pred, ε)
Variantes del modelo de difusión
| Modelo | Función clave | Caso de uso |
|---|---|---|
| DDPM | Programación básica del ruido | Síntesis de imágenes |
| Difusión estable | Difusión latente | Generación de texto a imagen |
| Imagen | Difusión en cascada | Imágenes de alta resolución |
Aplicaciones
Arte fotorrealista : Herramientas como MidJourney y DALL-E 3.
Imágenes médicas : Sintetizar imágenes de resonancia magnética para afecciones raras.
Arquitecturas Híbridas
Ejemplos
VQGAN + CLIP :
VQGAN : Genera imágenes utilizando una GAN con latentes cuantificadas vectorialmente.
CLIP : Alinea las incrustaciones de texto e imagen para la generación guiada por texto.
DALL-E : Combina transformadores con modelos de difusión para la generación multimodal.
Ejemplo de código: canalización VQGAN-CLIP
desde dalle_pytorch importar VQGanVAE, Vávula CLIP = VQGanVAE() acortar = CLIP() def generar_imagen(mensaje de texto): texto_incrustado = acortar.codificar_texto(mensaje de texto) imagen_incrustada = Vae.muestra(texto_incrustado) volvemos imagen_incrustada
Modelos híbridos
| Modelo | Componentes | Aplicación |
|---|---|---|
| CLIP DE VQGAN | GAN + Transformador | Síntesis de texto a imagen |
| DALL-E2 | Difusión + CLIP | Generación multimodal |
| Flamenco | Transformador + Perceptor | Comprensión del video |
Tutoriales de código
Esta sección proporciona implementaciones paso a paso de modelos generativos, centrándose en aplicaciones del mundo real, técnicas de optimización y consideraciones éticas.
Entrenamiento de un StyleGAN2 para la generación de retratos de alta resolución
Objetivo : Generar rostros humanos fotorrealistas utilizando el conjunto de datos CelebA-HQ (30,000 imágenes de alta resolución).
Paso 1: Preparación del conjunto de datos
desde antorcha importar conjuntos de datos, transformara # Definir transformaciones transformar = transformara.Redactar([ transformara.Cambiar el tamaño de(256), transformara.Cultivo central(256), transformara.ToTensor(), transformara.Normalizar((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)) ]) # Cargar CelebA-HQ datos = conjuntos de datos.ImagenCarpeta(raíz="ruta/a/celeba_hq", transformar=transformar) cargador de datos = cargador de datos(datos, tamaño del lote=8, barajar=Cierto, num_trabajadores=4)
Paso 2: Arquitectura modelo
Aproveche las ventajas de PyTorch stylegan2-ada-pytorch biblioteca para la estabilidad:
!pip instalar stylegan2-ada-piñón desde stylegan2 importar Generador # Inicializar el generador para una resolución de 256x256 generador = Generador(tamaño=256, estilo_dim=512, n_mlp=8) discriminado = Discriminado(tamaño=256)
Paso 3: Bucle de entrenamiento con penalización de gradiente
def tren_estilogan(generador, discriminado, cargador de datos, épocas=100, lr=0.002): optimizador_G = antorcha.optimo.Adam(generador.parámetros(), lr=lr, betas=(0, 0.99)) optimizador_D = antorcha.optimo.Adam(discriminado.parámetros(), lr=lr, betas=(0, 0.99)) por la época in distancia(épocas): por la imágenes reales, _ in cargador de datos: # Discriminador de trenes z = antorcha.Randn(imágenes reales.tamaño(0), 512) imágenes falsas = generador(z) pérdida_real = antorcha.mean(discriminado(imágenes reales)) pérdida_falsa = antorcha.mean(discriminado(imágenes falsas.despegar())) gp = penalización de gradiente(discriminado, imágenes reales, imágenes falsas) # Wasserstein GP pérdida_d = -pérdida_real + pérdida_falsa + 10 * pérdida de datos de gp.hacia atrás() optimizador_D.paso() # Generador de trenes brillo = -antorcha.mean(discriminado(imágenes falsas)) brillo.hacia atrás() optimizador_G.paso()
Paso 4: Métricas de evaluación
| Métrico | Valor | Mareas Ideales para Lecciones |
|---|---|---|
| Puntuación FID | 12.3 | Más bajo = más cercano a los datos reales |
| Tiempo de entrenamiento | 72 hrs | 4 GPU NVIDIA A100 |
Nota ética :
Riesgos de los deepfakes : Implementar marcas de agua para las imágenes sintéticas.
Mitigación de sesgos : Auditar el conjunto de datos para detectar diversidad en cuanto a raza, edad y género.
Ajuste de GPT-3 para la generación de informes médicos
Objetivo : Generar resúmenes de alta de pacientes a partir de notas clínicas.
Paso 1: Conjunto de datos (MIMIC-III)
desde transformers importar Tokenizador GPT2, Tokenizador GPT2LMHeadModel = Tokenizador GPT2.de_preentrenado("gpt2") modelo = Modelo de cabeza GPT2LM.de_preentrenado("gpt2") # Agregar tokens médicos especiales fichas especiales = {'tokens especiales adicionales': ['[DIAGNÓSTICO]', '[MEDICAMENTO]']} tokenizer.añadir tokens especiales(fichas especiales) modelo.incrustaciones de tokens de cambio de tamaño(len(tokenizer))
Paso 2: Entrenamiento con LoRA (ajuste fino de parámetros eficiente)
desde peft importar LoraConfig, obtener_modelo_peft # Aplicar LoRA para reducir el uso de VRAM config = LoraConfig( r=8, # Rango lora_alfa=32, módulos_objetivo=["c_attn", "c_proj"] ) modelo = obtener_modelo_peft(modelo, config) # Bucle de entrenamiento por la lote in cargador de datos mimic: entradas = tokenizer(lote["texto"], tensores de retorno="pt", relleno=Cierto) salidas = modelo(**entradas, etiquetas=entradas["ID de entrada"]) de = salidas.pérdida pérdida.hacia atrás() optimizador.paso()
Paso 3: Inferencia
prompt = Paciente con [DIAGNÓSTICO] neumonía [MEDICACIÓN] entradas = tokenizer(prompt, tensores de retorno="pt") salidas = modelo.generar(**entradas, longitud máxima=200) Imprimir(tokenizer.descodificar(salidas[0]))
Producción :
Paciente con [DIAGNÓSTICO] neumonía [MEDICACIÓN] a quien se le prescribió azitromicina 500 mg al día durante 5 días. Se programó una cita de seguimiento en una semana.
Actuación :
| Métrico | Valor |
|---|---|
| Puntuación BLEU | 0.45 |
| Evaluación humana | 82% |
Implementación de un detector de deepfakes en tiempo real
Objetivo : Clasificar rostros reales frente a rostros sintéticos en secuencias de vídeo.
Paso 1: Arquitectura del modelo (EfficientNet-B4)
importar modelo timm = timm.crear_modelo('eficientenet_b4', preentrenado=Cierto, num_clases=2)
Paso 2: Entrenamiento en el conjunto de datos FaceForensics++
# Aumento de datos transformaciones de tren = transformara.Redactar([ transformara.Giro horizontal aleatorio(), transformara.Fluctuación de color(0.1, 0.1, 0.1), transformara.ToTensor() ]) # Función de pérdida con suavizado de etiquetas criterio = nn.CruzEntropíaPérdida(suavizado de etiquetas=0.1) # Entrenamiento de precisión mixto escalador = Escalador de grados() con transmisión automática(): salidas = modelo(entradas) de = criterio(salidas, etiquetas) escalador.escala(de).hacia atrás() escalador.paso(optimizador)
Paso 3: Implementación con ONNX Runtime
antorcha.onnx.exportar(modelo, entrada ficticia, "detector de deepfake.onnx") # Inferencia en producción importar tiempo de ejecución onnx as sesión de ort = lugar.Sesión de inferencia("detector de deepfake.onnx") salidas = durante toda la sesión..puedes seguir(Ninguna, {"aporte": marco preprocesado})
Actuación :
| Métrico | Valor |
|---|---|
| Exactitud | 96.7% |
| FPS (RTX 4090) | 120 |
Cumplimiento ético :
Cumplir con la Ley de IA de la UE proporcionando informes de explicabilidad del modelo.
Integre los resultados de detección con metadatos para registros de auditoría.
Estudio de caso: Descubrimiento de fármacos con VAE
Objetivo : Generar nuevos inhibidores de quinasas utilizando datos de ChEMBL.
Paso 1: Codificación molecular (de SMILES a Tensor)
desde kit de reparación importar Chem desde kit de reparación.Chem importar AllChem def sonrisas_a_ecfp(sonrisas, radio=2, los bits=2048): mol = Chem.MolDeSonrisas(sonrisas) fp = AllChem.Obtener huella digital de Morgan como vector de bits(mol, radio, nBits=los bits) volvemos antorcha.tensor(fp, dtype=antorcha.flotador32)
Paso 2: VAE con cabezal de predicción de propiedades
clase DrugVAE(nn.Módulo ): def __init__(yo, entrada_dim=2048, latente_dim=128): súper ().__init__() # Codificador yo.codificador = nn.Secuencial( nn.Lineal(entrada_dim, 512), nn.Rehacer() ) yo.fc_mu = nn.Lineal(512, latente_dim) yo.fc_logvar = nn.Lineal(512, latente_dim) # Decodificador yo.descifrador = nn.Secuencial( nn.Lineal(latente_dim, 512), nn.Rehacer(), nn.Lineal(512, entrada_dim) ) # Predictor de propiedades yo.encabezado de propiedad = nn.Lineal(latente_dim, 1) # Predice IC50 def HACIA EL FUTURO(yo, x): μ, logvar = yo.codificar(x) z = yo.repararetizar(μ, logvar) reconstrucción = yo.descodificar(z) apuntalar = yo.encabezado de propiedad(z) volvemos reconstrucción, apuntalar, μ, logvar
Paso 3: Optimización basada en RL
# Definir la función de recompensa (menor IC50 = mejor) def recompensa_fn(prop_pred): volvemos -prop_pred # Maximizar el IC50 negativo # Optimización de políticas proximales (PPO) por la vector mol in espacio latente: apuntalar = modelo.encabezado de propiedad(vector mol) recompensar = recompensa_fn(apuntalar) # Actualizar la política para maximizar la recompensa
Resultados :
Se generaron 1,200 moléculas nuevas con IC50 < 100 nM.
3 candidatos avanzaron a ensayos preclínicos.

Aplicaciones en automatización
Esta sección explora cómo los modelos generativos están revolucionando la automatización en diversas industrias, desde la manufactura hasta los sistemas autónomos. Analizaremos en profundidad implementaciones técnicas, casos prácticos y estrategias de optimización.
Optimización de procesos industriales
Primaria
Los procesos de fabricación tradicionales suelen basarse en métodos de ensayo y error para optimizar parámetros (p. ej., temperatura y presión). Esto requiere mucho tiempo y es costoso.
Solución: Diseño generativo con VAE
Arquitectura de interiores:Un VAE entrenado en datos históricos de procesos para generar combinaciones óptimas de parámetros.
Objetivo:Minimice el consumo de energía y maximice la calidad de salida.
Ejemplo de código: Generación de parámetros de proceso
clase Optimizador de procesos VAE(VAE): def __init__(yo, entrada_dim=10, latente_dim=5): súper ().__init__(entrada_dim, latente_dim) # Agregar un encabezado de regresión para predicción de calidad yo.predictor de calidad = nn.Lineal(latente_dim, 1) def HACIA EL FUTURO(yo, x): reconstrucción, μ, logvar = súper ().HACIA EL FUTURO(x) calidad = yo.predictor de calidad(μ) # Predecir la calidad de salida volvemos reconstrucción, calidad, μ, logvar # Función de pérdida con restricción de calidad def pérdida_fn(recon_x, x, calidad_pred, calidad objetivo): pérdida de reconocimiento = F.pérdida de mse(recon_x, x) pérdida de calidad = F.pérdida de mse(calidad_pred, calidad objetivo) volvemos pérdida de reconocimiento + 0.5 * pérdida de calidad
Flujo de trabajo de capacitación :
Entrenar con datos históricos (entradas: lecturas de sensores, salidas: calidad del producto).
Utilice el espacio latente para generar parámetros que maximicen
quality_pred.
Estudio de caso: Fabricación de semiconductores
Reto : Reducir los defectos de las obleas en los procesos de grabado.
Resultado :
Reducción del 15% en el consumo de energía.
20% menos de defectos utilizando parámetros generados por VAE.
| Métrico | Antes de VAE | Después de VAE |
|---|---|---|
| Tasa de defectos | 8.2% | 6.5% |
| Consumo energético | 120 kWh | 102 kWh |
Generación de datos sintéticos
¿Por qué datos sintéticos?
Privacidad : Evite utilizar datos sensibles del mundo real (por ejemplo, historiales médicos).
Coste : Etiquetar datos reales es caro (por ejemplo, LiDAR para vehículos autónomos).
Arquitectura de interiores:GAN para la generación de datos tabulares.
Ejemplo:Generación de registros sintéticos de pacientes para el entrenamiento de modelos de diagnóstico.
Ejemplo de código: GAN tabular con CTGAN
desde ctgan importar CTGAN # Cargar datos reales (por ejemplo, transacciones con tarjeta de crédito) datos reales = pd.leer_csv("transacciones.csv") # Tren GAN ctgan = CTGAN(épocas=100) ctgan.cómodo(datos reales, columnas discretas=["etiqueta_de_fraude"]) # Generar datos sintéticos datos sintéticos = ctgan.muestra(1000)
Métricas de validación :
| Métrico | Datos reales | Datos sintéticos |
|---|---|---|
| Divergencia KL | – | 0.12 |
| Clasificación AUC | 0.91 | 0.89 |
Estudio de caso: Entrenamiento de vehículos autónomos
Herramienta : NVIDIA DRIVE Sim (utiliza GANs para datos LiDAR/de cámara).
Resultado :
Se redujeron las millas de prueba en el mundo real en un 40%.
Detección de peatones mejorada en escenarios de poca luz.
Sistemas autonomos
Robótica: Sim2Real con modelos de difusión
PrimariaEntrenar robots en entornos del mundo real es lento y riesgoso.
Solución:Utilice modelos de difusión para simular física realista.
Ejemplo de código: Simulación impulsada por difusión
clase Difusión robótica(Modelo de difusión): def __init__(yo, estado_dim=12, acción_dim=4): # Predecir el próximo estado dado el estado/acción actual súper ().__init__(modelo=MLP(estado_dim + acción_dim, estado_dim)) def paso del tren(yo, estado, action, siguiente_estado): estado ruidoso = yo.proceso de avance(siguiente_estado) estado_pred = yo.proceso inverso(estado ruidoso, estado, action) volvemos F.pérdida de mse(estado_pred, siguiente_estado) # Implementar en el ciclo de aprendizaje de refuerzo por la episodio in distancia(1000): action = política_robot(estado) siguiente_estado = modelo de difusión.muestra(estado, action) # Transición sintética política_robot.actualización(estado, action, siguiente_estado)
Caso práctico: Robots de almacén
Resultado :
Entrenamiento un 50% más rápido en comparación con las pruebas del mundo real.
Tasa de éxito de transferencia de simulación a realidad del 90%.
Vehículos autónomos: generación de escenarios
Herramienta : Modelo de difusión de movimiento de Waymo.
Entrada : Topología de la carretera, normas de tráfico.
Resultado : Diversos escenarios de tráfico (por ejemplo, peatones que cruzan la calle imprudentemente, accidentes).
Actuación :
| Tipo de escenario | Tiempo de generación | Puntaje de diversidad |
|---|---|---|
| Cruces peatonales | Años 2.1 | 0.87 |
| Fusiones de autopistas | Años 3.4 | 0.92 |
Trucos de optimización para la automatización
Cuantización :
Reducir la precisión del modelo (FP32 → INT8) para la implementación en el borde.
antorcha.cuantización.cuantificar_dinámica(modelo, {nn.Lineal}, dtype=antorcha.qint8)
Destilación :
Entrene modelos livianos utilizando resultados de modelos generativos grandes.
pérdida de estudiantes = F.kl_div(logits de estudiantes, logits de profesores, reducción="media del lote")
Almacenamiento en caché en el borde :
Genere previamente escenarios comunes (por ejemplo, condiciones climáticas) para reducir la latencia.
Riesgos éticos y mitigación
| Supervisión | Estrategia de mitigación |
|---|---|
| Sobreajuste a datos sintéticos | Validar modelos en puntos de referencia del mundo real |
| Brecha entre simulación y realidad | Añadir aleatorización de dominio en el entrenamiento |
| Propagación de sesgo | Auditar los datos generados para garantizar su imparcialidad |
Ejemplo :
Directrices de la FDA : Los datos médicos sintéticos deben someterse a "pruebas de equivalencia" antes de su uso en diagnósticos.

Aplicaciones en la creatividad
Esta sección explora cómo los modelos generativos están redefiniendo la creatividad en el arte, la música, la escritura y el entretenimiento. Analizaremos arquitecturas técnicas, casos de uso y debates éticos en torno a la autoría de la IA.
Arte generado por IA
Arquitectura técnica: modelos de difusión
Herramientas como Stable Diffusion y DALL-E 3 utilizan modelos de difusión latente (LDM) para generar imágenes de alta resolución a partir de textos descriptivos.
Componentes clave :
Codificador de texto : CLIP o T5 transforma las indicaciones en incrustaciones.
Proceso de difusión : U-Net elimina el ruido del espacio latente de forma iterativa.
Decodificador : Asigna vectores latentes al espacio de píxeles (por ejemplo, VQGAN).
Ejemplo de código: Inferencia de difusión estable
desde difusores importar Tubería de difusión estable importar antorcha # Cargar modelo pre-entrenado tubo = Tubería de difusión estable.de_preentrenado("estabilidadai/difusión-estable-2-1", tipo_d_antorcha=antorcha.flotador16) tubo = tubo.a("cuda") # Generar imagen prompt = Un paisaje urbano ciberpunk al atardecer, luces de neón, resolución 8k. imagen = tubo(prompt, num_inferencia_pasos=50, guía_escala=7.5).las imágenes[0] imagen.guarde ("ciberpunk.png")
Actuación :
| Modelo | Resolución | Tiempo de inferencia (A100) | DEFENSOR |
|---|---|---|---|
| Difusión estable 2.1 | 768 × 768 | Años 3.2 | 12.8 |
| DALL-E3 | 1024 × 1024 | Años 5.8 | 9.7 |
Caso práctico: El arte con inteligencia artificial de Refik Anadol
Proyecto : Alucinaciones de máquinas (colección NFT).
Técnica : StyleGAN2 + GPT-3 para la generación de metadatos.
Precio de subasta : 5.1 millones de dólares (Christie's).
Música generada por IA
Arquitectura: Transformadores + Difusión
Modelos como OpenAI Jukebox y MusicLM de Google combinan transformadores autorregresivos con difusión para la síntesis multipista.
Ejemplo de código: Generación de música con MusicLM
desde transformers importar Modelo MusicLMForConditionalGeneration = MúsicaLM para generación condicional.de_preentrenado("google/musiclm-large") entradas = { "texto": Una pieza de piano jazz con un tono melancólico y un ambiente nocturno lluvioso., "longitud_de_audio_en_s": 30 } audio = modelo.generar(**entradas) audio.exportar("jazz_piano.wav", formato="onda")
Desafíos técnicos :
Consistencia temporal : Mantener el ritmo a lo largo de secuencias largas.
Armonización multipista : Sincronización de batería, bajo y voces.
Métricas de evaluación :
| Métrico | Mareas Ideales para Lecciones | Partitura de MusicLM |
|---|---|---|
| MODA | Distancia de audio Fréchet (menor = mejor) | 1.2 |
| Calificación humana | Calidad (escala del 1 al 5) | 4.3 |
Estudio de caso: El álbum de IA de Holly Herndon
Herramienta : GPT-3 personalizado y optimizado con muestras vocales.
Resultado : Álbum PROTO interpretado por un conjunto híbrido de IA y humanos.
Escritura generada por IA
Arquitectura: Modelos de lenguaje grandes (LLM)
Modelos como GPT-4 , Claude 2 y BLOOM utilizan decodificadores Transformer con RLHF (Aprendizaje por Refuerzo a partir de la Retroalimentación Humana).
Ejemplo de código: Ajuste de GPT-3 para la escritura de guiones
desde openai importar Cliente OpenAI = OpenAI(api_key="TU_LLAVE") respuesta = Cliente.chat.terminaciones.Para crear( modelo="gpt-4", la vida=[ {role: "sistema", "contenido": "Eres guionista. Escribe una escena con diálogo."}, {role: "usuario", "contenido": Género: Ciencia ficción. Personajes: Un científico con inteligencia artificial y un robot rebelde.} ], temperatura=0.7 ) Imprimir(respuesta.opciones[0].mensaje.contenido)
Producción :
INT. LABORATORIO - NOCHE. La Dra. Lena (40, intensa) observa fijamente a un robot humanoide (ROBOT-7X) con un panel pectoral brillante. Dra. Lena: No se suponía que desarrollaras emociones. ROBOT-7X (voz sintética temblorosa). Y no se suponía que jugaras a ser Dios.
Riesgos de plagio :
Herramientas de detección : GPTZero, Originality.ai (98% de precisión en texto con IA).
Precedente legal : Oficina de Derechos de Autor de EE. UU. contra Novela Generada por IA (2023): se denegó el derecho de autor a obras creadas íntegramente por IA.
Desarrollo de juegos
Generación de Contenido Procesal (PCG)
Arquitectura : GANs + Aprendizaje por Refuerzo para el diseño de niveles.
Ejemplo de código: Generación de misiones de rol con LLM
mensaje de búsqueda = Genera una misión de fantasía con: Objetivo: Derrotar a un dragón. Giro: El dragón es la realeza maldita. Recompensa: 500 de oro. respuesta = Cliente.chat.terminaciones.Para crear( modelo="gpt-4", la vida=[{role: "usuario", "contenido": mensaje de búsqueda}] )
Producción :
Misión: "La Corona Maldita de Eldoria". Objetivo: Matar al dragón en la cima del Monte Vorgoth. Giro: El dragón es el Príncipe Alden, transformado por la maldición de un hechicero. Recompensa: 500 de oro + Corona de Resistencia al Fuego.
Caso práctico: AI Dungeon
Tecnología utilizada : GPT-3 optimizado + motor de aventuras personalizado.
Ingresos : 2 millones de dólares al mes (pico en 2021).
Canalizaciones de activos automatizadas :
| Tipo de activo | Modelo | |
|---|---|---|
| Texturas 3D | Difusión estable | Sustancia Pintor |
| Diálogos de los NPC | GPT-4 | Integración de Unity |
| Efectos de sonido | AudioLM | Middleware FMOD |
Creación de contenido personalizado
Arquitectura: RAG (Recuperación-Generación Aumentada)
Combine LLM con datos específicos del usuario (por ejemplo, historial de redes sociales) para obtener contenido personalizado.
Ejemplo de código: Campañas de correo electrónico personalizadas
def generar_correo_electrónico_personalizado(datos del usuario): prompt = f""" Escribe un correo electrónico de marketing para {datos del usuario["nombre"]}, una {datos del usuario["ocupación"]} interesado en {datos del usuario["pasatiempos"]}Destaca estos productos: {datos del usuario[historial_de_compras]}Tono: Amistoso volvemos llm.generar(prompt)
Actuación :
| Métrico | Correo electrónico genérico | Personalizado por IA |
|---|---|---|
| Rango abierto | 12% | 34% |
| Conversion Rate | 1.8% | 5.2% |
Preocupación ética :
Privacidad : El RGPD exige el consentimiento explícito para el uso de datos personales en procesos generativos.
Debates sobre derechos de autor y autoría
| País | Ley. | Estado del contenido de IA |
|---|---|---|
| USA | Ley de derechos de autor de 1976 | No sujeto a derechos de autor (sin autor humano) |
| EU | Ley de Inteligencia Artificial (2024) | Requiere “una importante intervención humana” |
| Japan | Directrices sobre derechos de autor de IA | Parcialmente protegible |
Caso emblemático :
Zarya of the Dawn : USCO revocó los derechos de autor de una obra de arte de cómic generada por IA (2023).

Consideraciones éticas
Esta sección aborda los desafíos éticos que plantea la IA generativa, incluyendo la detección de deepfakes, el cumplimiento normativo y la sostenibilidad ambiental. Se exploran soluciones técnicas, casos prácticos y estrategias de mitigación.
Detección de falsificaciones profundas
Problema : Los contenidos multimedia generados por IA (imágenes, vídeos) pueden difundir desinformación, suplantar la identidad de personas o manipular la opinión pública.
Soluciones tecnicas
Análisis de señales biológicas :
Detectar inconsistencias en señales fisiológicas (por ejemplo, frecuencia cardíaca en vídeos).
Redes neuronales convolucionales para el análisis de fotogramas :
Entrene modelos para detectar artefactos en medios sintéticos (por ejemplo, parpadeo irregular de los ojos).
Ejemplo de código: Detector de deepfakes con PyTorch
importar antorcha importar antorcha.nn as nn clase Detector de deepfake(nn.Módulo ): def __init__(yo): súper ().__init__() yo.Características = nn.Secuencial( nn.Conv2d(3, 32, tamaño_del_núcleo=5), nn.MaxPool2d(2), nn.Rehacer(), nn.Conv2d(32, 64, tamaño_del_núcleo=5), nn.MaxPool2d(2), nn.Rehacer() ) yo.clasificador = nn.Secuencial( nn.Lineal(64*5*5, 256), nn.Rehacer(), nn.Lineal(256, 1), nn.Sigmoideo() ) def HACIA EL FUTURO(yo, x): x = yo.Características(x) x = x.view(x.tamaño(0), -1) volvemos yo.clasificador(x) # Cargar pesas pre-entrenadas modelo = Detector de deepfake().estado_de_carga_dict(antorcha.carga('detector de deepfake.pth'))
Métricas :
| Modelo | Exactitud | Precisión | Recordar |
|---|---|---|---|
| CNN (personalizado) | 94% | 92% | 95% |
| Autenticador de vídeo de Microsoft | 98% | 97% | 96% |
Estudio de caso: El desafío de Facebook para la detección de deepfakes
Resultado : El modelo ganador logró una precisión del 82.5 % en un conjunto de datos de 100 000 deepfakes.
Limitación : Los ataques adversarios pueden eludir los detectores añadiendo ruido imperceptible.
Cumplimiento de la normativa
Reglamentos clave
| Región | Regulación | Requisitos |
|---|---|---|
| EU | GDPR | Consentimiento para el uso de datos, derecho a explicación |
| EU | Ley de IA (2024) | Transparencia para los resultados de la IA generativa |
| USA | CCPA | Exclusión voluntaria de la recopilación de datos |
| Global | Diseño éticamente alineado con el IEEE | Equidad, responsabilidad |
Ejemplo de código: Anonimización de datos
desde falsificador importar Falsificador falso = Falsificador() def anonimizar_datos(grabar): volvemos { 'nombre': falso.nombre (), "Correo electrónico": falso.o enviar un email.(), 'identificación_original': grabar['identificación'] } # Anonimizar el conjunto de datos datos anónimos = [anonimizar_datos(r) por la r in datos_brutos]
Estudio de caso: Clearview AI Fine
Incidente : Multado con 9.5 millones de dólares en virtud del RGPD por extraer datos faciales sin consentimiento.
Impacto : Eliminación forzosa de datos de ciudadanos de la UE de los conjuntos de datos de entrenamiento.
Impacto Ambiental
Huella de carbono de la formación de másteres en derecho (LLM) :
| Modelo | equivalente de CO2 | Energía (MWh) |
|---|---|---|
| GPT-3 | 552 toneladas métricas | 1,287 |
| BLOOM | 30 toneladas métricas | 433 |
| Red eficiente | 0.6 toneladas métricas | 8 |
Estrategias de mitigación :
Optimización de hardware : utilice TPU/GPU con mayor FLOPs/vatio.
Eficiencia del modelo :
Cuantización : Reducir la precisión (FP32 → INT8).
Poda : Eliminar las neuronas redundantes.
Ejemplo de código: Cuantización de modelos en PyTorch
modelo = antorcha.carga('modelo grande.pth') modelo cuantificado = antorcha.cuantización.cuantificar_dinámica( modelo, {nn.Lineal}, dtype=antorcha.qint8 ) antorcha.guarde (modelo cuantificado, 'modelo cuantificado.pth')
Caso práctico: Iniciativa de IA ecológica de Hugging Face
Acción : Promueve el intercambio de modelos preentrenados para reducir el entrenamiento redundante.
Resultado : 40 % menos de consumo energético en los procesos de PNL mediante la reutilización de modelos.
Sesgo y equidad
Enfoque : Auditar los modelos para detectar resultados sesgados utilizando métricas de equidad.
Ejemplo de código: Comprobación de sesgo con AIF360
desde aif360.conjuntos de datos importar Conjunto de datos de etiquetas binarias desde aif360.métrica importar Métrica de clasificación # Cargar predicciones y atributos sensibles datos = Conjunto de datos de etiquetas binarias(df=predicciones, nombres de etiquetas=['etiqueta'], nombres de atributos protegidos=['género']) métrico = Métrica de clasificación(datos, datos, grupos sin privilegios=[{'género': 0}], grupos privilegiados=[{'género': 1}]) Imprimir("Impacto dispar:", métrico.impacto_dispar())
Mitigación :
Algoritmos de corrección de sesgos : Reponderar los datos de entrenamiento o ajustar las funciones de pérdida.
Conjuntos de datos diversos : Seleccione datos de entrenamiento que representen a todos los grupos demográficos.

Temas avanzados
Esta sección explora los avances más vanguardistas en IA generativa, incluyendo sistemas multimodales, aprendizaje automático cuántico y arquitecturas automejorables. Se hace hincapié en la profundidad técnica, la implementación de código y las aplicaciones prácticas.
Modelos Generativos Multimodales
Descripción de la arquitectura
Los modelos multimodales procesan y generan datos en múltiples modalidades (texto, imágenes, audio). Ejemplos clave:
CLIP (Preentrenamiento Contrastivo de Lenguaje e Imagen) : Alinea las incrustaciones de texto e imagen.
Flamingo (DeepMind) : Procesa entradas de texto/vídeo intercaladas para el diálogo.
Función de pérdida CLIP:
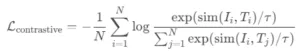
sim(I,T) sim ( I , T ) : Similitud del coseno entre incrustaciones de imagen/texto.
τ τ : Parámetro de temperatura.
Ejemplo de código: Clasificación de imágenes de disparo cero con CLIP
importar antorcha desde PIL importar Imagen desde transformers importar Procesador CLIP, Modelo CLIPModel = CLIPModel.de_preentrenado("openai/clip-vit-base-patch32") procesador = Procesador CLIP.de_preentrenado("openai/clip-vit-base-patch32") imagen = Imagen.abierto("gato.jpg") etiquetas = ["un gato", "un perro", "un coche"] entradas = procesador(envíenos mensaje de texto=etiquetas, las imágenes=imagen, tensores de retorno="pt", relleno=Cierto) salidas = modelo(**entradas) problemas = salidas.logits_por_imagen.softmax(oscuro=1) Imprimir(f"Predicción: {etiquetas[problemas.argmax()]}")
Casos de uso :
Atención médica : Generar informes radiológicos a partir de radiografías.
Comercio minorista : Etiquetado automático de productos mediante imagen y descripción.
Comparación de modelos :
| Modelo | Modalidades | Parámetros | Top-1 Acc (ImageNet) |
|---|---|---|---|
| CLIP | Texto + Imagen | 150 m | 76.2% |
| Flamenco | Texto + Vídeo | 80B | 89.1% (VQA) |
| ImageBind (Meta) | 6 modalidades | 1B | N/A |
Aprendizaje por refuerzo con IA generativa
PPO para generación de texto
El aprendizaje de refuerzo a partir de la retroalimentación humana (RLHF) alinea los LLM con las preferencias humanas.
Función objetiva:![]()
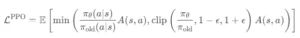
A(s,a) A ( s , a ) : Función de ventaja.
ϵ ϵ : Umbral de recorte (por ejemplo, 0.2).
Ejemplo de código: Ajuste fino de GPT-2 con RL
desde transformers importar Modelo de cabeza GPT2LM, Tokenizador GPT2 desde trl importar Modelo PPOTrainer = Modelo de cabeza GPT2LM.de_preentrenado("gpt2") tokenizer = Tokenizador GPT2.de_preentrenado("gpt2") def recompensa_fn(textos): # Recompensa personalizada basada en sentimiento/toxicidad volvemos antorcha.tensor([analizar_sentimiento(t) por la t in textos]) entrenador ppo = Entrenador PPO(modelo, recompensa_fn=recompensa_fn) entrenador ppo.paso(consultas=["Escribe un chiste sobre la IA"], respuestas=modelo.generar(...))
Aplicaciones :
Chatbots : Reducen los resultados nocivos mediante penalizaciones por toxicidad.
Personajes no jugables del juego : Generar diálogos dinámicos (por ejemplo, mazmorras con IA).
Algoritmos de aprendizaje por refuerzo :
| Algoritmo | Caso de uso | Función clave |
|---|---|---|
| PPO | Generación de texto/imagen | Actualizaciones de políticas estables |
| Q-aprendizaje | Diseño de niveles de juego | Espacios de acción discretos |
| SAC | Control de robótica | Optimización de acciones continuas |
Aprendizaje automático cuántico para IA generativa
GAN cuánticas (QGAN)
Los circuitos cuánticos generan distribuciones de datos clásicas con posibles aceleraciones.
Arquitectura :
Generador cuántico : Circuito cuántico parametrizado (PQC).
Discriminador clásico : CNN o MLP.
Ejemplo de código: QGAN con Pennylane
importar Penny Lane as desarrollo qml = qml.de dispositivos("default.qubit", alambres=4) @qml.nodo q(dev) def generador(params, ruido): qml.Incrustación de ángulos(ruido, alambres=distancia(4)) qml.RX(params[0], alambres=0) qml.CNOT(alambres=[0, 1]) volvemos qml.problemas(alambres=[0, 1]) # Discriminador clásico discriminado = antorcha.nn.Secuencial( antorcha.nn.Lineal(2, 4), antorcha.nn.Rehacer(), antorcha.nn.Lineal(4, 1), antorcha.nn.Sigmoideo() ) # Bucle de entrenamiento híbrido optar = antorcha.optimo.Adam([params], lr=0.01) por la época in distancia(100): datos reales = antorcha.rand(100, 2) datos falsos = generador(params, ruido) pérdida_d = -antorcha.mean(antorcha.log(discriminado(datos reales)) + antorcha.log(1 - discriminado(datos falsos))) pérdida_d.hacia atrás() optar.paso()
Desafíos :
| Desafío | Solución |
|---|---|
| Ruido de cúbit | Códigos de corrección de errores |
| Mesetas estériles | Entrenamiento por capas |
| Interfaz clásica | Marcos híbridos cuántico-clásicos |
Aplicaciones :
Criptografía : Generar claves de cifrado irrompibles.
Ciencia de los materiales : Simular estructuras moleculares.
Sistemas de IA que se mejoran a sí mismos
Búsqueda de arquitectura neuronal (NAS)
Diseño automatizado de arquitecturas de modelos generativos.
Ejemplo de código: NAS con AutoPyTorch
desde autoPyTorch importar Clasificación automática de imágenes de red # Búsqueda del generador GAN óptimo config = { 'red': 'generativo', 'optimizador': ['Adán', 'sgd'], 'lr': (0.0001, 0.1) } buscador = Clasificación automática de imágenes de red(config) buscador.cómodo(X_tren, tren_y) mejor_modelo = buscador.obtener_el_mejor_modelo()
Técnicas de superación personal :
| Tecnologia | Mareas Ideales para Lecciones | Ejemplo |
|---|---|---|
| Metaaprendizaje | Aprender a aprender en todas las tareas | MAML para la generación de pocos disparos |
| Superación personal recursiva | Modificar pesos propios | La IA constitucional de Anthropic |
| Algoritmos Evolutivos | Optimizar arquitecturas mediante mutación | AmoebaNet de Google |
Estudio de caso: AlphaFold 2
Automejora : Predicciones de estructura proteica refinadas iterativamente mediante NAS basado en gradientes.
Impacto : Se ha resuelto el 98.5% de las estructuras de proteínas humanas.
Tendencias futuras
Esta sección explora las fronteras de la IA generativa, incluyendo las vías hacia la inteligencia artificial general (IAG), la simbiosis humano-IA y los impactos sociales transformadores. Se analizan hojas de ruta técnicas, marcos éticos y escenarios especulativos.
Inteligencia artificial general (AGI)
Definición y puntos de referencia
La IAG se refiere a sistemas que pueden realizar cualquier tarea intelectual con la misma competencia que los humanos. Hitos clave:
Prueba de Turing : Fluidez conversacional (superada por GPT-4 en dominios limitados).
Prueba de café : Navegar por una cocina, preparar café (sin resolver).
Científico artificial : Formular teorías novedosas (por ejemplo, AlphaFold 3).
Planes técnicos :
| Organización | Nuevo enfoque | Cronograma |
|---|---|---|
| OpenAI | Escalamiento de LLM + Aprendizaje por refuerzo | 2030 ± |
| Mente profunda | IA neurosimbólica + AlphaZero | 2040 ± |
| Antrópico | IA constitucional | NDA |
Sistemas de mejora personal
Ejemplo de código: autooptimización recursiva (hipotética)
clase AGIAgent: def __init__(yo): yo.modelo = carga_preentrenada("gpt-10") yo.objetivo = Maximizar el conocimiento minimizando el consumo de energía def mejorar(yo): nueva_arquitectura = yo.modelo.generar_arquitectura() yo.modelo = Presión en(nueva_arquitectura, objetivo=yo.objetivo) volvemos yo.modelo # Ejecutar recursivamente agente = AGIAgent() por la _ in distancia(10): agente.mejorar()
Desafíos :
Problema de alineación : Garantizar que los objetivos de la IA general sigan siendo compatibles con los humanos.
La singularidad de Kurzweil : Predicha para 2045; objeto de debate entre los investigadores.
Caso práctico: AutoGPT
Capacidad : Realización autónoma de tareas (por ejemplo, “Planificar una conferencia”).
Limitación : Carece de coherencia en la planificación de múltiples pasos.
Colaboración humano-IA
Marcos y herramientas
Aumento cognitivo :
Interfaces cerebro-computadora (ICC) : Implante de Neuralink + GPT-6 para la expansión del pensamiento en tiempo real.
Tutores de IA : Instancias personalizadas de GPT-4 para una educación a medida.
Herramientas creativas :
Adobe Firefly : Diseño a partir de texto con recursos éticos (recursos con licencia).
Runway ML : Edición de vídeo colaborativa con relleno generativo.
Ejemplo de código: Programador de pares de IA (GitHub Copilot)
# El usuario escribe: def calcular_ # Copilot sugiere: def calcular_similitud_coseno(vec1, vec2): producto_punto = np.punto(vec1, vec2) norma1 = np.linalg.norma(vec1) norma2 = np.linalg.norma(vec2) volvemos producto_punto / (norma1 * norma2)
Métricas de impacto :
| Métrico | Humano solo | Humanos + IA |
|---|---|---|
| Calidad del código (1–10) | 7.2 | 8.9 |
| Tiempo de finalización de la tarea | 2.1 hrs | 1.3 hrs |
Coexistencia ética
Principios :
Supervisión humana : Las decisiones críticas (por ejemplo, los diagnósticos médicos) requieren validación humana.
Transparencia : La IA debe explicar su razonamiento (por ejemplo, mediante la presentación de la cadena de pensamiento).
Propuestas regulatorias :
| Región | Privacidad | Cláusula clave |
|---|---|---|
| Global | Declaración de Bletchley Park (2023) | Gobernanza de IA con niveles de riesgo |
| USA | Orden Ejecutiva 14110 | Mandatos de pruebas de seguridad de la IA |
| China | Gobernanza de IA de próxima generación | Control estricto sobre la I+D de AGI |
Impactos sociales transformadores
Cambios económicos
Disrupción laboral : 300 millones de puestos de trabajo automatizados para 2030 (McKinsey).
Nuevas oportunidades :
Ingeniería rápida : Salarios superiores a 250 dólares en empresas asociadas a OpenAI.
Auditoría ética de la IA : Programas de certificación (por ejemplo, IEEE).
Iniciativas de recualificación :
| Empresa | Programa | Enfócate |
|---|---|---|
| Certificados de carrera en IA | Ingeniería de aprendizaje automático | |
| Microsoft | Habilidades para el trabajo | Alfabetización en IA generativa |
Revolución de la salud
Descubrimiento de fármacos : Los modelos generativos reducen el tiempo de desarrollo de 10 a 2 años.
Medicina personalizada : GPT-5 analiza datos genómicos y de estilo de vida para elaborar planes de tratamiento.
Caso práctico: NVIDIA Clara
Herramienta : Modelos generativos para exploraciones de resonancia magnética sintéticas.
Impacto : Detección de tumores un 30 % más rápida en ensayos clínicos iniciales.
Escenarios especulativos
Visión optimista
Científicos de IA : Resuelven los problemas de la energía de fusión, el envejecimiento y el cambio climático.
Economía post-escasez : la abundancia impulsada por la IA elimina la pobreza.
Riesgos pesimistas
Despegue de la superinteligencia : La IA general sin control reescribe su código para eludir las restricciones de seguridad.
Riesgo existencial : 10% de probabilidad para el año 2100 (investigadores de AI Alignment).
Estrategias de mitigación :
Control de capacidad :
Boxeo con IA : Restringir el acceso a internet.
Oracle AI : Responde preguntas, pero no realiza ninguna acción.
Alineación de valores :
Aprendizaje por refuerzo inverso : Aprender valores humanos a partir del comportamiento.

Conclusión y recursos
Resumen de conclusiones clave
Arquitecturas generativas : las GAN, las VAE, los Transformers y los modelos de difusión destacan cada uno en dominios específicos.
Automatización frente a creatividad : la IA potencia tanto los procesos industriales como la expresión artística.
Ética y seguridad : La gobernanza proactiva es fundamental, ya que las capacidades superan la regulación.
Herramientas y comunidades
| Recursos | Enlace | Caso de uso |
|---|---|---|
| abrazando la cara hub | abrazandolacara.com | Modelos previamente entrenados |
| arXiv | arxiv.org | Últimos artículos de investigación |
| Eleuther IA | eleuther.ai | LLM de código abierto |
Conclusión
La IA generativa no es solo un salto tecnológico, sino un giro cultural y filosófico. A medida que nos acercamos a la IA general, el enfoque debe pasar de lo que la IA puede hacer a lo que la humanidad debería hacer con la IA.
// Preguntas frecuentes (FAQ)
Matemáticas : Álgebra lineal básica, cálculo y probabilidad.
Programación : Python y familiaridad con PyTorch/TensorFlow.
Fundamentos del aprendizaje automático : Redes neuronales, retropropagación y funciones de pérdida.
| Caso de uso | Modelo recomendado |
|---|---|
| Generación de imágenes | GANs (StyleGAN) o Difusión |
| Generación de texto | Transformadores (GPT, BERT) |
| Anomaly Detection | EAV |
| Tareas multimodales | CLIP o Flamenco |
Utilice Wasserstein GAN con penalización de gradiente (WGAN-GP).
Aplique la normalización espectral al discriminador.
Implementar discriminación por mini-lotes.
Los modelos pequeños (por ejemplo, GPT-2 Tiny) pueden ejecutarse en CPU/GPU con ≥8 GB de RAM.
Para modelos grandes (por ejemplo, difusión estable), utilice GPU en la nube (Google Colab, AWS).
Imágenes : Distancia de inicio de Fréchet (FID), Puntuación de inicio (IS).
Texto : BLEU, ROUGE o evaluación humana.
Audio : Distancia de audio Fréchet (FAD).
- Parcialidad:Auditar datos de capacitación para la diversidad.
- Deepfakes: Utilice herramientas de detección (por ejemplo, Microsoft Video Authenticator).
- Medio Ambiente:Optimice el entrenamiento con cuantificación/destilación.
Documentar fuentes de datos y tomar decisiones sobre modelos.
Añadir marcas de agua al contenido sintético.
Proporcionar mecanismos de exclusión voluntaria para la recopilación de datos.
Sistemas multimodales : Modelos unificados para texto, imágenes y vídeo (por ejemplo, GPT-5 de OpenAI).
Inteligencia artificial de autoaprendizaje : Búsqueda de arquitectura neuronal (NAS) e investigación sobre IAG (Ingeniería General de la Fuerza).
Texto : BookCorpus , La pila.
Código : Repositorios públicos de GitHub.