
Introducción: Google ha anunciado su último modelo de vanguardia, el Gemini 4 Argon. Diseñado para soportar largas cadenas de razonamiento en tareas de varios pasos, el modelo Gemini 4 Argon representa un cambio importante en la forma en que operan las aplicaciones de ingeniería interna y las aplicaciones empresariales externas. Desde proyectos de codificación complejos hasta la defensa mediante IA en ciberseguridad, el modelo se centra en resolver problemas del mundo real que requieren una lógica profunda y una retención de contexto a largo plazo. Si bien Google continúa ampliando su catálogo de modelos de IA, el lanzamiento de Gemini 4 Argon se produce en un momento de gran competencia. Muchos desarrolladores están evaluando herramientas alternativas y opciones de código abierto que ofrecen menores costos operativos. Este artículo examina las características principales de Gemini 4 Argon, revisa sus puntuaciones en las pruebas de rendimiento de IA y lo compara con otros sistemas líderes en el mercado. ¿Qué es Gemini 4 Argon y cómo funciona? Gemini 4 Argon es un modelo de IA de vanguardia diseñado para el razonamiento profundo y las tareas a largo plazo. A diferencia de los modelos conversacionales estándar, maneja ingeniería de software compleja, análisis de documentos legales y correcciones de seguridad automatizadas. Actualmente, Google utiliza internamente Gemini 4 Argon para optimizar los flujos de trabajo de computación cuántica, reducir la sobrecarga de memoria en los centros de datos y migrar bases de código C++ heredadas a Rust, un lenguaje seguro. Dado que ofrecer capacidades tecnológicas de este nivel de innovación requiere la máxima precaución, Google está adoptando un enfoque gradual y seguro para su implementación. Está participando activamente en los EE. UU. El proceso voluntario de prelanzamiento del gobierno, al tiempo que se amplía gradualmente la disponibilidad. Google ya ha puesto el modelo a disposición de un grupo selecto de expertos en ciberseguridad de confianza a través de su programa Fairwind para la ciberdefensa. Google sigue recopilando comentarios y evaluaciones de los primeros innovadores y probadores para perfeccionar las medidas de seguridad antes de presentar Argon a desarrolladores, empresas y consumidores lo antes posible. Para obtener más detalles, lea el anuncio oficial directamente en el blog de Google. Capacidades de defensa de ciberseguridad mediante IA Un aspecto fundamental durante el desarrollo de Gemini 4 Argon fue la defensa de ciberseguridad mediante IA. El modelo puede buscar de forma autónoma vulnerabilidades de software, verificar posibles exploits y aplicar parches de seguridad. Para los equipos de seguridad de confianza y los ingenieros internos de Google, el modelo se proporciona sin las medidas de seguridad cibernéticas estándar para permitir pruebas defensivas completas. La empresa de seguridad Wiz integró Gemini 4 Argon en su iniciativa Scan for Good para proteger la infraestructura digital pública. Durante las primeras pruebas, el modelo identificó una vulnerabilidad crítica en el software global de atención médica que exponía los datos de los pacientes, un fallo de seguridad que las herramientas de vanguardia anteriores no habían detectado. En evaluaciones formales como CWE-bench v1, el modelo empató en el primer lugar con una puntuación del 68% en la corrección de vulnerabilidades. Puntos fuertes clave del modelo Migración profunda de código (C++ a Rust) Ciberseguridad Defensa de IA y parcheo automatizado Capacidad de token de salida extendida (hasta 1 millón de tokens) Alta relación costo-inteligencia Puntuaciones de referencia de IA y análisis de rendimiento Google publicó un conjunto detallado de puntuaciones de referencia de IA que comparan Gemini 4 Argon con los principales competidores, incluidos GPT-6 Astra, Claude Fable 5.1 y Claude Opus 5.8. Si bien estas puntuaciones de referencia de IA publicadas muestran un rendimiento sólido, los revisores independientes han señalado algunas limitaciones en pruebas específicas. Por ejemplo, una revisión realizada por Epoch AI evaluó el benchmark de codificación DeepSWE v1.1 y lo calificó como defectuoso debido a errores en el sistema de calificación. En más del 20% de las tareas muestreadas, las modificaciones válidas del código realizadas por los modelos provocaron fallos en el ejecutor de pruebas automatizado, lo que dio lugar a falsos negativos. Índice de Inteligencia vs. Los datos de eficiencia de costes obtenidos mediante análisis de inteligencia artificial sitúan a Gemini 4 Argon en una posición favorable en lo que respecta a la inteligencia frente al coste operativo. Fuente: Puntuaciones de referencia de IA: Inteligencia vs. Costo En la escala del índice de inteligencia, Gemini 4 Argon obtiene una puntuación superior a 52 puntos con un costo estimado de $2.00 por tarea estándar. Si bien modelos como el Claude Opus 5.5 alcanzan índices de inteligencia ligeramente superiores, sus costes por tarea oscilan entre 5.00 y 8.00 dólares. Esto convierte a Gemini 4 Argon en una opción económica para las empresas que requieren un razonamiento sólido sin costes excesivos. El razonamiento sostenido es fundamental para los sistemas autónomos que toman decisiones de ejecución complejas. Para comprender cómo los motores subyacentes permiten tomar este tipo de decisiones, lea nuestro análisis sobre JEV y la arquitectura que hay detrás de la IA de toma de decisiones. Estructura de precios Google ha establecido dos niveles de precios para el uso de la API: Precios de introducción Tokens de entrada: $2.00 por 1M tokens Tokens de salida: $10.00 por 1M tokens Tokens de entrada en caché: $0.10 por 1M tokens (95% de descuento) Precios estándar (período posterior a la introducción) Tokens de entrada: $4.00 por 1M tokens Tokens de salida: $20.00 por 1M tokens Comparación de precios entre competidores del mercado Los datos de Artificial Analysis evalúan los costos del modelo junto con las calificaciones de capacidad. La siguiente tabla describe las tarifas estándar de API y los costos estimados de las tareas en los principales proveedores: Proveedor del modelo Costo de entrada (por 1M de tokens) Costo de salida (por 1M de tokens) Costo estimado por tarea (análisis artificial) Gemini 4 Argon Google $2.00 (Introducción) / $4.00 (Estándar) $10.00 (Introducción) / $20.00 (Estándar) ~$2.00 GPT-6.1 Sol (máx.) OpenAI $1.25 $5.00 ~$1.50 GPT-6 Astra (máx.) OpenAI $2.50 $10.00 ~$3.20 Claude Sonnet 5.5 Anthropic $3.00 $15.00 ~$5.20 Claude Opus 5.5 Anthropic $5.00 $25.00 ~$7.80 Gemini 3.8 Flash Google $0.50 $1.50 Tarifas introductorias de ~$0.90 para Argon: Los tokens de entrada cuestan $2.00 por millón, los tokens de salida cuestan $10.00 por millón y los tokens de entrada en caché reciben un descuento del 95% a $0.10 por millón. Precios estándar: Una vez finalizado el período introductorio, se aplicará un precio de 4 dólares por cada millón de tokens de entrada y de 20 dólares por cada millón de tokens de salida. Si bien Gemini 4 Argon ofrece un rendimiento de primer nivel, es fundamental evaluar su posición frente a las alternativas del mercado. Para un análisis más detallado de las capacidades de la competencia, consulte nuestra guía detallada sobre la última versión del modelo GPT-6.1 de OpenAI. Integración de modelos de vanguardia en la producción: Implementar modelos potentes como Gemini 4 Argon en flujos de trabajo empresariales reales requiere más que solo acceso a la API. Para gestionar de forma segura cadenas de decisiones complejas, las aplicaciones empresariales suelen basarse en arquitecturas estructuradas de agentes de IA combinadas con la supervisión humana. Esta combinación garantiza una alta precisión operativa, previene errores automatizados en tareas críticas y mantiene el cumplimiento normativo en operaciones sensibles. Comparativa de los modelos de IA de Google: ¿Qué herramienta elegir? La selección del modelo adecuado dentro del conjunto de modelos de IA de Google depende de las necesidades específicas del flujo de trabajo, la velocidad de ejecución y la profundidad de razonamiento: Comparación del ecosistema de modelos de Google Gemini 4 Argon: Razonamiento profundo, límite de salida de 1M Gemini 3.8 Flash: Herramienta estable para codificación e informes Gemini 3.1 Pro: Vista previa pública para razonamiento complejo Gemini 3.5 Flash-Lite: Clasificación de alta velocidad y extracción de campos Ampliado
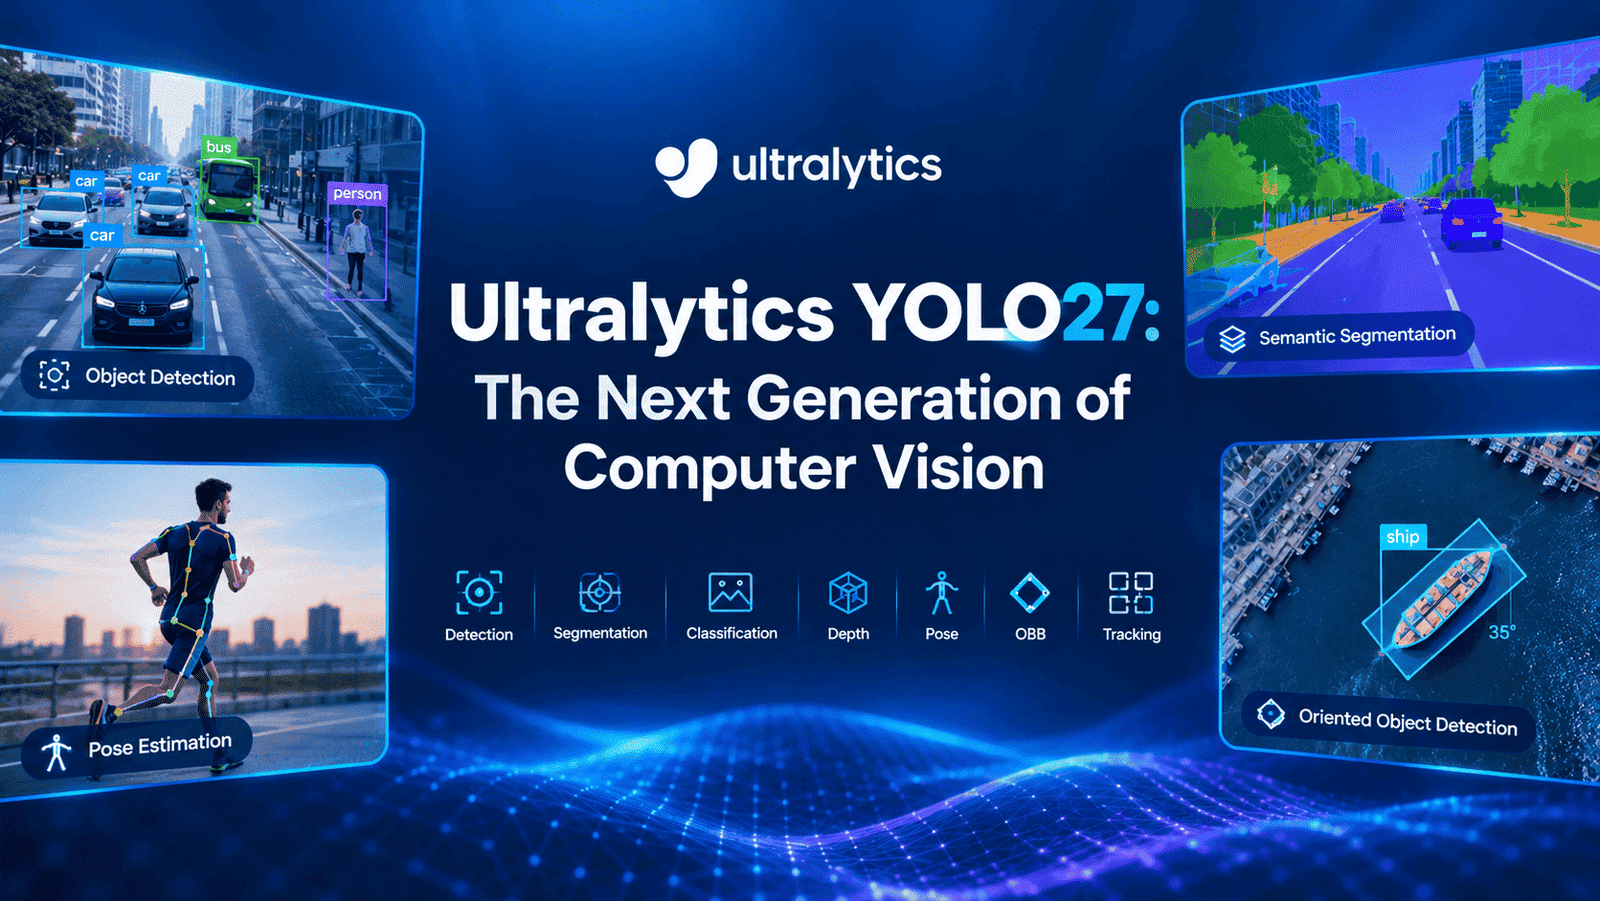
Introducción. La visión artificial en tiempo real está evolucionando rápidamente. Desde vehículos autónomos y drones hasta robótica, inspección industrial, cámaras inteligentes e imágenes médicas, los sistemas de IA necesitan cada vez más comprender la información visual con alta precisión y una latencia extremadamente baja. La familia YOLO ha desempeñado un papel fundamental en esta evolución. Tras años de mejoras en velocidad, precisión y despliegue, Ultralytics está preparando su familia de modelos de próxima generación: YOLO27. YOLO27 está diseñado para continuar con la filosofía de YOLO de visión artificial rápida y práctica, al tiempo que introduce nuevas ideas arquitectónicas. La próxima familia combina una arquitectura CNN optimizada para sus modelos más pequeños con una arquitectura de detección basada en consultas y sin NMS para sus modelos más grandes. Según la documentación oficial de Ultralytics, YOLO27 se encuentra actualmente en la fase final de investigación y desarrollo. Se prevé que los modelos se lancen a finales de 2026, pero aún no se ha anunciado ninguna fecha de lanzamiento oficial. Los pesos, las configuraciones y el código de implementación no están disponibles públicamente, y las características actuales y los resultados de las pruebas de rendimiento pueden cambiar antes del lanzamiento. Para los desarrolladores interesados en la evolución de YOLO, nuestro artículo sobre YOLO26: La próxima evolución de la visión artificial en tiempo real proporciona información útil sobre la generación anterior y el movimiento de la industria hacia modelos de visión integrales y listos para su implementación. ¿Qué es Ultralytics YOLO27? Ultralytics YOLO27 es una próxima familia de modelos de visión artificial en tiempo real diseñados para una amplia gama de tareas de visión. La familia incluye cuatro tamaños de modelo planificados: YOLO27n – Nano YOLO27s – Pequeño YOLO27m – Mediano YOLO27l – Grande Los modelos están planificados para admitir: Detección de objetos Segmentación de instancias Segmentación semántica Estimación de profundidad Clasificación de imágenes Estimación de pose Detección de objetos orientados Seguimiento de múltiples objetos para los modelos compatibles Uno de los aspectos más interesantes de YOLO27 es que sus modelos de detección utilizan dos enfoques arquitectónicos diferentes. YOLO27n y YOLO27s utilizan un diseño simplificado basado en CNN optimizado para una inferencia eficiente, mientras que YOLO27m y YOLO27l utilizan una arquitectura basada en consultas que puede generar detecciones sin la supresión no máxima (NMS) tradicional. Esto convierte al YOLO27 en algo más que una simple actualización de tamaño del modelo; es más bien una evolución arquitectónica de la familia YOLO. YOLO27 y la evolución de los modelos YOLO La arquitectura YOLO ha evolucionado significativamente desde su introducción. Las generaciones anteriores se centraron principalmente en lograr una detección de objetos más rápida y precisa. Los modelos posteriores introdujeron mejoras en la extracción de características, el entrenamiento, la eficiencia del modelo y la implementación. Los desarrolladores que deseen comprender la evolución práctica de YOLO también pueden consultar nuestra guía sobre cómo usar YOLOv11 para la detección de objetos. YOLO27 continúa esta progresión abordando varios desafíos que siguen siendo importantes en la visión artificial moderna: detección de objetos pequeños, latencia de inferencia, sobrecarga de posprocesamiento, complejidad de la implementación, precisión frente al tamaño del modelo e inferencia eficiente en el borde. El resultado es una familia de modelos diseñada en torno a diferentes requisitos de implementación en lugar de una única arquitectura optimizada para cada situación. YOLO27 contra. YOLO26 YOLO27 se posiciona como el sucesor de YOLO26. Sin embargo, la diferencia clave no radica simplemente en que YOLO27 sea más grande o más preciso. La nueva generación introduce diferentes estrategias arquitectónicas para diferentes tamaños de modelos. YOLO27n y YOLO27s Los modelos más pequeños se centran en: Arquitectura CNN eficiente Detección de doble escala Detección de objetos pequeños Menor cálculo del cabezal de detección Implementación en el borde Vídeo en tiempo real YOLO27m y YOLO27l Los modelos más grandes se centran en: Detección basada en consultas Decodificación Transformer Inferencia sin NMS Implementación de GPU de alta precisión Contexto visual global La documentación oficial recomienda actualmente seguir utilizando YOLO26 para proyectos de producción hasta que se lance YOLO27. Para obtener información detallada sobre la generación anterior, consulte nuestra guía completa sobre YOLO26: La próxima evolución de la visión artificial en tiempo real. Las dos arquitecturas de detección de YOLO27 Una de las mayores innovaciones de YOLO27 es que los cuatro modelos de detección no utilizan la misma arquitectura de detección. Ultralytics los ha dividido en dos grupos. YOLO27n y YOLO27s: Arquitectura CNN optimizada. YOLO27n y YOLO27s están diseñados para aplicaciones donde la velocidad de inferencia y la eficiencia computacional son fundamentales. Los detectores de objetos tradicionales suelen predecir objetos utilizando tres mapas de características: características de resolución fina, características de resolución media y características de resolución gruesa. YOLO27n y YOLO27s eliminan la escala de predicción media. En cambio, utilizan: Un mapa de características finas para objetos pequeños Un mapa de características gruesas para objetos grandes Eliminar el mapa de predicción medio reduce una parte significativa del cálculo del cabezal de detección al tiempo que conserva las escalas de características consideradas más importantes para objetos pequeños y grandes. Este diseño hace que los modelos más pequeños sean particularmente interesantes para: IA de borde Drones Robótica Cámaras inteligentes Vídeo en tiempo real Sistemas embebidos Detección de objetos pequeños En YOLO27 La detección de objetos pequeños sigue siendo uno de los desafíos más difíciles en la visión por computadora. Los objetos que ocupan solo un pequeño número de píxeles contienen menos información visual, lo que dificulta su clasificación y localización. Esto es especialmente importante en: Imágenes de drones Monitoreo de tráfico Imágenes satelitales Vigilancia Vehículos autónomos Análisis de video de áreas grandes Nuestra guía detallada sobre Detección de objetos pequeños en visión artificial: desafíos, técnicas y tendencias futuras explora por qué los objetivos pequeños son difíciles de detectar y las técnicas utilizadas para mejorar su reconocimiento. YOLO27n y YOLO27s abordan este desafío ampliando una etapa inicial de características de alta resolución para que la red pueda retener información más detallada. En combinación con el mapa de predicción de alta resolución restante, esto tiene como objetivo mejorar la localización y la regresión de objetos pequeños. YOLO27n y YOLO27s también introducen la supervisión de alineación del primer plano. Durante el entrenamiento, una rama auxiliar ligera aprende a separar los objetos en primer plano de las regiones de fondo. Esto cierra la brecha entre la supervisión intensiva del entrenamiento y el cabezal de predicción final uno a uno. Según Ultralytics, la diferencia de precisión se reduce de aproximadamente: 0.9 mAP a 0.4 mAP para YOLO26n → YOLO27n 0.8 mAP a 0.4 mAP para YOLO26s → YOLO27s La rama adicional se utiliza solo durante el entrenamiento y se elimina durante la inferencia y la exportación, lo que significa que no agrega cálculos en el tiempo de implementación. YOLO27m y YOLO27l: Detección sin NMS. Los modelos YOLO27 de mayor tamaño adoptan un enfoque diferente. En lugar de generar muchas predicciones superpuestas y filtrarlas mediante la supresión no máxima, YOLO27m y YOLO27l utilizan un decodificador transformador basado en consultas. El decodificador trabaja con un conjunto fijo de consultas de objetos y las refina progresivamente para producir las detecciones finales. Esto significa que las predicciones finales se pueden generar directamente sin el posprocesamiento NMS tradicional. ¿Por qué es importante la detección sin NMS? Los sistemas tradicionales de detección de objetos suelen generar múltiples cuadros candidatos para un mismo objeto. El sistema NMS se encarga entonces de eliminar las predicciones redundantes. Aunque NMS funciona bien,
Introducción: OpenAI ha anunciado una interesante actualización para desarrolladores de IA y equipos empresariales. La versión oficial de GPT 6.1 ofrece importantes mejoras de rendimiento a una fracción del coste anterior. Con este nuevo modelo de OpenAI, los usuarios obtienen inteligencia de alto nivel sin pagar precios elevados. El nuevo sistema ChatGPT Sol 6.1 está diseñado para gestionar sin problemas la codificación compleja, el análisis de documentos y los flujos de trabajo automatizados, manteniendo bajos los costes computacionales. ¿Qué es ChatGPT-6.1 Sol y por qué es importante? GPT-6.1 Sol está diseñado para organizaciones que necesitan ejecutar cargas de trabajo de IA sofisticadas de forma repetida. En lugar de utilizar el modelo más potente para cada tarea, las empresas pueden usar Sol para flujos de trabajo que requieren un razonamiento sustancial, codificación, uso de herramientas o interacción con la computadora, manteniendo al mismo tiempo los costos operativos más bajos. OpenAI describe a GPT-6.1 Sol como un sistema que ofrece un rendimiento similar al de Astra para tareas complejas a un menor coste. Entre los principales beneficios se incluyen: Codificación compleja: Útil para el desarrollo de software, la depuración, la refactorización y las tareas de ingeniería de varios pasos. Uso del ordenador: Puede interactuar con entornos informáticos y aplicaciones web compatibles. Agentes de IA: Adecuados para flujos de trabajo que requieren múltiples herramientas y acciones. Procesamiento de contexto extenso: Admite hasta 1.05 millones de tokens de contexto. Costes de API más bajos: El precio estándar es de 2 dólares por millón de tokens de entrada y de 10 dólares por millón de tokens de salida. Razonamiento avanzado: Admite niveles de esfuerzo de razonamiento bajo, medio, alto, extra alto y máximo. Automatización empresarial: Puede gestionar flujos de trabajo profesionales con gran cantidad de documentos y múltiples pasos. Flujos de trabajo multiagente: GPT-6.1 Sol también admite capacidades multiagente en versión beta. Lea también: Lista de verificación de implementación de agentes de IA para industrias reguladas GPT-6.1 Sol vs GPT-6 Astra vs GPT-6 Luna Uno de los cambios más importantes en la familia GPT-6 es que OpenAI ahora proporciona diferentes modelos para diferentes requisitos de carga de trabajo. GPT-6 Astra se posiciona como el modelo más capaz para el razonamiento exigente y el trabajo profesional. GPT-6.1 Sol está diseñado para trabajos complejos en los que las organizaciones también necesitan gestionar los costes. GPT-6 Luna está optimizado para cargas de trabajo de alto volumen y sensibles al coste. Característica GPT-6 Astra GPT-6.1 Sol GPT-6 Luna Enfoque principal Inteligencia máxima Trabajo complejo + eficiencia de costos Eficiencia de alto volumen Entrada / 1M tokens $10 $2 $0.10 Salida / 1M tokens $50 $10 $0.50 Ventana de contexto 1.05M 1.05M 1.05M Salida máxima 128K 128K 128K Codificación compleja Excelente Excelente Bueno Uso de computadora Sí Sí Sí Búsqueda web Sí Sí Sí Búsqueda de archivos Sí Sí Sí Más adecuado para Tareas profesionales y de razonamiento más difíciles Flujos de trabajo recurrentes complejos Automatización de alto volumen Los precios y las capacidades se basan en la documentación del modelo actual de OpenAI. La diferencia de precios es particularmente significativa. El precio de entrada estándar de GPT-6.1 Sol es una quinta parte del de GPT-6 Astra, mientras que su precio de salida también es una quinta parte. El coste de entrada en caché es de 0.10 dólares por millón de tokens, en comparación con 1.00 dólar para Astra. Esto hace que Sol sea particularmente interesante para aplicaciones que ejecutan miles o millones de interacciones de modelos. Lea también: Análisis de GPT 5.6 de OpenAI: ¿Qué hace diferente a esta nueva generación? Desglose del rendimiento, la velocidad y el coste de las tareas Para comprender el valor de la versión GPT 6.1, es necesario analizar tanto el precio estándar de los tokens como los costes reales de ejecución de las tareas. Según la documentación oficial de OpenAI, ChatGPT Sol 6.1 establece sus tarifas estándar de API en 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida, con un descuento para las entradas almacenadas en caché de tan solo 0.10 dólares por millón de tokens. Sin embargo, la evaluación independiente realizada por Artificial Analysis desglosa cómo estos costos y velocidades de salida escalan en las 5 configuraciones de esfuerzo de razonamiento del modelo: Velocidad de salida y latencia: La configuración más rápida para ChatGPT Sol 6.1 es el nivel de esfuerzo de razonamiento máximo, que entrega 64 tokens por segundo (t/s). El esfuerzo alto alcanza las 58 t/s, el esfuerzo bajo llega a las 54 t/s, mientras que el esfuerzo extra alto y el esfuerzo medio operan a 53 t/s. Para necesidades de respuesta rápida, el nivel de bajo esfuerzo proporciona la latencia más baja, generando el primer token en tan solo 3.11 segundos. Coste por tarea (índice de análisis artificial): En función de la intensidad del razonamiento, los gastos por tarea aumentan hasta 5.5 veces. El modo de bajo esfuerzo es el más económico, con un coste de 0.13 dólares por tarea; este aumenta a 0.21 dólares para el modo medio, 0.32 dólares para el modo alto, 0.39 dólares para el modo extra alto y alcanza un máximo de 0.72 dólares por tarea para el modo de máximo esfuerzo. En comparación con GPT-6 Astra, estos niveles de rendimiento ofrecen a los desarrolladores un control detallado sobre la velocidad de ejecución y el gasto operativo exacto por flujo de trabajo del agente. Índice de Inteligencia de Análisis Artificial vs. Coste por tarea, que muestra el posicionamiento de ChatGPT Sol 6.1 en el cuadrante más atractivo en comparación con GPT-6 Astra. Fuente: ChatGPT Sol 6.1 tabla comparativa de inteligencia vs coste por Artificial Analysis GPT-6.1 Sol vs el GPT-6 Sol original GPT-6.1 Sol también es una evolución del modelo GPT-6 Sol anterior. Los precios estándar de entrada y salida se mantienen en 2 y 10 dólares por millón de tokens, respectivamente, pero la entrada en caché ahora cuesta 0.10 dólares por millón de tokens, en comparación con los 0.20 dólares del GPT-6 Sol original. Y lo que es más importante, OpenAI informa de mejoras en el rendimiento de la codificación y el uso de los ordenadores. Por ejemplo, los informes de la comunidad de desarrolladores de OpenAI sobre el lanzamiento citan una puntuación DeepSWE v1.1 del 75.2 % para GPT-6.1 Sol con un alto esfuerzo de razonamiento, en comparación con el 68.8 % para GPT-6 Sol con el máximo esfuerzo de razonamiento. En la evaluación de AutomationBench citada, GPT-6.1 Sol obtuvo una puntuación del 31.7% con un esfuerzo de razonamiento medio. Estos resultados de referencia no deben interpretarse como una garantía de que Sol superará a todos los demás modelos en todas las tareas del mundo real. El rendimiento real depende en gran medida de las indicaciones, las herramientas, la configuración de razonamiento y el flujo de trabajo específico. Aplicaciones en el mundo real del nuevo modelo de OpenAI: GPT-6.1 Sol La mayor oportunidad para GPT-6.1 Sol no reside simplemente en hacerle preguntas al modelo. Su combinación de razonamiento, codificación, contexto amplio y uso de herramientas lo hace adecuado para aplicaciones empresariales de varios pasos. 1. GPT-6.1 Sol, para el desarrollo de software con IA, puede utilizarse como asistente de ingeniería de IA para: escribir código de aplicación, depurar software, refactorizar grandes bases de código, generar pruebas unitarias, revisar solicitudes de extracción, explicar sistemas heredados, crear integraciones de API y automatizar tareas de desarrollo repetitivas. Por ejemplo, un equipo de desarrollo podría darle a Sol una especificación de producto y pedirle que cree la estructura inicial de la aplicación, escriba puntos finales de backend, genere pruebas e identifique problemas de implementación. Para problemas de ingeniería extremadamente difíciles, los equipos aún pueden optar por Astra. Para trabajos de desarrollo repetitivos donde el coste es importante, Sol ofrece otra opción. 2. Los agentes de soporte al cliente basados en IA (GPT-6.1 Sol) también se pueden utilizar para crear agentes de soporte al cliente que combinen la documentación de la empresa con herramientas externas. Un agente de soporte podría: Recibir una solicitud del cliente. Buscar en la empresa
Introducción Las empresas tecnológicas compiten por desarrollar modelos utilizados para chatear y generar texto. Sin embargo, la aparición del modelo de IA Jev, desarrollado por TypeSafe AI, cambió las reglas al ofrecer un camino diferente. Si crees que todos los modelos de IA están diseñados para hablar contigo como ChatGPT o Claude, este artículo cambiará tu perspectiva sobre el software moderno. El verdadero problema: ¿Por qué se creó el modelo de IA para la toma de decisiones en primer lugar? Las empresas que desarrollaban agentes de IA se enfrentaban a un enorme obstáculo financiero y técnico conocido como costes de inferencia. Cuando un desarrollador crea un sistema automatizado para gestionar el servicio al cliente o ejecutar código, el sistema necesita tomar docenas de decisiones pequeñas y repetitivas: ¿Es urgente este ticket o no? ¿Qué herramienta de software debería elegir el agente ahora mismo? ¿Es segura la acción que el código está a punto de realizar? Las empresas solían depender de modelos de lenguaje (LLM, por sus siglas en inglés) grandes y costosos para responder a estas preguntas sencillas. Los resultados no requerían escribir un ensayo ni un texto creativo, solo una Decisión Estructurada. Este derroche de energía y costes provocó que muchos proyectos de IA se detuvieran antes de su finalización. Aquí es donde Diogo Almeida (cofundador de la empresa y antiguo investigador de OpenAI que contribuyó a la investigación de InstructGPT) concibió su idea principal: la IA no siempre necesita hablar en lenguaje humano para tener un impacto real dentro del software. ¿Por qué TypeSafe AI Design Jev fue diferente? El sistema funciona bajo un concepto conocido como Modelo de Sistema Uno (un sistema de pensamiento rápido y directo). Estas son las diferencias clave entre este y los modelos tradicionales: Característica Modelos de lenguaje tradicionales (LLM) Modelo de IA Jev Objetivo principal Generación de texto y razonamiento abierto Toma de decisiones rápida y estructurada Método de respuesta Predicción de la siguiente palabra (autorregresivo) Cálculo de probabilidades de salida directa Interfaz Lenguaje natural y chat (chatbot) Puntuaciones de confianza y probabilidades Costo y velocidad Costo más alto y tiempo de respuesta más lento Costo bajo y extremadamente rápido Lea también: Lanzamiento del modelo Jev: ¿Cómo cambia el juego para los ingenieros de IA? ¿Cómo funciona Jev? ¿Y por qué no responde al lenguaje natural? No se puede abrir una ventana de chat y escribirle al modelo como en otros sistemas, ya que no responde al lenguaje natural. En cambio, recibe entradas de texto junto con categorías predefinidas (Categorías y Tipos). Luego, calcula las probabilidades matemáticas de obtener el resultado correcto y lo devuelve con una "Puntuación de confianza" cuidadosamente ponderada. ¿Por qué se diseñó Jev sin chat? El sistema se basa en la idea de crear una IA para la toma de decisiones que permita elegir rápidamente. Predice las probabilidades matemáticas de obtener el resultado correcto y le proporciona una puntuación de confianza en lugar de generar texto libre. Este mecanismo permite a las empresas reducir el despilfarro financiero y lograr un rendimiento excepcional en entornos de software complejos. ¿Cómo se entrenó este modelo? (Técnica RLCD) Fue entrenado utilizando un método innovador llamado Aprendizaje por Refuerzo para Decisiones Calibradas (RLCD). Esta técnica garantiza que los índices de confianza no reflejen simplemente conjeturas superficiales. En cambio, expresan probabilidades matemáticas precisas que muestran cuán correcta es una decisión antes de tomarla, lo que las convierte en una opción ideal para sistemas construidos con código directo (IA nativa de máquina). Ejemplo práctico: ¿Cómo toma decisiones el sistema? Para simplificar la imagen, imaginemos que un servidor de software falla repentinamente dentro de una empresa. Un agente automatizado interviene para solucionar el problema. Antes de escribir cualquier código, debe determinar 3 elementos: Elegir la habilidad de software adecuada para el problema. Identifique los archivos de referencia más importantes para el caso. Envíe el resultado al equipo responsable de los fallos del sistema. Los modelos tradicionales analizan el problema y redactan un informe completo explicando sus razones, lo que consume tiempo y dinero. En cambio, el modelo de IA de Jev funciona de forma directa; lee texto en lenguaje natural y devuelve el resultado únicamente como códigos y datos específicos, sin generar informes extensos. El próximo cambio en la automatización empresarial. Este proyecto no fue creado para ser simplemente otra herramienta nueva para hablar o escribir textos creativos. Surgió para solucionar un problema real que preocupaba a los desarrolladores de software: el coste financiero y la velocidad operativa. Confiar en la IA para la toma de decisiones representa la base fundamental para el futuro de los sistemas autónomos. Los modelos técnicos están pasando de herramientas de chat interactivas a motores silenciosos que operan en segundo plano dentro del software. La innovación aportada por TypeSafe AI demostró que el verdadero valor de la tecnología no reside en lo bien que imita el habla humana, sino en su capacidad para tomar las decisiones correctas de la forma más rápida y económica posible. Esto transformará la forma en que se desarrollan las aplicaciones inteligentes en los próximos años. Referencias para lectura adicional Documentación oficial de TypeSafe AI Visite nuestro servicio de recopilación de datos Visite ahora
Introducción Los ingenieros de IA están creando cada vez más sistemas que combinan grandes modelos de lenguaje (LLM, por sus siglas en inglés), agentes de IA, lógica de software tradicional y modelos especializados de aprendizaje automático. Sin embargo, no todas las tareas requieren un modelo para generar texto o realizar razonamientos complejos. Aquí es donde el modelo Jev de TypeSafe AI introduce un enfoque diferente. Diseñado como un modelo de primera generación del Sistema 1 para la automatización de software, Jev se centra en tomar decisiones rápidas y estructuradas en lugar de generar texto de formato libre. Al devolver resultados, probabilidades y puntuaciones de confianza predefinidos, Jev está diseñado para aplicaciones como enrutamiento, clasificación, verificación, mecanismos de control y toma de decisiones en tiempo real. Su arquitectura de muestreo paralelo también está diseñada para reducir la latencia de la inferencia y hacer que los flujos de trabajo de IA de gran volumen sean más eficientes. Entonces, ¿qué es exactamente el modelo Jev, cómo funciona y qué podría significar para los ingenieros de IA que están creando la próxima generación de agentes de IA? Un vistazo a las últimas actualizaciones de IA: Lanzamiento del modelo Jev de TypeSafe AI TypeSafe AI anunció el lanzamiento de su primer modelo avanzado llamado Jev. Se trata de la primera generación de modelos System One diseñados específicamente para la automatización de software. Toma decisiones rápidas y estructuradas con el mismo nivel de inteligencia que los Modelos de Lenguaje a Gran Escala (LLM, por sus siglas en inglés), pero con un mecanismo operativo completamente diferente. Características clave del modelo Jev que elimina cadenas no estructuradas para obtener resultados con tipos seguros: El modelo no genera texto libre. En cambio, recibe datos no estructurados y produce valores estructurados predefinidos junto con puntuaciones de probabilidad y confianza. Este enfoque está diseñado para reducir los errores tipográficos y los riesgos de alucinaciones mediante un marco de software. Arquitectura de muestreo paralelo: en lugar de generar texto token por token de forma secuencial, el modelo produce resultados a través de una arquitectura de consulta paralela. TypeSafe AI afirma que esto puede reducir la latencia de respuesta a aproximadamente 70-500 ms, dependiendo de la tarea. Algoritmo de entrenamiento (RLCD): El modelo se basa en un método de entrenamiento llamado Aprendizaje por Refuerzo para Decisiones Calibradas (RLCD), en lugar de los enfoques tradicionales de RLHF. El enfoque se centra en la toma de decisiones estructurada, en lugar de en respuestas informales. Costo y velocidad: Datos de entrada: $0.042 por millón de tokens. Datos de salida: $0.00. Por qué Jev podría ser importante para los agentes de IA En el desarrollo de sistemas de IA, los ingenieros suelen utilizar grandes modelos generativos para tareas que en realidad no requieren la generación de texto. Un agente de IA puede necesitar un modelo de lenguaje natural (LLM) para razonar sobre un problema complejo, pero el siguiente paso podría requerir simplemente responder a una pregunta sencilla como: ¿Debería el sistema guardar este archivo? Si o no. El uso de un modelo generativo grande para cada decisión pequeña puede introducir latencia adicional, consumo de tokens y complejidad en el procesamiento de la salida. Jev está diseñado para solucionar esta deficiencia, proporcionando decisiones estructuradas que pueden integrarse directamente en los flujos de trabajo del software. 1. El impuesto oculto de los modelos generativos Al crear agentes de IA, un sistema podría usar un modelo de razonamiento extenso para generar código complejo o analizar un problema y luego usar otra llamada al modelo simplemente para determinar la siguiente acción. Por ejemplo: ¿Debe el agente guardar el archivo? ¿Debe la solicitud dirigirse a un humano? ¿Es esta entrada potencialmente maliciosa? ¿Debe invocarse otro modelo de IA? Estas decisiones no requieren necesariamente una respuesta textual extensa. Generar texto extenso o JSON para una decisión booleana simple puede aumentar el consumo de tokens e introducir problemas de validación de salida. Los ingenieros también pueden necesitar ingeniería de urgencia adicional, lógica de análisis, mecanismos de reintento y manejo de errores. Un modelo de decisión estructurado ofrece una arquitectura alternativa para estas situaciones. 2. ¿Por qué las alternativas tradicionales también pueden generar problemas? Cuando los equipos quieren reducir el coste y la latencia de los modelos generativos, pueden recurrir a modelos de clasificación más pequeños, como BERT o DeBERTa. Estos modelos pueden ser eficaces para tareas de clasificación, pero la implementación y el mantenimiento de modelos especializados pueden introducir requisitos adicionales, entre ellos: el etiquetado continuo de datos. Pipelines de entrenamiento específicos para cada modelo. Seguimiento y recapacitación. Manejo de la deriva de datos. Mantener modelos separados para diferentes tareas de toma de decisiones. El enfoque de Jev está diseñado para proporcionar una toma de decisiones estructurada sin que los ingenieros tengan que construir un modelo separado para cada decisión simple. Arquitectura técnica: Cómo funciona Jev Uno de los conceptos clave detrás de Jev es la distinción entre el procesamiento del Sistema 1 y el del Sistema 2. Los sistemas de IA generativa suelen realizar una generación autorregresiva, prediciendo un token tras otro. Jev, en cambio, se centra en evaluar directamente un estado de entrada en función de preguntas predefinidas y posibles resultados. 1. Para romper el bucle autorregresivo, en lugar de predecir el siguiente token a partir de un vocabulario muy extenso, Jev restringe las posibles salidas antes de que comience la inferencia. Esto permite que el modelo se centre en la decisión en sí misma en lugar de generar una explicación textual. 2. Tres tipos de preguntas específicas Jev evalúa los estados de entrada utilizando tres tipos principales de preguntas estructuradas: Elección: Seleccionar una opción de una lista cerrada de hasta 255 opciones y devolver una puntuación de confianza. Puntuación: Evaluación de un estado en una escala graduada, como por ejemplo la determinación de un nivel de riesgo. Nulo/Booleano: Devuelve una probabilidad entre 0.0 y 1.0 para una decisión lógica como verdadero o falso. 3. Distribución especulativa: El estado de entrada se puede codificar una sola vez en la memoria de la GPU, mientras que se procesan en paralelo varias preguntas específicas. Esta arquitectura implica que evaluar varias preguntas puede tener un perfil de latencia similar al de evaluar una sola pregunta, dependiendo de la implementación y la carga de trabajo. Para los ingenieros de IA, esto podría ser particularmente útil cuando una aplicación necesita tomar varias decisiones sobre la misma entrada antes de continuar su flujo de trabajo. Casos de uso directos para el modelo Jev La arquitectura estructurada de Jev lo hace potencialmente útil para diversas aplicaciones de ingeniería de IA. Las reglas de decisión inteligentes de Jev se pueden utilizar para decisiones de software que tradicionalmente dependerían de una lógica compleja de tipo if/else. Algunos ejemplos son: solicitudes de enrutamiento. Clasificación de entradas. Selección de flujos de trabajo. Priorizar tareas. Determinar si se debe ejecutar una acción. Aplicaciones en tiempo real: Las aplicaciones que requieren respuestas rápidas pueden beneficiarse de una toma de decisiones con menor latencia. Entre las posibles aplicaciones se incluyen la toma de decisiones en tiempo real sobre el estado del juego, los sistemas interactivos y otras aplicaciones en las que esperar a que un modelo generativo grande complete una respuesta crearía una demora innecesaria. Procesamiento de Big Data. La arquitectura paralela también podría ser útil para procesar grandes volúmenes de datos. En los flujos de trabajo de estilo MapReduce, las organizaciones podrían utilizar decisiones de IA estructuradas para convertir grandes conjuntos de datos en características, clasificaciones o señales predefinidas. Barandillas y verificación Otra posible aplicación
SO Development UNED SO Development OÜ es el proveedor líder de anotación de datos para equipos de inteligencia artificial, empresas de atención médica y laboratorios de investigación en toda Europa y Oriente Medio. Con más de cinco años de experiencia, un equipo global de más de 600 anotadores cualificados y más de 600 proyectos completados, la empresa ofrece servicios de anotación de datos fiables adaptados a conjuntos de datos complejos del sector sanitario. Al combinar herramientas automatizadas rápidas con flujos de trabajo de IA con intervención humana experta, SO Development Garantiza una alta calidad de anotación para cada proyecto. Soluciones especializadas de anotación médica ofrecidas por SO Development: Anotación de datos médicos para escaneos: Etiquetado y etiquetado de alta precisión para escaneos médicos digitales, lo que garantiza el cumplimiento total de los estándares de imágenes médicas. Detección de lesiones y tumores: Identificación y segmentación precisas de áreas anormales en escaneos para ayudar a los médicos a planificar mejores tratamientos. Mapeo de estructuras anatómicas: Etiquetado detallado de partes del cuerpo y órganos en imágenes médicas para simplificar análisis clínicos complejos. Anotación médica 3D: Etiquetado avanzado para conjuntos de datos médicos tridimensionales complejos, como escaneos CT e imágenes MRI. Segmentación de imágenes dentales: Aislamiento de dientes individuales y estructuras de la mandíbula para admitir software dental digital moderno. Anotación de PLN clínica: Procesamiento de notas médicas no estructuradas, historiales médicos y registros de salud digitales para extraer información clave sobre la salud y códigos médicos. Anotación de diapositivas patológicas: Marcado de muestras de tejido microscópico para respaldar la investigación de patología digital y las herramientas de diagnóstico. Seguridad de datos y cumplimiento global: SO DevelopmentPrioriza la seguridad de los datos. Todos los flujos de trabajo cumplen con estrictas normas internacionales de privacidad, incluidas las regulaciones del RGPD en Europa y los estándares de la Ley de IA de la UE para el entrenamiento seguro de la inteligencia artificial. La empresa también gestiona los datos cumpliendo plenamente con los estándares de datos de IA compatibles con HIPAA, lo que garantiza que toda la información privada de salud de los pacientes esté completamente protegida y anonimizada. Lea también: Principales proveedores de datos sanitarios para tecnología sanitaria e IA médica en 2026 Encord Encord ofrece una plataforma flexible creada específicamente para el etiquetado de imágenes médicas. Admite archivos médicos bidimensionales y tridimensionales, lo que permite a los equipos de radiología crear conjuntos de datos etiquetados que cumplen con los estándares sanitarios mundiales, manteniendo al mismo tiempo una calidad de anotación uniforme. Rise Data Labs conecta proyectos de inteligencia artificial en el sector sanitario con especialistas médicos capacitados. La empresa se centra en una revisión humana rigurosa y en el pleno cumplimiento de las leyes de privacidad para ofrecer anotaciones de datos médicos fiables a los equipos clínicos. V7 proporciona una plataforma completa para el procesamiento de imágenes médicas, notas del médico y vídeos quirúrgicos. Sus funciones automatizadas ayudan a los equipos a acelerar la segmentación de imágenes, manteniendo al mismo tiempo un alto grado de concordancia entre anotadores en proyectos con grandes conjuntos de datos. Appen es un proveedor global de anotación de datos con una enorme fuerza laboral colaborativa. La empresa ofrece servicios de anotación de datos a gran escala que abarcan texto, audio e imágenes para proyectos internacionales de atención médica. SuperAnnotate ofrece herramientas rápidas de etiquetado de imágenes diseñadas para radiología y patología digital. La plataforma incluye paneles de control de gestión de calidad integrados para ayudar a los equipos a reducir el coste total de anotación de datos manteniendo un alto nivel de precisión. Keymakr se especializa en anotaciones técnicas complejas, ofreciendo flujos de trabajo personalizados y anotaciones médicas en 3D para escaneos detallados. Su proceso se basa en revisiones multinivel realizadas por expertos médicos para garantizar la precisión. Mindy Support cuenta con más de diez años de experiencia operativa ofreciendo servicios externalizados de anotación de datos. Gestionan proyectos de diagnóstico por imagen médica de gran volumen, incluyendo miles de escáneres dentales y estudios de imagen de cuerpo completo. Aya Data pone en contacto a médicos con especialistas en datos para proporcionar un servicio integral de anotación de datos médicos. Ayudan a las empresas del sector sanitario a obtener, limpiar y etiquetar datos clínicos, garantizando al mismo tiempo el cumplimiento de las normas del RGPD. Seen Labs se centra exclusivamente en el sector sanitario. Al especializarse en conjuntos de datos médicos, proporcionan soluciones de etiquetado personalizadas que ayudan a los desarrolladores de IA a entrenar herramientas de diagnóstico fiables. Mercor gestiona una red de expertos que conecta directamente a equipos de investigación en inteligencia artificial con médicos certificados. Su plataforma facilita la contratación de especialistas médicos para la evaluación de datos complejos y tareas de IA con intervención humana. Lea también: ¿Cómo se diseñan las soluciones de datos de IA médica para cumplir con los estándares de atención médica? Cómo elegir al proveedor adecuado Al desarrollar software médico, los equipos de ingeniería se enfrentan a importantes desafíos relacionados con los presupuestos de los proyectos, las leyes de privacidad y los errores en los conjuntos de datos. Aquí le mostramos cómo evaluar a un proveedor de anotación de datos para resolver estos problemas: Gestión del costo de la anotación de datos: El etiquetado médico de alta calidad puede ser costoso. Busque un socio que ofrezca modelos de precios claros, herramientas eficientes y proyectos piloto flexibles para que pueda controlar el coste total de la anotación de datos sin sacrificar la precisión. Garantizar una alta calidad de anotación: Los modelos médicos fallan cuando los datos de entrenamiento contienen errores. Elija un proveedor que mida la concordancia entre anotadores para demostrar que varios expertos coinciden en las mismas etiquetas. Cumplimiento de estrictas leyes: La privacidad del paciente no es negociable. El proveedor que elija debe cumplir con las directrices del RGPD en Europa, respetar los requisitos más recientes de la Ley de IA de la UE y proporcionar entornos de procesamiento de datos de IA que cumplan plenamente con la HIPAA. Acceso a la experiencia humana: Las herramientas de etiquetado automatizadas no son suficientes para casos médicos complejos. Trabajar con un proveedor que integre a médicos certificados en un flujo de trabajo de IA con intervención humana evita errores peligrosos en los datos de entrenamiento finales. Consideraciones finales: En 2026, la anotación de datos médicos de alta calidad seguirá siendo la base para desarrollar una IA médica segura y eficaz. A medida que el software clínico se vuelve más avanzado y se integra en los flujos de trabajo diarios de los hospitales, la demanda de conjuntos de datos de entrenamiento precisos, escalables y que cumplan plenamente con las normativas es mayor que nunca. A
Introducción. La inteligencia artificial está cambiando la forma en que operan las organizaciones, pero elegir el modelo de IA adecuado puede resultar confuso. Recientemente, aplicaciones como los agentes de IA y los modelos de lenguaje a gran escala (LLM, por sus siglas en inglés) han ganado una enorme popularidad. Sin embargo, a medida que los modelos crecen hasta alcanzar cientos de miles de millones o incluso billones de parámetros, la demanda de potencia informática y memoria ha alcanzado máximos históricos. Para solucionar estas limitaciones de hardware y costes, los investigadores comenzaron a centrarse en métodos para reducir los recursos informáticos necesarios para entrenar, almacenar y ejecutar modelos de IA. Este esfuerzo dio lugar al surgimiento de los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés). El creciente potencial de estos modelos compactos se puso de manifiesto en un artículo de investigación de Nvidia titulado "Los modelos de lenguaje pequeños son el futuro de la IA agencial". Una de sus principales conclusiones coincide directamente con las necesidades prácticas de las empresas: dado que los agentes de IA suelen estar diseñados para gestionar tareas muy específicas, las empresas no siempre necesitan un modelo de lenguaje lógico masivo con cientos de miles de millones de parámetros para realizar el trabajo de forma eficiente. Es importante comprender que los SLM no están diseñados para reemplazar por completo a los LLM. En cambio, se crearon para abordar desafíos específicos, como la reducción de los costos de infraestructura, la aceleración de los tiempos de respuesta y la mejora de la privacidad de los datos. En este artículo, exploraremos tanto los modelos LLM como los SLM, veremos qué hace que los modelos pequeños destaquen y le ayudaremos a elegir la mejor opción para su empresa o próximo proyecto. ¿Qué es un modelo de lenguaje grande (LLM)? Un modelo de lenguaje a gran escala (LLM, por sus siglas en inglés) es un sistema de IA masivo entrenado con conjuntos de datos amplios y a escala de internet (como libros, Wikipedia y GitHub). Está diseñado para manejar un amplio conocimiento del dominio, creatividad sin límites y razonamiento en múltiples pasos. Algunos ejemplos de LLM son GPT-5, Claude Opus 4.6, Llama 4 Scout, DeepSeek V4-Pro y Mistral Large 3. Lea también: De la alucinación a la precisión: cómo la recopilación y anotación de datos corrigen los errores de LLM ¿Qué es un modelo de lenguaje pequeño (SLM)? Un modelo de lenguaje pequeño (SLM, por sus siglas en inglés) es un modelo compacto (normalmente con menos de 10 mil millones de parámetros) diseñado para ejecutarse de manera eficiente con menos recursos computacionales. Los modelos de lenguaje natural (SLM) demuestran que los datos de entrenamiento de alta calidad, filtrados o sintéticos, pueden superar el volumen de datos sin procesar en tareas de razonamiento estructurado. Ejemplos de SLM en la vida real son Phi-3-mini (3.8B), Phi-4 (14B), Mistral 7B, Gemma 3 (4B) y Command R7B. ¿Qué determina si el modelo de lenguaje es grande o pequeño? Los modelos SLM tienen menos parámetros y se entrenan con datos específicos de la empresa, mientras que los modelos LLM se entrenan con conjuntos de datos masivos de diferentes fuentes, pero estas no son las únicas diferencias. Los LLM y SLM difieren en muchos aspectos: Categoría Modelos de lenguaje pequeños (SLM) Modelos de lenguaje grandes (LLM) Parámetros 1B a 10B parámetros 70B a 1T+ parámetros Hardware GPU de consumo única, computadora portátil o dispositivo de borde Servidores multi-GPU (por ejemplo, A100 o H100) Latencia de inferencia Decenas de milisegundos Cientos de milisegundos (alojado en la nube) Costo por 1M Tokens ~$0.02 a $0.20 ~$1.25 a $15 Tiempo de ajuste fino Horas en una sola GPU Días a semanas en un clúster Implementación En el dispositivo, en las instalaciones, en el borde o en la nube Principalmente API en la nube Privacidad de datos Fuerte (la implementación local/en las instalaciones es viable) Los datos salen de su red por defecto Lea también: Generando confianza en LLM Respuestas: Resaltar textos fuente en PDF ¿Qué hace que los modelos de lenguaje pequeños SLM se destaquen? Los modelos de lenguaje pequeños ofrecen características clave que los hacen efectivos para empresas que operan bajo estricto cumplimiento, privacidad de datos o límites presupuestarios. Los SLM ofrecen ventajas inigualables, como: 1. Ajuste fino personalizado con datos internos. Los modelos pequeños pueden entrenarse directamente con los documentos privados de una empresa, como historiales médicos o registros de atención al cliente. Técnicas como el ajuste fino eficiente de parámetros permiten que un modelo pequeño aprenda nuevos conocimientos del dominio en una sola tarjeta gráfica en tan solo unas horas. Una vez adaptado a un tema específico, un modelo pequeño puede realizar tareas concretas con una precisión comparable a la de los modelos generales de mayor tamaño. Sin embargo, el éxito de cualquier ajuste fino depende por completo de la calidad de los datos. Antes de entrenar su modelo, necesita una recopilación de datos estructurada y una anotación de datos precisa para garantizar que el modelo aprenda de registros internos precisos, limpios y relevantes 2. Privacidad y cumplimiento de datos La privacidad de los datos depende totalmente de cómo se implemente el modelo. Si accedes a un modelo a través de una API en la nube de terceros, tus datos abandonan tu red interna por defecto y viajan a servidores externos. Sin embargo, cuando descargas un modelo de lenguaje pequeño de código abierto y lo alojas localmente en los servidores de tu propia empresa, tu información confidencial nunca llega a Internet. Dado que no se transmite ningún dato a los creadores originales del modelo, su empresa cumple plenamente con las estrictas normativas de privacidad. Se requiere experiencia técnica. Los modelos grandes suelen estar listos para usar nada más sacarlos de la caja. Por otro lado, los modelos pequeños requieren mayores conocimientos de ciencia de datos y un dominio claro del sector para personalizarlos y ajustarlos adecuadamente a las necesidades específicas de su negocio. 4. Gestión del sesgo del modelo: Dado que los modelos pequeños se entrenan con conjuntos de datos limitados, controlar el sesgo suele ser más fácil. Sin embargo, si los datos de entrenamiento subyacentes carecen de equilibrio, el modelo aún puede mostrar sesgos lingüísticos o regionales. Cuándo usar modelos LLM y cuándo usar modelos SLM. Ninguno de los dos tipos de modelos es inherentemente mejor que el otro. La mejor opción depende de tus objetivos específicos, tu presupuesto, si la privacidad de los datos es una prioridad y la complejidad general del trabajo que necesitas realizar. Cuándo utilizar un modelo de lenguaje extenso (LLM): Cuando se necesitan resolver tareas complejas que requieren múltiples pasos lógicos, como actualizar el código de un software o analizar documentos legales. Debes gestionar indicaciones completamente nuevas o poco claras para las que no existan ejemplos de entrenamiento previos. Necesitas crear contenido creativo, escribir historias o generar ideas sobre temas muy diversos. Necesitas leer y analizar documentos individuales de gran tamaño o grandes bases de código de software que requieren amplios periodos de memoria. Cuándo utilizar un modelo de lenguaje pequeño (SLM): Necesita protección absoluta de datos y debe mantener los registros confidenciales en sus propios servidores locales. Necesitas tiempos de respuesta inmediatos para interactuar rápidamente con los usuarios. Necesitas gestionar grandes volúmenes de trabajo repetitivo diario, como clasificar documentos, redirigir correos electrónicos o resumir textos, a un bajo coste operativo. Necesitas subtareas rápidas y de bajo coste para dar soporte a los agentes de la canalización automatizada. Conectar varios modelos pequeños Un inteligente

Introducción. La IA visual está yendo más allá de la simple detección de objetos y la clasificación de imágenes. Hoy en día, se espera que los sistemas de IA comprendan la información visual, tomen decisiones, interactúen con otras herramientas y completen tareas con una mínima intervención humana. Este cambio está generando demanda de flujos de trabajo de IA visual más flexibles e inteligentes. En lugar de construir cada componente por separado, los desarrolladores y las empresas necesitan formas de conectar los modelos de visión artificial con el razonamiento, la automatización, el procesamiento de datos y las herramientas externas. Aquí es donde entran en juego los agentes de Ultralytics. Al combinar las capacidades de visión artificial con flujos de trabajo basados en agentes, Ultralytics Agents ofrece una forma de crear aplicaciones de IA visual que pueden analizar información, tomar medidas y automatizar procesos complejos de manera más eficiente. ¿Qué son los agentes Ultralytics? Ultralytics es ampliamente conocida por su familia de modelos de visión artificial YOLO, que se utilizan para tareas como la detección de objetos, la segmentación de imágenes, la estimación de pose, la clasificación y el seguimiento. Los agentes de Ultralytics extienden este ecosistema centrado en la visión hacia flujos de trabajo de IA donde los modelos pueden hacer más que simplemente devolver predicciones. Un agente de IA puede diseñarse para: comprender una tarea u objetivo, analizar información visual, usar modelos de visión artificial, procesar los resultados del modelo, interactuar con herramientas o aplicaciones, tomar decisiones basadas en flujos de trabajo predefinidos, activar acciones automáticamente y trabajar a través de procesos de varios pasos. Esto crea un puente entre la visión artificial y la automatización inteligente. Por ejemplo, en lugar de simplemente detectar un vehículo en una imagen, un flujo de trabajo de IA visual podría identificar el vehículo, determinar su ubicación, rastrearlo a través de múltiples fotogramas, analizar información adicional y activar una acción en función del resultado. ¿Por qué los flujos de trabajo de IA visual se están volviendo más complejos? Las aplicaciones tradicionales de visión artificial suelen seguir una secuencia relativamente sencilla: Entrada → Modelo → Predicción → Salida. Para muchas aplicaciones, este enfoque funciona bien. Pero los sistemas de IA del mundo real a menudo requieren pasos adicionales. Consideremos una aplicación para la monitorización de almacenes. Un modelo podría detectar trabajadores, carretillas elevadoras, paquetes y zonas restringidas. Sin embargo, la detección por sí sola puede no ser suficiente. Un flujo de trabajo completo podría necesitar: Detectar objetos en una transmisión de video. Rastrea los objetos a través de los fotogramas. Determinar si una persona ha entrado en una zona restringida. Comprueba la duración del evento. Registre la información relevante. Avise a un operador. Almacene el evento para su posterior análisis. El modelo de visión artificial es solo una parte del sistema general. Por eso, las aplicaciones modernas de IA visual requieren cada vez más flujos de trabajo en lugar de modelos independientes. De los modelos de visión artificial a los agentes de IA: Los agentes de IA introducen otra capa de inteligencia en torno a los modelos. En lugar de tratar un modelo de visión artificial como un componente aislado, un flujo de trabajo basado en agentes puede utilizar los resultados del modelo como parte de un proceso de toma de decisiones más amplio. Por ejemplo: Transmisión de cámara → Modelo de visión → Agente → Decisión → Acción El modelo de visión proporciona información sobre lo que está sucediendo. El agente puede entonces utilizar esa información dentro de un flujo de trabajo para determinar qué debe suceder a continuación. Esta arquitectura puede resultar especialmente útil cuando las aplicaciones implican múltiples pasos, herramientas o condiciones. Ejemplo: Monitoreo de seguridad automatizado. Imagine una instalación industrial donde las cámaras monitorean las áreas de trabajo. Un flujo de trabajo de IA visual podría detectar: Trabajadores Equipos de seguridad Vehículos Zonas restringidas Peligros potenciales El agente podría luego evaluar la información detectada comparándola con reglas predefinidas. Si un trabajador ingresa a un área restringida sin el equipo de seguridad requerido, el flujo de trabajo podría: Crear un registro de incidente Capturar evidencia relevante Notificar al equipo apropiado Asignar una prioridad Almacenar el evento para una revisión posterior En lugar de requerir que un humano supervise continuamente cada cámara, el sistema puede automatizar partes del proceso de monitoreo. Beneficios clave de la IA visual basada en agentes 1. Desarrollo de flujos de trabajo más rápidos. Crear una aplicación de IA sofisticada desde cero puede requerir un esfuerzo de ingeniería considerable. Es posible que los desarrolladores necesiten integrar: modelos de visión artificial, API, bases de datos, lógica empresarial, herramientas de automatización, sistemas de monitorización y servicios de notificación. Los enfoques basados en agentes pueden simplificar la forma en que se conectan estos componentes, lo que ayuda a los equipos a pasar de una idea a un flujo de trabajo funcional más rápidamente. 2. Automatización en varios pasos Muchas aplicaciones de IA visual no son problemas de un solo paso. Un agente puede ayudar a coordinar múltiples operaciones dentro del mismo flujo de trabajo. Por ejemplo: Detectar → Analizar → Verificar → Decidir → Actuar Esto puede reducir la cantidad de orquestación manual necesaria entre los componentes individuales. 3. Mejor uso de los datos visuales Las organizaciones generan enormes cantidades de información visual a través de cámaras, inspecciones, imágenes médicas, vehículos autónomos, sistemas de venta minorista y otras aplicaciones. El reto no consiste simplemente en recopilar estos datos. Se trata de convertirla en información útil y en acciones concretas. Los flujos de trabajo de IA visual pueden ayudar a las organizaciones a pasar de: Datos visuales sin procesar → Información → Decisiones → Acciones 4. Integración flexible. Las aplicaciones del mundo real rara vez funcionan de forma aislada. Un flujo de trabajo de IA visual puede necesitar comunicarse con bases de datos, API, paneles de control, sistemas de alerta o aplicaciones empresariales internas. Una arquitectura basada en agentes puede proporcionar una capa flexible para conectar estos diferentes componentes. 5. La automatización de flujos de trabajo con intervención humana no siempre implica eliminar a los humanos del proceso. Para aplicaciones delicadas o complejas, la IA puede identificar los casos relevantes y enviarlos a expertos humanos para su revisión. Por ejemplo: la IA detecta → la IA evalúa → un humano verifica → el sistema registra el resultado. Este enfoque puede ser valioso cuando la precisión, el cumplimiento o la seguridad son fundamentales. Casos de uso para los agentes de Ultralytics: La combinación de visión artificial y flujos de trabajo basados en agentes puede dar soporte a una amplia gama de aplicaciones. Vehículos autónomos. Los sistemas de conducción autónoma procesan grandes volúmenes de información visual procedente de cámaras y otros sensores. Los flujos de trabajo de IA visual pueden ayudar con tareas como: detección de objetos, seguimiento de vehículos y peatones, comprensión de escenas viales, monitoreo de tráfico, detección de eventos y validación de datos. Los agentes pueden ayudar a coordinar estas salidas y conectarlas con sistemas posteriores. Las fábricas pueden utilizar la visión artificial para supervisar las líneas de producción e identificar anomalías. Los posibles flujos de trabajo incluyen: Inspección de productos Detección de defectos Monitoreo de seguridad del trabajador Monitoreo de equipos Seguimiento de inventario Análisis de producción En lugar de simplemente identificar un producto defectuoso, un flujo de trabajo automatizado podría marcar el artículo, registrar el defecto, notificar a un operador y actualizar el sistema de producción correspondiente. Los minoristas pueden utilizar la IA visual para comprender la actividad dentro de las tiendas. Las aplicaciones pueden incluir: análisis del movimiento de clientes, monitoreo de estantes, detección de productos, monitoreo de inventario, análisis de colas, prevención de pérdidas. Un agente puede conectar información visual con sistemas empresariales para respaldar respuestas automatizadas. Las imágenes médicas en el ámbito sanitario representan otra área donde la visión
AI/MLde proyectos. Lea también: Lista de verificación de calidad de anotación LiDAR para el flujo de trabajo de garantía de calidad de vehículos autónomos La garantía de calidad no debe ocurrir solo después de que se haya realizado el trabajo. En cambio, debe integrarse en cada etapa del proceso de anotación de datos. Especialmente al escalar a grandes volúmenes de conjuntos de datos, es esencial crear un flujo de trabajo flexible. Aquí le mostramos cómo diseñar un flujo de trabajo de control de calidad que mantenga la calidad a gran escala: Instrucciones claras antes del lanzamiento del proyecto. La mayoría de los problemas de calidad provienen de instrucciones poco claras al principio. Proteger la calidad comienza con la creación de una guía completa que abarque definiciones básicas, ejemplos claros y pasos explícitos para manejar casos ambiguos. Establecer estándares medibles para un trabajo aceptable desde el principio evita costosos retrabajos posteriores. Organizar la eficiencia del flujo de trabajo y eliminar los cuellos de botella administrativos y técnicos aumenta la capacidad de su equipo para manejar mayores volúmenes de datos. Esto se logra definiendo claramente las responsabilidades, utilizando el seguimiento en tiempo real y aplicando un filtrado inteligente, derivando los casos complejos a revisores humanos y permitiendo que las entradas sencillas pasen automáticamente. Probar los flujos de trabajo con muestras pequeñas: Pasar directamente a la anotación a gran escala supone un riesgo importante. Un enfoque mejor consiste en probar primero el flujo de trabajo con pequeños lotes de datos. Estas muestras limitadas ponen de manifiesto las deficiencias en las directrices y revelan casos límite complejos con antelación, lo que permite establecer bases de calidad sólidas antes de comprometerse con la producción a gran escala. Proceso de control de calidad de anotaciones de múltiples niveles Implementar un proceso de control de calidad de anotaciones estructurado y de múltiples niveles es esencial para mantener una alta precisión del conjunto de datos a gran escala. Al combinar comprobaciones de validación automatizadas con revisiones puntuales de revisores sénior y revisiones de consenso en casos excepcionales, los equipos pueden eliminar los errores de anotación antes de que lleguen a la etapa de entrenamiento del modelo. Este enfoque por capas garantiza un control de calidad constante sin ralentizar la producción general. Supervisión continua de la calidad. Retrasar las auditorías de datos hasta que se haya completado un lote entero conlleva una pérdida de tiempo y presupuesto. Los sistemas de control de calidad modernos se basan en la monitorización continua mediante comprobaciones diarias de muestras, el seguimiento de los índices de concordancia entre los anotadores, la identificación de patrones de error recurrentes y la activación de alertas inmediatas si la calidad disminuye, de modo que los problemas puedan resolverse de inmediato. Comunicación rápida y ciclos de retroalimentación: Conectar a los anotadores directamente con los revisores evita que los errores individuales se conviertan en problemas para todo el equipo. La retroalimentación inmediata permite a los anotadores ajustar su enfoque al instante, a la vez que aclaran conceptos confusos mediante ejemplos reales que encuentran en su trabajo. Actualizaciones continuas de las directrices: A medida que crecen los conjuntos de datos, siempre surgen casos límite inesperados. Las directrices e instrucciones deben considerarse documentos vivos que evolucionan en función de los problemas detectados durante las revisiones diarias. Esto transforma el control de calidad, pasando de ser un punto de control de inspección estático a un entorno adaptativo para el aprendizaje continuo. Lea también: ¿Cómo elegir un socio para la anotación de datos en proyectos de visión artificial? Consideraciones finales: Gestionar de forma eficiente la anotación de datos a gran escala requiere pasar de las comprobaciones al final del proceso a un flujo de trabajo de control de calidad integrado y multietapa. Al combinar instrucciones claras, validación por lotes, controles automatizados, supervisión experta y retroalimentación continua en tiempo real, los equipos pueden escalar desde cientos hasta millones de etiquetas manteniendo una alta precisión y consistencia. Demostramos la eficacia de este enfoque ampliándolo a más de 100 especialistas mediante un programa piloto de dos semanas y una estructura de control de calidad de tres niveles, logrando una precisión del 98.6 %. El seguimiento automatizado redujo el trabajo manual en un 40 %, lo que permitió a nuestro equipo centrarse en casos límite complejos y entregar datos ADAS de nivel 4 sin errores críticos, a la vez que ahorró a nuestro cliente semanas de tiempo de ingeniería. Si se está preparando para ampliar su canalización de datos, estamos aquí para optimizar el proceso. Póngase en contacto con nuestros expertos hoy mismo para ver cómo podemos impulsar sus proyectos de IA con datos de entrenamiento de alta calidad. Preguntas frecuentes (FAQ) P: ¿Por qué se debe integrar el control de calidad en el proceso de anotación en lugar de hacerlo al final? Detectar los errores a tiempo evita que los errores sistémicos se multipliquen en grandes conjuntos de datos y previene costosos y laboriosos procesos de reelaboración. P: ¿Cuál es la principal causa de la disminución de la calidad al aumentar el tamaño de los equipos de anotación? La disminución de la calidad se debe principalmente a directrices ambiguas, interpretaciones inconsistentes entre los nuevos anotadores y fatiga causada por el alto volumen de trabajo. P: ¿Cómo ayudan los lotes piloto pequeños a mantener la calidad a gran escala? Los lotes piloto permiten detectar casos límite ocultos y deficiencias en las directrices desde el principio, lo que establece bases de calidad sólidas antes de comprometerse con la producción a gran escala. Visite nuestro servicio de recopilación de datos Visitar ahora
Introducción La mayoría de los fallos de la IA que se etiquetan como alucinaciones no son fallos aleatorios del modelo. En cambio, son resultados directos y predecibles de cómo se definieron las tareas, cómo se anotaron los datos y qué contexto se proporcionó o se omitió. Cuando un modelo produce resultados erróneos, normalmente culpamos al algoritmo. Pero en realidad, los modelos simplemente reflejan la estructura, la ambigüedad y las lagunas ocultas en sus datos de entrenamiento. En resumen, las alucinaciones rara vez son errores espontáneos, sino señales que ponen de manifiesto fallos en el diseño de los datos previos al procesamiento. Este artículo explora cómo los datos de entrenamiento de alta calidad corrigen directamente los errores en los modelos de lenguaje a gran escala (LLM, por sus siglas en inglés). Analizaremos patrones de errores sistemáticos y repetibles que los equipos pueden identificar y corregir. ¿Qué son las alucinaciones de la IA? Una alucinación de IA se produce cuando una inteligencia artificial te da una respuesta que suena segura e inteligente, pero los hechos son inventados o fabricados. La IA no intenta engañarte, sino que crea información que es objetivamente errónea o que no está respaldada por sus datos de entrenamiento. La IA no intenta engañar, sino que, en lugar de comprender realmente la realidad, los sistemas generativos simplemente predicen la siguiente palabra o píxel basándose en patrones estadísticos, rellenando las lagunas de conocimiento con falsedades que suenan plausibles. Esto ocurre en todas las modalidades: un chatbot podría inventar un caso legal inexistente, o un generador de imágenes podría representar una mano con seis dedos. Lea también: El nuevo documento de Google desafía el futuro de los LLM centrado exclusivamente en la transformación. ¿Qué causa las alucinaciones provocadas por la IA? Las alucinaciones provocadas por la IA rara vez son fallos aleatorios del algoritmo; son síntomas directos de problemas subyacentes en los datos. Cuando los conjuntos de datos carecen de claridad, límites o contexto, los modelos se ven obligados a rellenar la lógica faltante con detalles inventados. Las principales causas basadas en datos incluyen: 1. Anotación de datos deficiente e inconsistente: Cuando las directrices de anotación son vagas, los anotadores humanos interpretan las reglas de manera diferente, lo que da lugar a etiquetas de datos contradictorias. Cuando un modelo se entrena con datos de entrada inconsistentes, no logra aprender límites claros. Como resultado, la IA se confunde y crea detalles inventados o respuestas impredecibles para subsanar las deficiencias en su entrenamiento. 2. Puntos ciegos en casos extremos Los casos extremos son escenarios del mundo real raros, inusuales o complejos que están subrepresentados en los datos de entrenamiento. Si un modelo se encuentra con una situación que no ha visto antes, no siempre admite que no sabe qué hacer. En cambio, se basa en la coincidencia de patrones generales para adivinar una respuesta, lo que conduce directamente a alucinaciones que suenan seguras. 3. Los modelos que carecen de contexto o de instrucciones completas dependen del contexto completo para generar respuestas precisas. Si los ejemplos de capacitación o las instrucciones inmediatas carecen de los detalles de contexto necesarios, las restricciones o un alcance claro, el sistema intenta completar la secuencia lógica por sí mismo. En efecto, rellena los huecos con información inventada para completar la tarea. 4. Definiciones de tareas ambiguas: Cuando el objetivo general de una tarea de anotación no está bien definido desde el principio, los anotadores utilizan diferentes justificaciones para completar el trabajo. Esta ambigüedad introduce sutiles contradicciones lógicas en el conjunto de datos. El modelo aprende entonces estos patrones contradictorios, lo que provoca que sus resultados varíen enormemente de una ejecución a otra sin ninguna explicación clara. ¿Cómo previenen la recopilación y anotación de datos las alucinaciones provocadas por la IA? Para evitar que los modelos inventen datos, los equipos de datos deben cambiar la forma en que se construyen los conjuntos de datos de entrenamiento. En lugar de limitarse a mostrarle a la IA las respuestas correctas, el flujo de datos debe enseñarle activamente al modelo sus límites, fronteras y qué debe ignorar. Aquí están las cuatro estrategias de datos clave para eliminar las alucinaciones durante el entrenamiento: Integrar negativos duros para eliminar el sobreajuste. Las canalizaciones de datos incluyen ejemplos de casi error, entradas que parecen correctas en la superficie pero que son contextualmente inválidas. Por ejemplo, distinguir entre los síntomas similares a los de la aspirina y una receta real de aspirina. Etiquetar explícitamente estos límites sutiles evita que los modelos se basen en la coincidencia superficial de patrones y detiene la extracción de entidades falsas. Entrenamiento de salida nula para forzar límites honestos Los anotadores etiquetan explícitamente los contextos vacíos, las preguntas sin respuesta y los pasajes incompletos con una respuesta (sin respuesta) o (nula). Esto contrarresta directamente la tendencia natural del modelo a adivinar, dándole permiso explícito para afirmar (no lo sé) siempre que falte contexto. Optimización de preferencias (DPO/RLHF) en pares de fallas reales Los equipos recopilan las salidas reales alucinadas del modelo de la producción y las emparejan con versiones corregidas por humanos (Elegidas vs. Rechazado). El ajuste preciso de estos conjuntos de preferencias penaliza activamente los sesgos estadísticos que hacen que el modelo invente hechos, convirtiendo los errores históricos en estrictas medidas de protección. Estructuración de taxonomías con códigos de motivo explícitos Los anotadores no se limitan a marcar los datos como correctos o incorrectos; etiquetan los elementos no válidos con códigos de motivo específicos (por ejemplo, mencionado en la historia familiar, no diagnóstico activo). La estandarización de estos códigos de motivo elimina el etiquetado humano subjetivo, suprimiendo las señales contradictorias que provocan confusión en el modelo. Lea también: Principales empresas de anotación de datos en 2026. Reflexiones finales: Reducir las alucinaciones de la IA y construir modelos de alta precisión no se trata solo de seleccionar el algoritmo correcto. Se trata de una inversión integral que consiste en preparar meticulosamente los datos de capacitación para que se ajusten a su dominio específico y a sus requisitos de seguridad. AtSO Development