
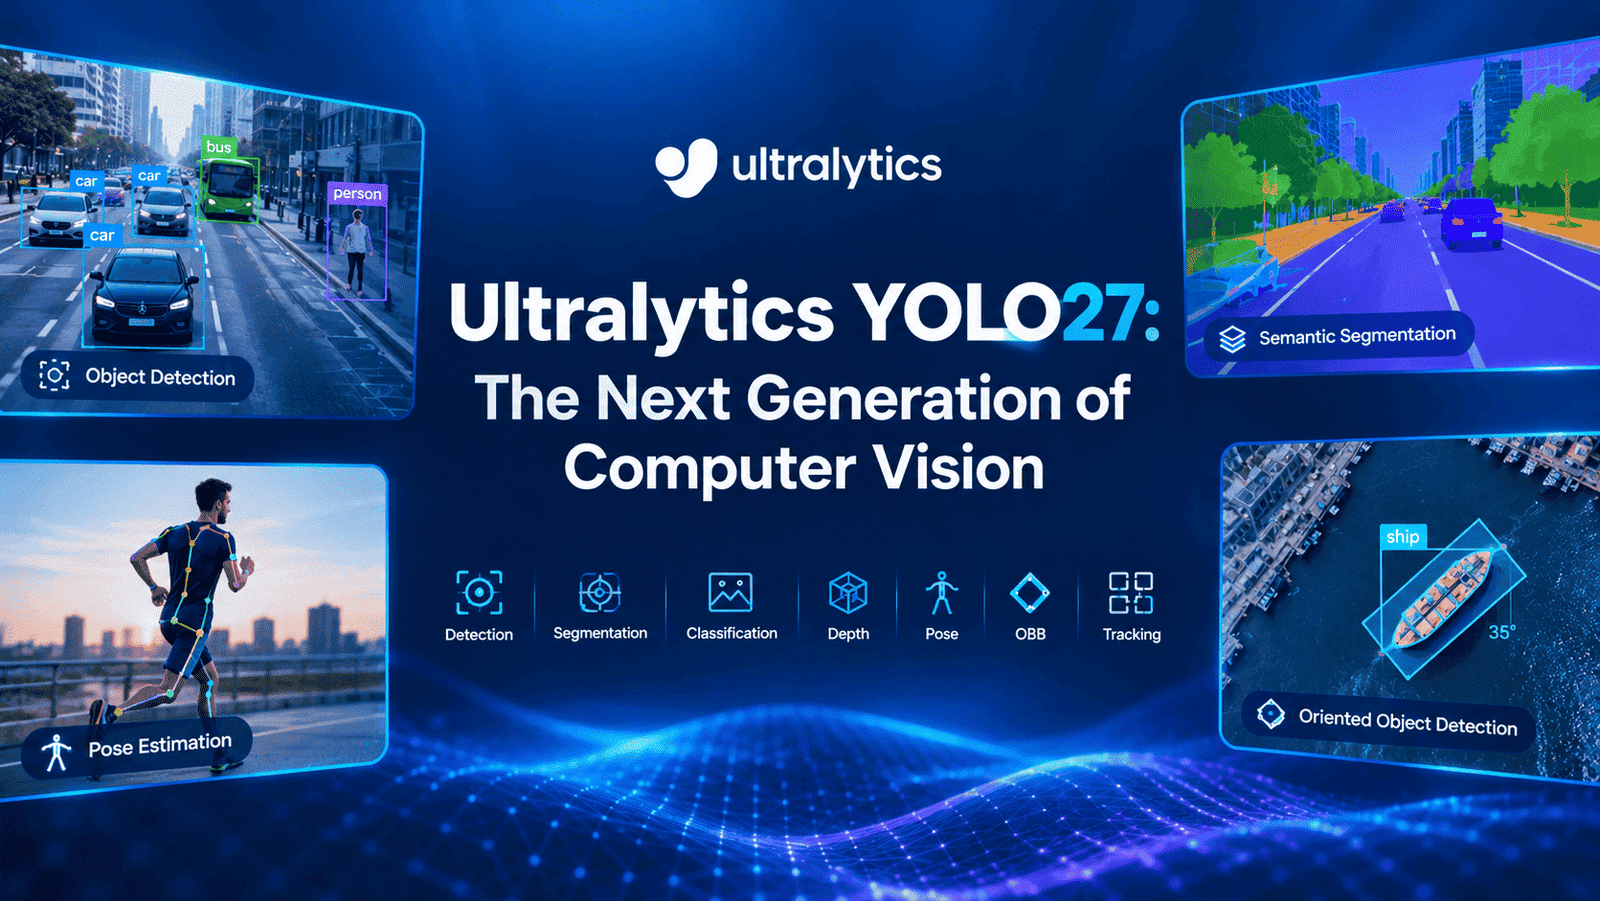
Introducción. La visión artificial en tiempo real está evolucionando rápidamente. Desde vehículos autónomos y drones hasta robótica, inspección industrial, cámaras inteligentes e imágenes médicas, los sistemas de IA necesitan cada vez más comprender la información visual con alta precisión y una latencia extremadamente baja. La familia YOLO ha desempeñado un papel fundamental en esta evolución. Tras años de mejoras en velocidad, precisión y despliegue, Ultralytics está preparando su familia de modelos de próxima generación: YOLO27. YOLO27 está diseñado para continuar con la filosofía de YOLO de visión artificial rápida y práctica, al tiempo que introduce nuevas ideas arquitectónicas. La próxima familia combina una arquitectura CNN optimizada para sus modelos más pequeños con una arquitectura de detección basada en consultas y sin NMS para sus modelos más grandes. Según la documentación oficial de Ultralytics, YOLO27 se encuentra actualmente en la fase final de investigación y desarrollo. Se prevé que los modelos se lancen a finales de 2026, pero aún no se ha anunciado ninguna fecha de lanzamiento oficial. Los pesos, las configuraciones y el código de implementación no están disponibles públicamente, y las características actuales y los resultados de las pruebas de rendimiento pueden cambiar antes del lanzamiento. Para los desarrolladores interesados en la evolución de YOLO, nuestro artículo sobre YOLO26: La próxima evolución de la visión artificial en tiempo real proporciona información útil sobre la generación anterior y el movimiento de la industria hacia modelos de visión integrales y listos para su implementación. ¿Qué es Ultralytics YOLO27? Ultralytics YOLO27 es una próxima familia de modelos de visión artificial en tiempo real diseñados para una amplia gama de tareas de visión. La familia incluye cuatro tamaños de modelo planificados: YOLO27n – Nano YOLO27s – Pequeño YOLO27m – Mediano YOLO27l – Grande Los modelos están planificados para admitir: Detección de objetos Segmentación de instancias Segmentación semántica Estimación de profundidad Clasificación de imágenes Estimación de pose Detección de objetos orientados Seguimiento de múltiples objetos para los modelos compatibles Uno de los aspectos más interesantes de YOLO27 es que sus modelos de detección utilizan dos enfoques arquitectónicos diferentes. YOLO27n y YOLO27s utilizan un diseño simplificado basado en CNN optimizado para una inferencia eficiente, mientras que YOLO27m y YOLO27l utilizan una arquitectura basada en consultas que puede generar detecciones sin la supresión no máxima (NMS) tradicional. Esto convierte al YOLO27 en algo más que una simple actualización de tamaño del modelo; es más bien una evolución arquitectónica de la familia YOLO. YOLO27 y la evolución de los modelos YOLO La arquitectura YOLO ha evolucionado significativamente desde su introducción. Las generaciones anteriores se centraron principalmente en lograr una detección de objetos más rápida y precisa. Los modelos posteriores introdujeron mejoras en la extracción de características, el entrenamiento, la eficiencia del modelo y la implementación. Los desarrolladores que deseen comprender la evolución práctica de YOLO también pueden consultar nuestra guía sobre cómo usar YOLOv11 para la detección de objetos. YOLO27 continúa esta progresión abordando varios desafíos que siguen siendo importantes en la visión artificial moderna: detección de objetos pequeños, latencia de inferencia, sobrecarga de posprocesamiento, complejidad de la implementación, precisión frente al tamaño del modelo e inferencia eficiente en el borde. El resultado es una familia de modelos diseñada en torno a diferentes requisitos de implementación en lugar de una única arquitectura optimizada para cada situación. YOLO27 contra. YOLO26 YOLO27 se posiciona como el sucesor de YOLO26. Sin embargo, la diferencia clave no radica simplemente en que YOLO27 sea más grande o más preciso. La nueva generación introduce diferentes estrategias arquitectónicas para diferentes tamaños de modelos. YOLO27n y YOLO27s Los modelos más pequeños se centran en: Arquitectura CNN eficiente Detección de doble escala Detección de objetos pequeños Menor cálculo del cabezal de detección Implementación en el borde Vídeo en tiempo real YOLO27m y YOLO27l Los modelos más grandes se centran en: Detección basada en consultas Decodificación Transformer Inferencia sin NMS Implementación de GPU de alta precisión Contexto visual global La documentación oficial recomienda actualmente seguir utilizando YOLO26 para proyectos de producción hasta que se lance YOLO27. Para obtener información detallada sobre la generación anterior, consulte nuestra guía completa sobre YOLO26: La próxima evolución de la visión artificial en tiempo real. Las dos arquitecturas de detección de YOLO27 Una de las mayores innovaciones de YOLO27 es que los cuatro modelos de detección no utilizan la misma arquitectura de detección. Ultralytics los ha dividido en dos grupos. YOLO27n y YOLO27s: Arquitectura CNN optimizada. YOLO27n y YOLO27s están diseñados para aplicaciones donde la velocidad de inferencia y la eficiencia computacional son fundamentales. Los detectores de objetos tradicionales suelen predecir objetos utilizando tres mapas de características: características de resolución fina, características de resolución media y características de resolución gruesa. YOLO27n y YOLO27s eliminan la escala de predicción media. En cambio, utilizan: Un mapa de características finas para objetos pequeños Un mapa de características gruesas para objetos grandes Eliminar el mapa de predicción medio reduce una parte significativa del cálculo del cabezal de detección al tiempo que conserva las escalas de características consideradas más importantes para objetos pequeños y grandes. Este diseño hace que los modelos más pequeños sean particularmente interesantes para: IA de borde Drones Robótica Cámaras inteligentes Vídeo en tiempo real Sistemas embebidos Detección de objetos pequeños En YOLO27 La detección de objetos pequeños sigue siendo uno de los desafíos más difíciles en la visión por computadora. Los objetos que ocupan solo un pequeño número de píxeles contienen menos información visual, lo que dificulta su clasificación y localización. Esto es especialmente importante en: Imágenes de drones Monitoreo de tráfico Imágenes satelitales Vigilancia Vehículos autónomos Análisis de video de áreas grandes Nuestra guía detallada sobre Detección de objetos pequeños en visión artificial: desafíos, técnicas y tendencias futuras explora por qué los objetivos pequeños son difíciles de detectar y las técnicas utilizadas para mejorar su reconocimiento. YOLO27n y YOLO27s abordan este desafío ampliando una etapa inicial de características de alta resolución para que la red pueda retener información más detallada. En combinación con el mapa de predicción de alta resolución restante, esto tiene como objetivo mejorar la localización y la regresión de objetos pequeños. YOLO27n y YOLO27s también introducen la supervisión de alineación del primer plano. Durante el entrenamiento, una rama auxiliar ligera aprende a separar los objetos en primer plano de las regiones de fondo. Esto cierra la brecha entre la supervisión intensiva del entrenamiento y el cabezal de predicción final uno a uno. Según Ultralytics, la diferencia de precisión se reduce de aproximadamente: 0.9 mAP a 0.4 mAP para YOLO26n → YOLO27n 0.8 mAP a 0.4 mAP para YOLO26s → YOLO27s La rama adicional se utiliza solo durante el entrenamiento y se elimina durante la inferencia y la exportación, lo que significa que no agrega cálculos en el tiempo de implementación. YOLO27m y YOLO27l: Detección sin NMS. Los modelos YOLO27 de mayor tamaño adoptan un enfoque diferente. En lugar de generar muchas predicciones superpuestas y filtrarlas mediante la supresión no máxima, YOLO27m y YOLO27l utilizan un decodificador transformador basado en consultas. El decodificador trabaja con un conjunto fijo de consultas de objetos y las refina progresivamente para producir las detecciones finales. Esto significa que las predicciones finales se pueden generar directamente sin el posprocesamiento NMS tradicional. ¿Por qué es importante la detección sin NMS? Los sistemas tradicionales de detección de objetos suelen generar múltiples cuadros candidatos para un mismo objeto. El sistema NMS se encarga entonces de eliminar las predicciones redundantes. Aunque NMS funciona bien,
Introducción: OpenAI ha anunciado una interesante actualización para desarrolladores de IA y equipos empresariales. La versión oficial de GPT 6.1 ofrece importantes mejoras de rendimiento a una fracción del coste anterior. Con este nuevo modelo de OpenAI, los usuarios obtienen inteligencia de alto nivel sin pagar precios elevados. El nuevo sistema ChatGPT Sol 6.1 está diseñado para gestionar sin problemas la codificación compleja, el análisis de documentos y los flujos de trabajo automatizados, manteniendo bajos los costes computacionales. ¿Qué es ChatGPT-6.1 Sol y por qué es importante? GPT-6.1 Sol está diseñado para organizaciones que necesitan ejecutar cargas de trabajo de IA sofisticadas de forma repetida. En lugar de utilizar el modelo más potente para cada tarea, las empresas pueden usar Sol para flujos de trabajo que requieren un razonamiento sustancial, codificación, uso de herramientas o interacción con la computadora, manteniendo al mismo tiempo los costos operativos más bajos. OpenAI describe a GPT-6.1 Sol como un sistema que ofrece un rendimiento similar al de Astra para tareas complejas a un menor coste. Entre los principales beneficios se incluyen: Codificación compleja: Útil para el desarrollo de software, la depuración, la refactorización y las tareas de ingeniería de varios pasos. Uso del ordenador: Puede interactuar con entornos informáticos y aplicaciones web compatibles. Agentes de IA: Adecuados para flujos de trabajo que requieren múltiples herramientas y acciones. Procesamiento de contexto extenso: Admite hasta 1.05 millones de tokens de contexto. Costes de API más bajos: El precio estándar es de 2 dólares por millón de tokens de entrada y de 10 dólares por millón de tokens de salida. Razonamiento avanzado: Admite niveles de esfuerzo de razonamiento bajo, medio, alto, extra alto y máximo. Automatización empresarial: Puede gestionar flujos de trabajo profesionales con gran cantidad de documentos y múltiples pasos. Flujos de trabajo multiagente: GPT-6.1 Sol también admite capacidades multiagente en versión beta. Lea también: Lista de verificación de implementación de agentes de IA para industrias reguladas GPT-6.1 Sol vs GPT-6 Astra vs GPT-6 Luna Uno de los cambios más importantes en la familia GPT-6 es que OpenAI ahora proporciona diferentes modelos para diferentes requisitos de carga de trabajo. GPT-6 Astra se posiciona como el modelo más capaz para el razonamiento exigente y el trabajo profesional. GPT-6.1 Sol está diseñado para trabajos complejos en los que las organizaciones también necesitan gestionar los costes. GPT-6 Luna está optimizado para cargas de trabajo de alto volumen y sensibles al coste. Característica GPT-6 Astra GPT-6.1 Sol GPT-6 Luna Enfoque principal Inteligencia máxima Trabajo complejo + eficiencia de costos Eficiencia de alto volumen Entrada / 1M tokens $10 $2 $0.10 Salida / 1M tokens $50 $10 $0.50 Ventana de contexto 1.05M 1.05M 1.05M Salida máxima 128K 128K 128K Codificación compleja Excelente Excelente Bueno Uso de computadora Sí Sí Sí Búsqueda web Sí Sí Sí Búsqueda de archivos Sí Sí Sí Más adecuado para Tareas profesionales y de razonamiento más difíciles Flujos de trabajo recurrentes complejos Automatización de alto volumen Los precios y las capacidades se basan en la documentación del modelo actual de OpenAI. La diferencia de precios es particularmente significativa. El precio de entrada estándar de GPT-6.1 Sol es una quinta parte del de GPT-6 Astra, mientras que su precio de salida también es una quinta parte. El coste de entrada en caché es de 0.10 dólares por millón de tokens, en comparación con 1.00 dólar para Astra. Esto hace que Sol sea particularmente interesante para aplicaciones que ejecutan miles o millones de interacciones de modelos. Lea también: Análisis de GPT 5.6 de OpenAI: ¿Qué hace diferente a esta nueva generación? Desglose del rendimiento, la velocidad y el coste de las tareas Para comprender el valor de la versión GPT 6.1, es necesario analizar tanto el precio estándar de los tokens como los costes reales de ejecución de las tareas. Según la documentación oficial de OpenAI, ChatGPT Sol 6.1 establece sus tarifas estándar de API en 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida, con un descuento para las entradas almacenadas en caché de tan solo 0.10 dólares por millón de tokens. Sin embargo, la evaluación independiente realizada por Artificial Analysis desglosa cómo estos costos y velocidades de salida escalan en las 5 configuraciones de esfuerzo de razonamiento del modelo: Velocidad de salida y latencia: La configuración más rápida para ChatGPT Sol 6.1 es el nivel de esfuerzo de razonamiento máximo, que entrega 64 tokens por segundo (t/s). El esfuerzo alto alcanza las 58 t/s, el esfuerzo bajo llega a las 54 t/s, mientras que el esfuerzo extra alto y el esfuerzo medio operan a 53 t/s. Para necesidades de respuesta rápida, el nivel de bajo esfuerzo proporciona la latencia más baja, generando el primer token en tan solo 3.11 segundos. Coste por tarea (índice de análisis artificial): En función de la intensidad del razonamiento, los gastos por tarea aumentan hasta 5.5 veces. El modo de bajo esfuerzo es el más económico, con un coste de 0.13 dólares por tarea; este aumenta a 0.21 dólares para el modo medio, 0.32 dólares para el modo alto, 0.39 dólares para el modo extra alto y alcanza un máximo de 0.72 dólares por tarea para el modo de máximo esfuerzo. En comparación con GPT-6 Astra, estos niveles de rendimiento ofrecen a los desarrolladores un control detallado sobre la velocidad de ejecución y el gasto operativo exacto por flujo de trabajo del agente. Índice de Inteligencia de Análisis Artificial vs. Coste por tarea, que muestra el posicionamiento de ChatGPT Sol 6.1 en el cuadrante más atractivo en comparación con GPT-6 Astra. Fuente: ChatGPT Sol 6.1 tabla comparativa de inteligencia vs coste por Artificial Analysis GPT-6.1 Sol vs el GPT-6 Sol original GPT-6.1 Sol también es una evolución del modelo GPT-6 Sol anterior. Los precios estándar de entrada y salida se mantienen en 2 y 10 dólares por millón de tokens, respectivamente, pero la entrada en caché ahora cuesta 0.10 dólares por millón de tokens, en comparación con los 0.20 dólares del GPT-6 Sol original. Y lo que es más importante, OpenAI informa de mejoras en el rendimiento de la codificación y el uso de los ordenadores. Por ejemplo, los informes de la comunidad de desarrolladores de OpenAI sobre el lanzamiento citan una puntuación DeepSWE v1.1 del 75.2 % para GPT-6.1 Sol con un alto esfuerzo de razonamiento, en comparación con el 68.8 % para GPT-6 Sol con el máximo esfuerzo de razonamiento. En la evaluación de AutomationBench citada, GPT-6.1 Sol obtuvo una puntuación del 31.7% con un esfuerzo de razonamiento medio. Estos resultados de referencia no deben interpretarse como una garantía de que Sol superará a todos los demás modelos en todas las tareas del mundo real. El rendimiento real depende en gran medida de las indicaciones, las herramientas, la configuración de razonamiento y el flujo de trabajo específico. Aplicaciones en el mundo real del nuevo modelo de OpenAI: GPT-6.1 Sol La mayor oportunidad para GPT-6.1 Sol no reside simplemente en hacerle preguntas al modelo. Su combinación de razonamiento, codificación, contexto amplio y uso de herramientas lo hace adecuado para aplicaciones empresariales de varios pasos. 1. GPT-6.1 Sol, para el desarrollo de software con IA, puede utilizarse como asistente de ingeniería de IA para: escribir código de aplicación, depurar software, refactorizar grandes bases de código, generar pruebas unitarias, revisar solicitudes de extracción, explicar sistemas heredados, crear integraciones de API y automatizar tareas de desarrollo repetitivas. Por ejemplo, un equipo de desarrollo podría darle a Sol una especificación de producto y pedirle que cree la estructura inicial de la aplicación, escriba puntos finales de backend, genere pruebas e identifique problemas de implementación. Para problemas de ingeniería extremadamente difíciles, los equipos aún pueden optar por Astra. Para trabajos de desarrollo repetitivos donde el coste es importante, Sol ofrece otra opción. 2. Los agentes de soporte al cliente basados en IA (GPT-6.1 Sol) también se pueden utilizar para crear agentes de soporte al cliente que combinen la documentación de la empresa con herramientas externas. Un agente de soporte podría: Recibir una solicitud del cliente. Buscar en la empresa
Introducción Las empresas tecnológicas compiten por desarrollar modelos utilizados para chatear y generar texto. Sin embargo, la aparición del modelo de IA Jev, desarrollado por TypeSafe AI, cambió las reglas al ofrecer un camino diferente. Si crees que todos los modelos de IA están diseñados para hablar contigo como ChatGPT o Claude, este artículo cambiará tu perspectiva sobre el software moderno. El verdadero problema: ¿Por qué se creó el modelo de IA para la toma de decisiones en primer lugar? Las empresas que desarrollaban agentes de IA se enfrentaban a un enorme obstáculo financiero y técnico conocido como costes de inferencia. Cuando un desarrollador crea un sistema automatizado para gestionar el servicio al cliente o ejecutar código, el sistema necesita tomar docenas de decisiones pequeñas y repetitivas: ¿Es urgente este ticket o no? ¿Qué herramienta de software debería elegir el agente ahora mismo? ¿Es segura la acción que el código está a punto de realizar? Las empresas solían depender de modelos de lenguaje (LLM, por sus siglas en inglés) grandes y costosos para responder a estas preguntas sencillas. Los resultados no requerían escribir un ensayo ni un texto creativo, solo una Decisión Estructurada. Este derroche de energía y costes provocó que muchos proyectos de IA se detuvieran antes de su finalización. Aquí es donde Diogo Almeida (cofundador de la empresa y antiguo investigador de OpenAI que contribuyó a la investigación de InstructGPT) concibió su idea principal: la IA no siempre necesita hablar en lenguaje humano para tener un impacto real dentro del software. ¿Por qué TypeSafe AI Design Jev fue diferente? El sistema funciona bajo un concepto conocido como Modelo de Sistema Uno (un sistema de pensamiento rápido y directo). Estas son las diferencias clave entre este y los modelos tradicionales: Característica Modelos de lenguaje tradicionales (LLM) Modelo de IA Jev Objetivo principal Generación de texto y razonamiento abierto Toma de decisiones rápida y estructurada Método de respuesta Predicción de la siguiente palabra (autorregresivo) Cálculo de probabilidades de salida directa Interfaz Lenguaje natural y chat (chatbot) Puntuaciones de confianza y probabilidades Costo y velocidad Costo más alto y tiempo de respuesta más lento Costo bajo y extremadamente rápido Lea también: Lanzamiento del modelo Jev: ¿Cómo cambia el juego para los ingenieros de IA? ¿Cómo funciona Jev? ¿Y por qué no responde al lenguaje natural? No se puede abrir una ventana de chat y escribirle al modelo como en otros sistemas, ya que no responde al lenguaje natural. En cambio, recibe entradas de texto junto con categorías predefinidas (Categorías y Tipos). Luego, calcula las probabilidades matemáticas de obtener el resultado correcto y lo devuelve con una "Puntuación de confianza" cuidadosamente ponderada. ¿Por qué se diseñó Jev sin chat? El sistema se basa en la idea de crear una IA para la toma de decisiones que permita elegir rápidamente. Predice las probabilidades matemáticas de obtener el resultado correcto y le proporciona una puntuación de confianza en lugar de generar texto libre. Este mecanismo permite a las empresas reducir el despilfarro financiero y lograr un rendimiento excepcional en entornos de software complejos. ¿Cómo se entrenó este modelo? (Técnica RLCD) Fue entrenado utilizando un método innovador llamado Aprendizaje por Refuerzo para Decisiones Calibradas (RLCD). Esta técnica garantiza que los índices de confianza no reflejen simplemente conjeturas superficiales. En cambio, expresan probabilidades matemáticas precisas que muestran cuán correcta es una decisión antes de tomarla, lo que las convierte en una opción ideal para sistemas construidos con código directo (IA nativa de máquina). Ejemplo práctico: ¿Cómo toma decisiones el sistema? Para simplificar la imagen, imaginemos que un servidor de software falla repentinamente dentro de una empresa. Un agente automatizado interviene para solucionar el problema. Antes de escribir cualquier código, debe determinar 3 elementos: Elegir la habilidad de software adecuada para el problema. Identifique los archivos de referencia más importantes para el caso. Envíe el resultado al equipo responsable de los fallos del sistema. Los modelos tradicionales analizan el problema y redactan un informe completo explicando sus razones, lo que consume tiempo y dinero. En cambio, el modelo de IA de Jev funciona de forma directa; lee texto en lenguaje natural y devuelve el resultado únicamente como códigos y datos específicos, sin generar informes extensos. El próximo cambio en la automatización empresarial. Este proyecto no fue creado para ser simplemente otra herramienta nueva para hablar o escribir textos creativos. Surgió para solucionar un problema real que preocupaba a los desarrolladores de software: el coste financiero y la velocidad operativa. Confiar en la IA para la toma de decisiones representa la base fundamental para el futuro de los sistemas autónomos. Los modelos técnicos están pasando de herramientas de chat interactivas a motores silenciosos que operan en segundo plano dentro del software. La innovación aportada por TypeSafe AI demostró que el verdadero valor de la tecnología no reside en lo bien que imita el habla humana, sino en su capacidad para tomar las decisiones correctas de la forma más rápida y económica posible. Esto transformará la forma en que se desarrollan las aplicaciones inteligentes en los próximos años. Referencias para lectura adicional Documentación oficial de TypeSafe AI Visite nuestro servicio de recopilación de datos Visite ahora
Introducción Los ingenieros de IA están creando cada vez más sistemas que combinan grandes modelos de lenguaje (LLM, por sus siglas en inglés), agentes de IA, lógica de software tradicional y modelos especializados de aprendizaje automático. Sin embargo, no todas las tareas requieren un modelo para generar texto o realizar razonamientos complejos. Aquí es donde el modelo Jev de TypeSafe AI introduce un enfoque diferente. Diseñado como un modelo de primera generación del Sistema 1 para la automatización de software, Jev se centra en tomar decisiones rápidas y estructuradas en lugar de generar texto de formato libre. Al devolver resultados, probabilidades y puntuaciones de confianza predefinidos, Jev está diseñado para aplicaciones como enrutamiento, clasificación, verificación, mecanismos de control y toma de decisiones en tiempo real. Su arquitectura de muestreo paralelo también está diseñada para reducir la latencia de la inferencia y hacer que los flujos de trabajo de IA de gran volumen sean más eficientes. Entonces, ¿qué es exactamente el modelo Jev, cómo funciona y qué podría significar para los ingenieros de IA que están creando la próxima generación de agentes de IA? Un vistazo a las últimas actualizaciones de IA: Lanzamiento del modelo Jev de TypeSafe AI TypeSafe AI anunció el lanzamiento de su primer modelo avanzado llamado Jev. Se trata de la primera generación de modelos System One diseñados específicamente para la automatización de software. Toma decisiones rápidas y estructuradas con el mismo nivel de inteligencia que los Modelos de Lenguaje a Gran Escala (LLM, por sus siglas en inglés), pero con un mecanismo operativo completamente diferente. Características clave del modelo Jev que elimina cadenas no estructuradas para obtener resultados con tipos seguros: El modelo no genera texto libre. En cambio, recibe datos no estructurados y produce valores estructurados predefinidos junto con puntuaciones de probabilidad y confianza. Este enfoque está diseñado para reducir los errores tipográficos y los riesgos de alucinaciones mediante un marco de software. Arquitectura de muestreo paralelo: en lugar de generar texto token por token de forma secuencial, el modelo produce resultados a través de una arquitectura de consulta paralela. TypeSafe AI afirma que esto puede reducir la latencia de respuesta a aproximadamente 70-500 ms, dependiendo de la tarea. Algoritmo de entrenamiento (RLCD): El modelo se basa en un método de entrenamiento llamado Aprendizaje por Refuerzo para Decisiones Calibradas (RLCD), en lugar de los enfoques tradicionales de RLHF. El enfoque se centra en la toma de decisiones estructurada, en lugar de en respuestas informales. Costo y velocidad: Datos de entrada: $0.042 por millón de tokens. Datos de salida: $0.00. Por qué Jev podría ser importante para los agentes de IA En el desarrollo de sistemas de IA, los ingenieros suelen utilizar grandes modelos generativos para tareas que en realidad no requieren la generación de texto. Un agente de IA puede necesitar un modelo de lenguaje natural (LLM) para razonar sobre un problema complejo, pero el siguiente paso podría requerir simplemente responder a una pregunta sencilla como: ¿Debería el sistema guardar este archivo? Si o no. El uso de un modelo generativo grande para cada decisión pequeña puede introducir latencia adicional, consumo de tokens y complejidad en el procesamiento de la salida. Jev está diseñado para solucionar esta deficiencia, proporcionando decisiones estructuradas que pueden integrarse directamente en los flujos de trabajo del software. 1. El impuesto oculto de los modelos generativos Al crear agentes de IA, un sistema podría usar un modelo de razonamiento extenso para generar código complejo o analizar un problema y luego usar otra llamada al modelo simplemente para determinar la siguiente acción. Por ejemplo: ¿Debe el agente guardar el archivo? ¿Debe la solicitud dirigirse a un humano? ¿Es esta entrada potencialmente maliciosa? ¿Debe invocarse otro modelo de IA? Estas decisiones no requieren necesariamente una respuesta textual extensa. Generar texto extenso o JSON para una decisión booleana simple puede aumentar el consumo de tokens e introducir problemas de validación de salida. Los ingenieros también pueden necesitar ingeniería de urgencia adicional, lógica de análisis, mecanismos de reintento y manejo de errores. Un modelo de decisión estructurado ofrece una arquitectura alternativa para estas situaciones. 2. ¿Por qué las alternativas tradicionales también pueden generar problemas? Cuando los equipos quieren reducir el coste y la latencia de los modelos generativos, pueden recurrir a modelos de clasificación más pequeños, como BERT o DeBERTa. Estos modelos pueden ser eficaces para tareas de clasificación, pero la implementación y el mantenimiento de modelos especializados pueden introducir requisitos adicionales, entre ellos: el etiquetado continuo de datos. Pipelines de entrenamiento específicos para cada modelo. Seguimiento y recapacitación. Manejo de la deriva de datos. Mantener modelos separados para diferentes tareas de toma de decisiones. El enfoque de Jev está diseñado para proporcionar una toma de decisiones estructurada sin que los ingenieros tengan que construir un modelo separado para cada decisión simple. Arquitectura técnica: Cómo funciona Jev Uno de los conceptos clave detrás de Jev es la distinción entre el procesamiento del Sistema 1 y el del Sistema 2. Los sistemas de IA generativa suelen realizar una generación autorregresiva, prediciendo un token tras otro. Jev, en cambio, se centra en evaluar directamente un estado de entrada en función de preguntas predefinidas y posibles resultados. 1. Para romper el bucle autorregresivo, en lugar de predecir el siguiente token a partir de un vocabulario muy extenso, Jev restringe las posibles salidas antes de que comience la inferencia. Esto permite que el modelo se centre en la decisión en sí misma en lugar de generar una explicación textual. 2. Tres tipos de preguntas específicas Jev evalúa los estados de entrada utilizando tres tipos principales de preguntas estructuradas: Elección: Seleccionar una opción de una lista cerrada de hasta 255 opciones y devolver una puntuación de confianza. Puntuación: Evaluación de un estado en una escala graduada, como por ejemplo la determinación de un nivel de riesgo. Nulo/Booleano: Devuelve una probabilidad entre 0.0 y 1.0 para una decisión lógica como verdadero o falso. 3. Distribución especulativa: El estado de entrada se puede codificar una sola vez en la memoria de la GPU, mientras que se procesan en paralelo varias preguntas específicas. Esta arquitectura implica que evaluar varias preguntas puede tener un perfil de latencia similar al de evaluar una sola pregunta, dependiendo de la implementación y la carga de trabajo. Para los ingenieros de IA, esto podría ser particularmente útil cuando una aplicación necesita tomar varias decisiones sobre la misma entrada antes de continuar su flujo de trabajo. Casos de uso directos para el modelo Jev La arquitectura estructurada de Jev lo hace potencialmente útil para diversas aplicaciones de ingeniería de IA. Las reglas de decisión inteligentes de Jev se pueden utilizar para decisiones de software que tradicionalmente dependerían de una lógica compleja de tipo if/else. Algunos ejemplos son: solicitudes de enrutamiento. Clasificación de entradas. Selección de flujos de trabajo. Priorizar tareas. Determinar si se debe ejecutar una acción. Aplicaciones en tiempo real: Las aplicaciones que requieren respuestas rápidas pueden beneficiarse de una toma de decisiones con menor latencia. Entre las posibles aplicaciones se incluyen la toma de decisiones en tiempo real sobre el estado del juego, los sistemas interactivos y otras aplicaciones en las que esperar a que un modelo generativo grande complete una respuesta crearía una demora innecesaria. Procesamiento de Big Data. La arquitectura paralela también podría ser útil para procesar grandes volúmenes de datos. En los flujos de trabajo de estilo MapReduce, las organizaciones podrían utilizar decisiones de IA estructuradas para convertir grandes conjuntos de datos en características, clasificaciones o señales predefinidas. Barandillas y verificación Otra posible aplicación

Introducción. La IA visual está yendo más allá de la simple detección de objetos y la clasificación de imágenes. Hoy en día, se espera que los sistemas de IA comprendan la información visual, tomen decisiones, interactúen con otras herramientas y completen tareas con una mínima intervención humana. Este cambio está generando demanda de flujos de trabajo de IA visual más flexibles e inteligentes. En lugar de construir cada componente por separado, los desarrolladores y las empresas necesitan formas de conectar los modelos de visión artificial con el razonamiento, la automatización, el procesamiento de datos y las herramientas externas. Aquí es donde entran en juego los agentes de Ultralytics. Al combinar las capacidades de visión artificial con flujos de trabajo basados en agentes, Ultralytics Agents ofrece una forma de crear aplicaciones de IA visual que pueden analizar información, tomar medidas y automatizar procesos complejos de manera más eficiente. ¿Qué son los agentes Ultralytics? Ultralytics es ampliamente conocida por su familia de modelos de visión artificial YOLO, que se utilizan para tareas como la detección de objetos, la segmentación de imágenes, la estimación de pose, la clasificación y el seguimiento. Los agentes de Ultralytics extienden este ecosistema centrado en la visión hacia flujos de trabajo de IA donde los modelos pueden hacer más que simplemente devolver predicciones. Un agente de IA puede diseñarse para: comprender una tarea u objetivo, analizar información visual, usar modelos de visión artificial, procesar los resultados del modelo, interactuar con herramientas o aplicaciones, tomar decisiones basadas en flujos de trabajo predefinidos, activar acciones automáticamente y trabajar a través de procesos de varios pasos. Esto crea un puente entre la visión artificial y la automatización inteligente. Por ejemplo, en lugar de simplemente detectar un vehículo en una imagen, un flujo de trabajo de IA visual podría identificar el vehículo, determinar su ubicación, rastrearlo a través de múltiples fotogramas, analizar información adicional y activar una acción en función del resultado. ¿Por qué los flujos de trabajo de IA visual se están volviendo más complejos? Las aplicaciones tradicionales de visión artificial suelen seguir una secuencia relativamente sencilla: Entrada → Modelo → Predicción → Salida. Para muchas aplicaciones, este enfoque funciona bien. Pero los sistemas de IA del mundo real a menudo requieren pasos adicionales. Consideremos una aplicación para la monitorización de almacenes. Un modelo podría detectar trabajadores, carretillas elevadoras, paquetes y zonas restringidas. Sin embargo, la detección por sí sola puede no ser suficiente. Un flujo de trabajo completo podría necesitar: Detectar objetos en una transmisión de video. Rastrea los objetos a través de los fotogramas. Determinar si una persona ha entrado en una zona restringida. Comprueba la duración del evento. Registre la información relevante. Avise a un operador. Almacene el evento para su posterior análisis. El modelo de visión artificial es solo una parte del sistema general. Por eso, las aplicaciones modernas de IA visual requieren cada vez más flujos de trabajo en lugar de modelos independientes. De los modelos de visión artificial a los agentes de IA: Los agentes de IA introducen otra capa de inteligencia en torno a los modelos. En lugar de tratar un modelo de visión artificial como un componente aislado, un flujo de trabajo basado en agentes puede utilizar los resultados del modelo como parte de un proceso de toma de decisiones más amplio. Por ejemplo: Transmisión de cámara → Modelo de visión → Agente → Decisión → Acción El modelo de visión proporciona información sobre lo que está sucediendo. El agente puede entonces utilizar esa información dentro de un flujo de trabajo para determinar qué debe suceder a continuación. Esta arquitectura puede resultar especialmente útil cuando las aplicaciones implican múltiples pasos, herramientas o condiciones. Ejemplo: Monitoreo de seguridad automatizado. Imagine una instalación industrial donde las cámaras monitorean las áreas de trabajo. Un flujo de trabajo de IA visual podría detectar: Trabajadores Equipos de seguridad Vehículos Zonas restringidas Peligros potenciales El agente podría luego evaluar la información detectada comparándola con reglas predefinidas. Si un trabajador ingresa a un área restringida sin el equipo de seguridad requerido, el flujo de trabajo podría: Crear un registro de incidente Capturar evidencia relevante Notificar al equipo apropiado Asignar una prioridad Almacenar el evento para una revisión posterior En lugar de requerir que un humano supervise continuamente cada cámara, el sistema puede automatizar partes del proceso de monitoreo. Beneficios clave de la IA visual basada en agentes 1. Desarrollo de flujos de trabajo más rápidos. Crear una aplicación de IA sofisticada desde cero puede requerir un esfuerzo de ingeniería considerable. Es posible que los desarrolladores necesiten integrar: modelos de visión artificial, API, bases de datos, lógica empresarial, herramientas de automatización, sistemas de monitorización y servicios de notificación. Los enfoques basados en agentes pueden simplificar la forma en que se conectan estos componentes, lo que ayuda a los equipos a pasar de una idea a un flujo de trabajo funcional más rápidamente. 2. Automatización en varios pasos Muchas aplicaciones de IA visual no son problemas de un solo paso. Un agente puede ayudar a coordinar múltiples operaciones dentro del mismo flujo de trabajo. Por ejemplo: Detectar → Analizar → Verificar → Decidir → Actuar Esto puede reducir la cantidad de orquestación manual necesaria entre los componentes individuales. 3. Mejor uso de los datos visuales Las organizaciones generan enormes cantidades de información visual a través de cámaras, inspecciones, imágenes médicas, vehículos autónomos, sistemas de venta minorista y otras aplicaciones. El reto no consiste simplemente en recopilar estos datos. Se trata de convertirla en información útil y en acciones concretas. Los flujos de trabajo de IA visual pueden ayudar a las organizaciones a pasar de: Datos visuales sin procesar → Información → Decisiones → Acciones 4. Integración flexible. Las aplicaciones del mundo real rara vez funcionan de forma aislada. Un flujo de trabajo de IA visual puede necesitar comunicarse con bases de datos, API, paneles de control, sistemas de alerta o aplicaciones empresariales internas. Una arquitectura basada en agentes puede proporcionar una capa flexible para conectar estos diferentes componentes. 5. La automatización de flujos de trabajo con intervención humana no siempre implica eliminar a los humanos del proceso. Para aplicaciones delicadas o complejas, la IA puede identificar los casos relevantes y enviarlos a expertos humanos para su revisión. Por ejemplo: la IA detecta → la IA evalúa → un humano verifica → el sistema registra el resultado. Este enfoque puede ser valioso cuando la precisión, el cumplimiento o la seguridad son fundamentales. Casos de uso para los agentes de Ultralytics: La combinación de visión artificial y flujos de trabajo basados en agentes puede dar soporte a una amplia gama de aplicaciones. Vehículos autónomos. Los sistemas de conducción autónoma procesan grandes volúmenes de información visual procedente de cámaras y otros sensores. Los flujos de trabajo de IA visual pueden ayudar con tareas como: detección de objetos, seguimiento de vehículos y peatones, comprensión de escenas viales, monitoreo de tráfico, detección de eventos y validación de datos. Los agentes pueden ayudar a coordinar estas salidas y conectarlas con sistemas posteriores. Las fábricas pueden utilizar la visión artificial para supervisar las líneas de producción e identificar anomalías. Los posibles flujos de trabajo incluyen: Inspección de productos Detección de defectos Monitoreo de seguridad del trabajador Monitoreo de equipos Seguimiento de inventario Análisis de producción En lugar de simplemente identificar un producto defectuoso, un flujo de trabajo automatizado podría marcar el artículo, registrar el defecto, notificar a un operador y actualizar el sistema de producción correspondiente. Los minoristas pueden utilizar la IA visual para comprender la actividad dentro de las tiendas. Las aplicaciones pueden incluir: análisis del movimiento de clientes, monitoreo de estantes, detección de productos, monitoreo de inventario, análisis de colas, prevención de pérdidas. Un agente puede conectar información visual con sistemas empresariales para respaldar respuestas automatizadas. Las imágenes médicas en el ámbito sanitario representan otra área donde la visión
Introducción La visión artificial sigue avanzando hacia modelos que no solo son más precisos, sino también más rápidos, más fáciles de implementar y capaces de gestionar múltiples tareas de visión a través de un marco unificado. En 2026, uno de los desarrollos más importantes en el ecosistema de Ultralytics es YOLO26, la última familia de modelos YOLO de Ultralytics. Lanzado en enero de 2026, YOLO26 introduce inferencia nativa de extremo a extremo, un cabezal de detección más ligero, técnicas de entrenamiento actualizadas y compatibilidad con una amplia gama de tareas de visión artificial. Para las organizaciones que desarrollan productos basados en IA, YOLO26 resulta especialmente interesante porque aborda un desafío importante en la visión artificial aplicada a la producción: cómo lograr una alta precisión sin que la implementación sea innecesariamente compleja o computacionalmente costosa. Esta guía explica todo lo que necesita saber sobre Ultralytics YOLO Vision en 2026, con especial atención a YOLO26, su arquitectura, capacidades, rendimiento, flujo de trabajo de capacitación, opciones de implementación, casos de uso y diferencias con respecto a YOLO11. ¿Qué es Ultralytics YOLO? YOLO significa You Only Look Once (Solo miras una vez) y se refiere a una familia de modelos de visión artificial en tiempo real diseñados para procesar información visual de manera eficiente. A diferencia de los sistemas tradicionales de visión artificial, que pueden requerir múltiples etapas para identificar y localizar objetos, YOLO aborda la detección de objetos como un problema de predicción unificado. Con el paso de los años, el ecosistema YOLO se ha expandido más allá de la detección básica de objetos. Los modelos modernos de Ultralytics pueden admitir: detección de objetos, segmentación de instancias, segmentación semántica, clasificación de imágenes, estimación de pose, detección de cuadros delimitadores orientados, estimación de profundidad, seguimiento, detección y segmentación de vocabulario abierto. Ultralytics proporciona estas capacidades a través de un paquete común de Python y una interfaz de línea de comandos, lo que facilita a los desarrolladores y a los equipos de aprendizaje automático el entrenamiento, la evaluación, la implementación y la gestión de modelos de visión. ¿Qué es YOLO26? YOLO26 es la última familia de modelos YOLO de Ultralytics, lanzada en enero de 2026. Está diseñado en torno a cuatro áreas principales de mejora: Inferencia nativa de extremo a extremo Un cabezal de detección más ligero Una nueva receta de entrenamiento Mejoras específicas de la tarea para diferentes problemas de visión artificial Uno de sus cambios más significativos es que YOLO26 utiliza un cabezal de detección uno a uno por defecto, lo que permite que el modelo produzca detecciones finales sin la supresión no máxima (NMS) tradicional como un paso de posprocesamiento separado. Esto es importante porque la NMS tradicionalmente ha sido una etapa separada en los procesos de detección de objetos. Eliminarlo de la ruta de inferencia predeterminada puede simplificar la implementación y reducir la sobrecarga del posprocesamiento. Lea: YOLO26: La próxima evolución de la visión artificial en tiempo real. Por qué YOLO26 es importante en 2026. La evolución de la visión artificial se centra cada vez más en la implementación práctica en lugar de solo en el rendimiento de referencia. Un modelo puede tener una precisión excelente, pero aun así ser difícil de usar en un entorno de producción si: requiere hardware costoso, tiene una alta latencia de inferencia, necesita un posprocesamiento complicado, es difícil de exportar, funciona mal en dispositivos periféricos o requiere modelos separados para diferentes tareas de visión. YOLO26 aborda varios de estos desafíos. Según los datos de referencia publicados por Ultralytics, los modelos de detección YOLO26 varían entre 40.9 y 57.5 mAP en COCO, dependiendo del tamaño del modelo, con una latencia T4 TensorRT reportada de aproximadamente 1.7 ms a 11.8 ms. El modelo YOLO26n, el más pequeño, también presenta una velocidad de inferencia ONNX de CPU de 38.9 ms, en comparación con los 56.1 ms del YOLO11n en las condiciones de referencia documentadas. Ultralytics informa de una inferencia ONNX de CPU hasta un 43 % más rápida para YOLO26n en comparación con YOLO11n en una CPU Intel Xeon bajo su configuración de referencia. Características principales de YOLO26 1. Inferencia nativa de extremo a extremo Uno de los mayores cambios en YOLO26 es su arquitectura de detección nativa de extremo a extremo. Los modelos tradicionales de detección de objetos pueden producir muchas predicciones superpuestas. A continuación, se aplica el método NMS para eliminar las predicciones redundantes y seleccionar las detecciones finales. El cabezal de detección uno a uno predeterminado de YOLO26 está diseñado para producir predicciones finales directamente, eliminando la necesidad de NMS externo durante la inferencia estándar. Esto puede proporcionar varias ventajas: Pipelines de inferencia más simples Procesamiento posterior reducido Implementación más sencilla Ejecución más predecible en todas las plataformas Menor latencia Para las aplicaciones de IA en el borde, estas mejoras pueden ser particularmente valiosas. 2. La regresión sin DFL de YOLO26 elimina la pérdida focal de distribución (DFL) de su cabezal de detección. El objetivo es simplificar la arquitectura de detección manteniendo un enfoque eficaz para la regresión de cuadros delimitadores. Un cabezal de detección más sencillo también puede facilitar la exportación y el despliegue del modelo, especialmente cuando se trabaja en entornos con requisitos estrictos de compatibilidad computacional o gráfica. 3. El optimizador MuSGD YOLO26 introduce MuSGD, un enfoque de optimización híbrido que combina ideas de SGD y de optimización al estilo de muones. La receta de entrenamiento oficial utiliza MuSGD para los puntos de control YOLO26 entrenados en COCO. Ultralytics informa que los modelos fueron entrenados con una resolución de 640×640 y un tamaño de lote de 128. Esto ilustra una dirección importante en el desarrollo de la IA moderna: las técnicas de optimización originalmente asociadas con otras cargas de trabajo de aprendizaje profundo se están adaptando cada vez más a la visión artificial. 4. YOLO26 utiliza la función de pérdida progresiva para alinear mejor el entrenamiento con el comportamiento del modelo durante la inferencia. El objetivo es centrar la formación de forma más eficaz en el cabezal de predicción que se utilizará realmente durante el despliegue. Esto puede ayudar a reducir la discrepancia entre cómo se optimiza un modelo durante el entrenamiento y cómo funciona durante la inferencia en el mundo real. 5. Asignación de etiquetas teniendo en cuenta el tamaño del objetivo. Detectar objetos pequeños es un desafío común en la visión por computadora. YOLO26 introduce la asignación de etiquetas con reconocimiento de objetivos pequeños (STAL, por sus siglas en inglés) para mejorar la cobertura de etiquetas positivas para objetos pequeños. Esto puede ser particularmente relevante para aplicaciones que involucran: Cámaras de tráfico Imágenes de drones Vigilancia Imágenes satelitales Inspección de fabricación Análisis minorista Los objetos pequeños a menudo ocupan solo un pequeño porcentaje de una imagen, lo que hace que sean difíciles de detectar de manera confiable. Tamaños del modelo YOLO26 YOLO26 está disponible en cinco tamaños de detección principales: Parámetros del modelo FLOPs COCO mAP CPU ONNX T4 TensorRT YOLO26n 2.4M 5.4B 40.9 38.9 ms 1.7 ms YOLO26s 9.5M 20.7B 48.6 87.2 ms 2.5 ms YOLO26m 20.4M 68.2B 53.1 220.0 ms 4.7 ms YOLO26l 24.8M 86.4B 55.0 286.2 ms 6.2 ms YOLO26x 55.7M 193.9B 57.5 525.8 ms 11.8 ms Las cifras anteriores son los resultados de referencia publicados por Ultralytics y deben tratarse como mediciones de referencia en lugar de garantías para cada configuración de hardware. ¿Qué modelo de YOLO26 debería elegir? YOLO26n: Ideal cuando las prioridades son la baja capacidad de procesamiento, el tamaño reducido del modelo y el despliegue en el borde de la red. YOLO26s: Una excelente opción cuando se necesita un equilibrio entre eficiencia y precisión. YOLO26m: Adecuado para aplicaciones donde una mayor precisión justifica un mayor esfuerzo de cálculo. YOLO26l: Diseñado para cargas de trabajo exigentes que requieren mayor precisión. YOLO26x: Más adecuado para escenarios donde
Introducción El campo de la visión por computadora está evolucionando más rápido que nunca. Los modelos tradicionales de detección de objetos ya no son suficientes para muchas aplicaciones modernas de IA. Actualmente, las organizaciones requieren sistemas capaces de identificar objetos nunca antes vistos, comprender contextos visuales y realizar una localización precisa sin necesidad de un extenso proceso de reentrenamiento. Este cambio ha propiciado la aparición de modelos innovadores como NVIDIA LocateAnything, que desafía los marcos de detección de objetos establecidos, como YOLO (You Only Look Once). A medida que las empresas desarrollan sistemas de IA más inteligentes para la robótica, los vehículos autónomos, la atención médica, el análisis de datos en el sector minorista y la automatización industrial, elegir el modelo de visión adecuado se vuelve cada vez más importante. Entonces, ¿cómo se compara NVIDIA LocateAnything con YOLO? ¿Qué modelo se adapta mejor a sus necesidades en 2026? Analicemos en detalle la comparación. Comprender NVIDIA LocateAnything NVIDIA LocateAnything es un modelo de visión fundamental diseñado para localizar objetos dentro de las imágenes mediante indicaciones en lenguaje natural. A diferencia de los detectores de objetos tradicionales que requieren categorías predefinidas durante el entrenamiento, LocateAnything puede identificar y localizar objetos que nunca antes ha visto explícitamente. Por ejemplo, en lugar de entrenar un detector específicamente para: coches, peatones o señales de tráfico, un usuario puede simplemente proporcionar una indicación de texto como: «Localiza la caja de herramientas roja» o «Encuentra todos los productos dañados». El modelo entiende la solicitud e identifica los objetos coincidentes en la imagen. Esta capacidad se conoce como: Localización de objetos con vocabulario abierto Detección guiada por el lenguaje Comprensión visual basada en indicaciones LocateAnything representa la próxima generación de modelos de base de visión que combinan la visión por computadora y conceptos de modelos de lenguaje a gran escala. Entendiendo YOLO YOLO (You Only Look Once) sigue siendo uno de los marcos de detección de objetos más populares del mundo. Desde su introducción, YOLO se ha convertido en el estándar de la industria para la detección en tiempo real debido a su: Velocidad excepcional Baja latencia Alta precisión Fácil implementación Las versiones modernas como YOLOv11, YOLOv12 y las variantes empresariales personalizadas siguen dominando las aplicaciones que requieren una detección rápida de objetos. YOLO procesa una imagen en una sola pasada hacia adelante y genera: cuadros delimitadores, etiquetas de clase y puntuaciones de confianza. El resultado es una detección de objetos altamente eficiente, adecuada para dispositivos periféricos y entornos de producción. Diferencias arquitectónicas fundamentales La mayor diferencia radica en cómo cada modelo entiende los objetos. NVIDIA LocateAnything se basa en los principios del modelo fundamental. Aprende conceptos visuales generales y los relaciona con la comprensión del lenguaje. Las ventajas incluyen: Detección de vocabulario abierto Interacción en lenguaje natural Localización sin necesidad de ejemplos Razonamiento visual generalizado El modelo no está restringido a categorías fijas. YOLO YOLO sigue un enfoque de detección de objetos supervisada. Aprende clases de objetos específicas durante el entrenamiento. Las ventajas incluyen: Inferencia de alta velocidad Implementación ligera Procesamiento eficiente en el borde Rendimiento sólido en categorías conocidas Sin embargo, YOLO no puede identificar clases de objetos completamente nuevas sin volver a entrenar. Flexibilidad de detección La flexibilidad de detección es donde LocateAnything destaca. Consideremos un entorno de almacén. Un gerente quiere localizar: “Cajas de cartón dañadas cerca de las áreas de carga”. YOLO no puede realizar esta tarea directamente a menos que: Las cajas dañadas estén anotadas Se cree un conjunto de datos personalizado El modelo se vuelva a entrenar LocateAnything a menudo puede entender la solicitud inmediatamente a través de indicaciones de texto. Esto reduce drásticamente los costos de preparación de los conjuntos de datos. Comparación de velocidad: Cuando la velocidad importa, YOLO sigue siendo difícil de superar. Ventajas de velocidad de YOLO YOLO está optimizado para: Análisis de vídeo en tiempo real Navegación autónoma Vigilancia de seguridad Robótica industrial Los modelos modernos de YOLO pueden procesar docenas o incluso cientos de fotogramas por segundo dependiendo del hardware. Consideraciones sobre la velocidad de LocateAnything: LocateAnything prioriza la comprensión y la flexibilidad por encima de la velocidad pura. Debido a que combina el razonamiento visual y semántico, la inferencia suele ser más lenta. Para aplicaciones que requieren decisiones en cuestión de milisegundos, YOLO suele seguir siendo la opción preferida. Comparación de precisión La precisión depende en gran medida de la aplicación. Precisión de YOLO Para clases de objetos predefinidas: Vehículos Personas Animales Defectos de fabricación YOLO ofrece una excelente precisión y recuperación. Cuando se entrena con conjuntos de datos de alta calidad, YOLO puede lograr resultados de vanguardia. Precisión de LocateAnything LocateAnything destaca al tratar con: Objetos invisibles Descripciones complejas Consultas semánticas Entornos de mundo abierto El modelo puede localizar objetos que los detectores tradicionales nunca fueron entrenados para reconocer. Esto genera una ventaja significativa en entornos dinámicos. Requisitos de capacitación Uno de los factores de costo más importantes en la implementación de la IA es la anotación de datos. YOLO requiere grandes conjuntos de datos anotados, etiquetas de cuadros delimitadores, definiciones de clases y reentrenamiento para nuevas categorías. La creación de conjuntos de datos personalizados puede ser costosa y llevar mucho tiempo. LocateAnything requiere una formación mínima específica para la tarea. Indicaciones en lenguaje natural. Adaptación con pocos ejemplos. Localización sin ejemplos. Las organizaciones pueden implementar nuevos casos de uso mucho más rápido. Capacidades de segmentación y localización Los sistemas de IA modernos requieren cada vez más segmentación en lugar de simples cuadros delimitadores. LocateAnything se integra de forma natural con los sistemas de segmentación. Por ejemplo: Localizar objeto Generar máscara Realizar análisis detallado Esto lo hace altamente compatible con modelos de base como: Modelo de segmentación de cualquier cosa (SAM) Modelos de lenguaje de visión Sistemas de IA multimodales YOLO también admite variantes de segmentación, pero generalmente se basa en clases de entrenamiento predefinidas. Requisitos de hardware YOLO funciona de manera eficiente en: GPU NVIDIA Dispositivos Edge Plataformas Jetson Sistemas integrados Cámaras industriales Muchas versiones pueden ejecutarse en tiempo real en hardware modesto. LocateAnything generalmente requiere: Más memoria de GPU Recursos de computación más potentes Infraestructura de modelo básico Las organizaciones deben tener en cuenta mayores costos de infraestructura. Aplicaciones en el mundo real Mejores casos de uso para vehículos autónomos YOLO Detección rápida de: Automóviles Peatones Señales de tráfico Vigilancia inteligente Monitoreo y alertas en tiempo real. Detección de defectos de fabricación en líneas de producción. Análisis de datos para el sector minorista: Seguimiento de clientes y control de inventario. Mejores casos de uso para la búsqueda empresarial de LocateAnything: Localice productos utilizando lenguaje natural. La robótica comprende las instrucciones humanas. Inspección industrial: Detecta defectos inusuales sin necesidad de recapacitación. Gestión de activos digitales. Búsqueda semántica en grandes colecciones de imágenes. Imágenes médicas. Localice patrones visuales descritos en el texto. NVIDIA LocateAnything vs YOLO: Comparación de características Característica NVIDIA LocateAnything YOLO Detección de vocabulario abierto Sí No Rendimiento en tiempo real Moderado Excelente Aprendizaje de cero disparos Sí Limitado Entrenamiento personalizado requerido Mínimo Despliegue extenso en el borde Limitado Excelente Comprensión del lenguaje Sí No Descubrimiento de nuevos objetos Excelente Deficiente Madurez de producción Emergente Muy alta Integración de segmentación Fuerte Buena Eficiencia de recursos Moderada Excelente ¿Qué modelo debería elegir? La respuesta depende totalmente de los requisitos de su proyecto. Elija YOLO si necesita: Detección en tiempo real Implementación en el borde Baja latencia Categorías de objetos conocidas Inferencia rentable Elija LocateAnything si necesita: Detección en mundo abierto Búsqueda en lenguaje natural Localización de cero disparos Flujos de trabajo de IA flexibles Capacidades de modelo base Muchas organizaciones terminarán combinando ambos enfoques. Una arquitectura común en 2026 es: YOLO realiza una detección rápida de objetos. LocateAnything gestiona las búsquedas semánticas. SAM genera máscaras de segmentación precisas. Los sistemas LLM interpretan los resultados y automatizan las decisiones. Este enfoque híbrido ofrece velocidad e inteligencia.
Introducción. La visión por computadora está entrando en una nueva era de integración y eficiencia. Durante años, los sistemas de visión han dependido en gran medida de dos enfoques distintos: modelos de detección de objetos que localizan y clasifican rápidamente los objetos dentro de una imagen, y modelos de segmentación que proporcionan una comprensión detallada, a nivel de píxel, de esos objetos. Cada enfoque ha demostrado ser muy eficaz por sí solo, pero ambos presentan limitaciones inherentes cuando se utilizan de forma independiente en aplicaciones del mundo real que exigen velocidad y precisión. Para salvar esta brecha, ha surgido una nueva arquitectura híbrida: la combinación de YOLO (You Only Look Once) y Segment Anything Model (SAM). En este sistema unificado, YOLO ofrece una detección de objetos rápida y eficiente, mientras que SAM proporciona una segmentación de los objetos detectados con gran precisión a nivel de píxel. En conjunto, forman un sistema complementario que equilibra rendimiento y precisión. Esta integración permite lograr capacidades que antes eran difíciles de alcanzar simultáneamente: inferencia en tiempo real, precisión de segmentación detallada, eficiencia computacional optimizada y escalabilidad en diversos entornos de implementación. A partir de 2026, el sistema híbrido YOLO + SAM está pasando cada vez más de la investigación experimental a la adopción práctica, posicionándose como una arquitectura fundamental en los sistemas modernos de visión artificial en todos los sectores. 2. El problema central en la visión artificial tradicional 2.1 El dilema de la velocidad frente a la precisión Los sistemas de visión artificial tradicionalmente sufren de una compensación fundamental: Tipo de modelo Fortaleza Debilidad YOLO Inferencia extremadamente rápida Precisión de segmentación débil SAM Segmentación de alta calidad Alto coste computacional Esto crea un problema importante: Los modelos rápidos no son lo suficientemente precisos Los modelos precisos no son lo suficientemente rápidos En sistemas del mundo real como la conducción autónoma o la robótica, esta compensación es inaceptable. 2.2 Por qué la segmentación de imágenes completas es ineficiente Ejecutar modelos de segmentación como SAM en imágenes completas conduce a: Alto uso de GPU Mayor latencia Computación innecesaria en regiones vacías Poca escalabilidad para transmisiones de video en tiempo real Por ejemplo, en un fotograma 4K: Solo una pequeña fracción de píxeles contiene objetos significativos Sin embargo, la segmentación de imágenes completas procesa todo por igual Esta ineficiencia se vuelve crítica en los sistemas de producción. 2.3 La necesidad de una visión selectiva Los sistemas de IA modernos requieren un cambio de filosofía: en lugar de analizarlo todo, analizar solo lo que importa. Esta es la base del sistema híbrido SAM + YOLO. 3. ¿Qué es la plataforma híbrida SAM + YOLO? El sistema SAM + YOLO es una arquitectura de visión artificial de dos etapas diseñada para combinar la detección en tiempo real con la segmentación de alta precisión. 3.1 Idea principal El proceso funciona de la siguiente manera: YOLO detecta objetos en tiempo real SAM refina solo las regiones seleccionadas Las salidas se fusionan en una representación estructurada de la escena 3.2 Por qué funciona YOLO proporciona: Detección rápida de cuadros delimitadores Etiquetas de clase Inferencia en tiempo real SAM proporciona: Segmentación a nivel de píxeles Límites de objetos precisos Generalización robusta Juntos, forman un sistema de visión equilibrado. 3.3 Idea clave En lugar de preguntar: "¿Cómo segmentamos todo a la perfección?", preguntamos: "¿Cómo segmentamos solo lo necesario?". Este cambio reduce drásticamente el costo computacional. 4. Arquitectura de la canalización SAM + YOLO 4.1 Paso 1: Adquisición de entrada El sistema recibe entrada de: Cámaras (CCTV, drones, vehículos) Escáneres médicos Sensores industriales Sistemas de imágenes satelitales Cada fotograma se trata como una unidad de procesamiento. 4.2 Paso 2: Etapa de detección YOLO YOLO procesa la imagen y genera: Cuadros delimitadores Clases de objetos Puntuaciones de confianza Ejemplo: Persona → 0.92 de confianza Coche → 0.89 de confianza Bicicleta → 0.78 de confianza Esta etapa es extremadamente rápida, a menudo se ejecuta en milisegundos. 4.3 Paso 3: Filtrado de regiones No todas las detecciones se procesan posteriormente. El filtrado se basa en: Umbral de confianza Prioridad del objeto Reglas específicas de la aplicación Esto reduce las llamadas innecesarias a SAM. 4.4 Paso 4: Etapa de segmentación SAM SAM se aplica solo a los cuadros delimitadores seleccionados. Genera: Máscaras a nivel de píxeles Límites de objetos Mapas de segmentación refinados Este es el paso que requiere mayor capacidad de cálculo, pero ahora está altamente optimizado. 4.5 Paso 5: Fusión de salida La salida final incluye: cuadros delimitadores YOLO máscaras SAM metadatos de objetos relaciones espaciales Esto crea una salida de comprensión completa de la escena. 5. Por qué el Pipeline SAM + YOLO es un gran avance 5.1 Mejora masiva de la eficiencia En lugar de segmentar imágenes completas, solo segmentamos: Objetos detectados Regiones relevantes Esto reduce significativamente el cálculo. 5.2 Capacidad en tiempo real YOLO garantiza: Detección rápida (en tiempo real) SAM garantiza: Alta precisión solo donde se requiere Esto hace que la segmentación en tiempo real sea práctica. 5.3 Escalabilidad en todos los sistemas La canalización funciona en: Sistemas en la nube Dispositivos de borde Arquitecturas híbridas 5.4 Mejor rendimiento en escenas complejas Especialmente eficaz en: Entornos concurridos Oclusiones Objetos superpuestos Escenarios de movimiento dinámico 6. Variantes avanzadas de la canalización 6.1 YOLO + SAM con seguimiento Utilizado en sistemas de vídeo: Mantiene la identidad del objeto entre fotogramas Reduce el cálculo repetido Mejora la consistencia temporal 6.2 SAM guiado por indicaciones Las salidas de YOLO se convierten en indicaciones SAM: Cuadros delimitadores Puntos Propuestas de región Esto mejora la precisión y la velocidad de la segmentación. 6.3 Fusión de detección multiescala YOLO se ejecuta en múltiples escalas: objetos pequeños, objetos medianos, objetos grandes. Los resultados se fusionan antes de la segmentación. 6.4 Arquitecturas optimizadas para el borde Diseñadas para: Drones Robots móviles Dispositivos IoT Usos: Variantes ligeras de YOLO Modelos SAM destilados 7. Aplicaciones del mundo real 7.1 Vehículos autónomos Detección de objetos en tiempo real Segmentación de carriles y obstáculos Precisión del límite peatonal 7.2 Robótica Agarre de objetos Automatización industrial Navegación en entornos dinámicos 7.3 Imágenes médicas Detección de tumores Segmentación de órganos Asistencia diagnóstica 7.4 Agricultura inteligente Monitoreo de cultivos Detección de malezas Estimación de rendimiento 7.5 Sistemas de vigilancia Monitoreo de multitudes Detección de objetos sospechosos Análisis de comportamiento 8. Estrategias de optimización 8.1 Reducción de llamadas SAM Solo proceso: Detecciones de alta confianza Clases de prioridad 8.2 Cuantización del modelo Reducir el tamaño del modelo Mejorar la velocidad de inferencia Mantener una precisión aceptable 8.3 Procesamiento por lotes Procesar múltiples detecciones juntas para reducir la sobrecarga. 8.4 Uso de aceleración de hardware: GPU, TPU, chips de IA de borde. 8.5 Almacenamiento en caché de regiones: reutilizar los resultados de segmentación en todos los fotogramas de las secuencias de vídeo. 9. Desafíos y limitaciones 9.1 Costo computacional de SAM Sigue siendo costoso para: Imágenes de alta resolución Múltiples objetos por fotograma 9.2 Latencia en escenas densas Más objetos → más llamadas a SAM → canalización más lenta. 9.3 La complejidad de la integración requiere: Sincronización cuidadosa Ajuste de la canalización Optimización de la memoria 9.4 Limitaciones de la implementación en el borde Limitado por: Restricciones de hardware Consumo de energía Ancho de banda de memoria 10. Futuro de SAM + YOLO (Más allá de 2026) El futuro se dirige hacia: 10.1 Modelos de visión unificados Modelos únicos que: Detectan, segmentan y rastrean simultáneamente 10.2 Pipelines basados en transformadores Reemplazando arquitecturas con gran cantidad de CNN con: Transformadores de visión Modelos de razonamiento de extremo a extremo 10.3 Visión de IA totalmente nativa de borde Segmentación en tiempo real en dispositivos móviles Sistemas de inteligencia basados en drones
Introducción. La detección de objetos se ha convertido en una de las tecnologías más importantes de la inteligencia artificial moderna. Desde vehículos autónomos y sistemas de vigilancia inteligentes hasta diagnósticos sanitarios y análisis de datos en el sector minorista, los modelos de detección de objetos permiten a las máquinas identificar, clasificar y localizar objetos en imágenes y vídeos con una precisión extraordinaria. A medida que nos adentramos en 2026, la tecnología de detección de objetos continúa evolucionando rápidamente. Las arquitecturas tradicionales de redes neuronales convolucionales (CNN) se están combinando cada vez más con modelos basados en transformadores, modelos fundamentales y sistemas de IA multimodales. Esta evolución ha mejorado significativamente la precisión de detección, la velocidad, la escalabilidad y la adaptabilidad en todos los sectores. En esta guía completa, exploramos los mejores modelos de detección de objetos para visión artificial en 2026, comparamos sus fortalezas y limitaciones, y ayudamos a las organizaciones a elegir el modelo adecuado para sus aplicaciones de IA. ¿Qué es la detección de objetos? La detección de objetos es una tarea de visión artificial que identifica y localiza objetos dentro de una imagen o secuencia de vídeo. A diferencia de la clasificación de imágenes, que asigna una etiqueta a una imagen completa, la detección de objetos proporciona: Categoría de objeto Coordenadas del cuadro delimitador Puntuación de confianza Reconocimiento de múltiples objetos en una sola imagen Por ejemplo, un sistema de detección de objetos que analiza una escena callejera puede detectar: Automóviles Peatones Semáforos Bicicletas Señales de tráfico, todo simultáneamente. Por qué la detección de objetos es importante en 2026: Las organizaciones dependen cada vez más de la detección de objetos para automatizar las tareas de comprensión visual. Las principales aplicaciones incluyen: Vehículos autónomos Detección de vehículos Detección de carriles Seguimiento de peatones Reconocimiento de señales de tráfico Atención médica Detección de tumores Análisis de imágenes médicas Asistencia quirúrgica Comercio minorista Monitoreo de estantes Análisis de clientes Gestión de inventario Fabricación Inspección de calidad Detección de defectos Monitoreo de seguridad Agricultura Monitoreo de cultivos Detección de malezas Seguimiento de ganado Seguridad y vigilancia Detección de intrusiones Soporte de reconocimiento facial Detección de anomalías A medida que estas industrias expanden sus capacidades de IA, elegir el modelo de detección de objetos adecuado se vuelve fundamental. Métricas clave de evaluación para modelos de detección de objetos Antes de comparar modelos, es importante comprender las métricas que se utilizan habitualmente. La precisión media promedio (mAP) mide la exactitud de la detección en diferentes clases. Un valor de mAP más alto indica un mejor rendimiento. Fotogramas por segundo (FPS) Mide la velocidad de inferencia. Un mayor número de fotogramas por segundo (FPS) es esencial para las aplicaciones en tiempo real. Tiempo de latencia necesario para procesar una sola imagen. Una menor latencia mejora la capacidad de respuesta. El tamaño del modelo es importante para la implementación en entornos periféricos y dispositivos móviles. El costo computacional determina los requisitos de hardware y los gastos de implementación. 1. YOLOv12: El modelo líder de detección en tiempo real. YOLO (You Only Look Once) sigue siendo una de las familias de detección de objetos más populares. YOLOv12 representa una evolución significativa en velocidad, precisión y eficiencia. Ventajas clave Inferencia extremadamente rápida Excelente rendimiento en tiempo real Altas puntuaciones mAP Compatible con dispositivos Edge Implementación simplificada Mejores casos de uso Robots autónomos Cámaras inteligentes Drones Monitoreo de tráfico Análisis minorista Fortalezas Baja latencia Alto rendimiento Fuerte equilibrio entre velocidad y precisión Limitaciones Puede tener dificultades con objetos extremadamente pequeños en comparación con los modelos basados en transformadores 2. RT-DETR: El mejor detector de transformadores en tiempo real. RT-DETR se ha consolidado como uno de los modelos de detección de objetos basados en transformadores más potentes. A diferencia de las arquitecturas DETR tradicionales, RT-DETR está optimizada para aplicaciones en tiempo real. Características clave Detección de extremo a extremo Sin necesidad de NMS Arquitectura Transformer Inferencia rápida Ventajas Precisión superior Canalización de detección más limpia Excelente escalabilidad Mejores aplicaciones Conducción autónoma Automatización industrial Ciudades inteligentes Análisis de vídeo Se espera que RT-DETR siga siendo una de las mejores opciones durante todo 2026. 3. Grounding DINO: el mejor detector de vocabulario abierto. Grounding DINO representa un cambio importante hacia la detección de objetos en entornos abiertos. En lugar de detectar únicamente clases predefinidas, puede detectar objetos basándose en indicaciones en lenguaje natural. Ejemplo de instrucción: “Encuentra todas las motocicletas rojas”. El modelo puede localizar motocicletas sin necesidad de un reentrenamiento específico. Ventajas Detección de vocabulario abierto Reconocimiento guiado por el lenguaje Integración del modelo base Aplicaciones Robótica Sistemas de búsqueda Asistentes visuales Sistemas de seguridad Grounding DINO se está volviendo esencial para las aplicaciones de IA de próxima generación. 4. DINO-DETR – Detección de transformadores de alta precisión. DINO mejoró significativamente la arquitectura DETR original. Ofrece un rendimiento de detección de vanguardia en numerosos conjuntos de datos de referencia. Puntos fuertes Excepcional precisión Mejor convergencia del entrenamiento Fuerte detección de objetos pequeños Aplicaciones ideales Investigación Imágenes médicas Imágenes satelitales Fabricación de precisión Compromiso Requiere más recursos computacionales que los modelos YOLO. 5. EfficientDet: la mejor opción para implementaciones con recursos limitados. EfficientDet sigue siendo muy relevante debido a su eficiencia. Combina: Arquitectura BiFPN de la red troncal EfficientNet Escalabilidad compuesta Beneficios Tamaño de modelo pequeño Requisitos de hardware bajos Excelente implementación móvil Mejores aplicaciones Smartphones Dispositivos IoT Sistemas integrados Edge AI Las organizaciones que buscan una implementación rentable aún se benefician de EfficientDet. 6. Faster R-CNN: el estándar fiable de la industria. Aunque han surgido arquitecturas más nuevas, Faster R-CNN sigue siendo un detector de referencia. Ventajas Alta precisión Ecosistema maduro Fuerte apoyo de la comunidad Usos comunes Investigación académica Aplicaciones médicas Tareas de detección de alta precisión Limitación Más lento que YOLO y RT-DETR. 7. CenterNet2: Excelencia en la detección sin anclajes. CenterNet2 impulsa la detección de objetos sin anclajes. En lugar de depender de puntos de anclaje predefinidos, identifica directamente los centros de los objetos. Beneficios Arquitectura más simple Mejor generalización Ajuste de hiperparámetros reducido Aplicaciones Conducción autónoma Inspección industrial Vigilancia inteligente Los enfoques sin anclaje siguen ganando popularidad en 2026. 8. YOLO-World: Detección en tiempo real con vocabulario abierto. YOLO-World combina la velocidad de YOLO con capacidades de vocabulario abierto. Este sistema cierra la brecha entre los detectores de objetos tradicionales y los modelos básicos. Ventajas Inferencia en tiempo real Detección guiada por texto Implementación flexible Ideal para Robótica Búsqueda visual Entornos dinámicos YOLO-World se está convirtiendo en una de las innovaciones más emocionantes en visión artificial. 9. OWL-ViT – Detección basada en modelos fundamentales. OWL-ViT aprovecha los transformadores de visión y la comprensión del lenguaje. Puede reconocer miles de categorías de objetos sin necesidad de un reentrenamiento específico para cada tarea. Beneficios Detección sin necesidad de disparos Reconocimiento flexible Gran generalización Aplicaciones Investigación IA empresarial Robótica avanzada Los modelos fundamentales como OWL-ViT están redefiniendo las capacidades de detección de objetos. 10. Modelo de Segmentación de Todo (SAM 2) para Detección y Segmentación Si bien es principalmente un modelo de segmentación, SAM 2 cada vez admite más flujos de trabajo de detección. Por qué es importante: Los detectores tradicionales proporcionan cuadros delimitadores. SAM 2 proporciona: Máscaras de objetos precisas Segmentación interactiva Mejor comprensión visual Casos de uso Imágenes médicas Sistemas autónomos Generación de contenido Análisis geoespacial Muchas organizaciones combinan SAM 2 con detectores de objetos para un rendimiento mejorado. Comparación de los mejores modelos de detección de objetos en 2026 Modelo Precisión Velocidad Tiempo real Vocabulario abierto Despliegue en el borde YOLOv12 Excelente Excelente Sí Limitado Excelente RT-DETR Excelente Muy alto Sí No Bueno Grounding DINO Excelente Moderado Limitado Sí Moderado DINO-DETR Sobresaliente Moderado Limitado No Moderado EfficientDet Bueno Alto Sí No Excelente Faster R-CNN Excelente Moderado No No Moderado CenterNet2 Muy bueno Alto Sí No Bueno YOLO-World Excelente Alto Sí Sí Bueno OWL-ViT Excelente Moderado Limitado Sí Moderado SAM 2 Sobresaliente Moderado Parcial
Introducción. La inteligencia artificial ha transformado la forma en que las máquinas perciben e interactúan con el mundo. Desde vehículos autónomos hasta sistemas de vigilancia inteligentes, los modelos de detección de objetos desempeñan un papel crucial para que las máquinas puedan reconocer y comprender los datos visuales. Entre las familias de algoritmos de detección de objetos más influyentes se encuentra la serie YOLO, cuyas siglas significan "You Only Look Once" (Solo miras una vez). Con el paso de los años, los modelos YOLO se han convertido en sinónimo de velocidad, eficiencia y precisión. Sin embargo, los sistemas YOLO tradicionales se limitaban a detectar categorías de objetos predefinidas. Si un modelo no ha sido entrenado con una clase de objeto específica, no podrá reconocerla. Esta limitación llevó a los investigadores a desarrollar soluciones más avanzadas capaces de reconocer objetos invisibles mediante descripciones textuales. Uno de los avances más interesantes en este campo es el modelo YOLO-World, un marco de detección de objetos en tiempo real con vocabulario abierto que cierra la brecha entre la visión y la comprensión del lenguaje. YOLO-World combina la velocidad de la familia YOLO con la flexibilidad de los modelos de visión y lenguaje, lo que permite a los sistemas de IA detectar prácticamente cualquier objeto descrito mediante indicaciones de texto sin necesidad de volver a entrenarlos. En esta guía completa, exploraremos todo lo relacionado con YOLO-World, incluyendo su arquitectura, mecanismo de funcionamiento, ventajas, desafíos, casos de uso y potencial futuro. ¿Qué es YOLO-World? YOLO-World es un modelo avanzado de detección de objetos con vocabulario abierto, diseñado para realizar la detección de objetos en tiempo real mediante indicaciones en lenguaje natural. A diferencia de los sistemas convencionales de detección de objetos, que solo pueden reconocer las categorías presentes en sus conjuntos de datos de entrenamiento, YOLO-World puede identificar objetos no vistos mediante la comprensión de descripciones textuales. Esta capacidad se conoce como detección de vocabulario abierto. Por ejemplo, en lugar de estar restringido a etiquetas como: Persona Coche Perro Bicicleta YOLO-World puede detectar: Patinete eléctrico rojo Obrero de la construcción con casco Taza de cerámica azul Dron con cámara Cachorro de golden retriever Esto hace que el modelo sea significativamente más flexible y práctico para aplicaciones de IA del mundo real. Comprensión de la detección de objetos con vocabulario abierto Los detectores de objetos tradicionales se basan en conjuntos de etiquetas fijas. Estos sistemas se entrenan utilizando conjuntos de datos anotados que contienen clases predefinidas. El problema surge cuando aparecen objetos nuevos que no formaban parte de los datos de entrenamiento. La detección de vocabulario abierto resuelve este problema integrando la comprensión del lenguaje en los sistemas de detección de objetos. En lugar de depender únicamente de etiquetas predefinidas, el modelo puede interpretar descripciones en lenguaje humano y asignarles características visuales. Esto significa que el modelo puede detectar categorías no vistas de forma dinámica mediante indicaciones. Por ejemplo: “Encuentra todos los portátiles sobre la mesa”, “Detecta a los bomberos”, “Localiza los conos de tráfico naranjas”. El sistema comprende simultáneamente el lenguaje y el contenido de las imágenes. La evolución de los modelos YOLO La familia YOLO ha evolucionado significativamente con el tiempo. YOLOv1 introdujo el paradigma de detección de una sola etapa para la detección de objetos en tiempo real. YOLOv2 y YOLOv3: Mayor precisión, cuadros de anclaje y predicción multiescala. YOLOv4 y YOLOv5: Mayor eficiencia y flexibilidad de implementación. YOLOv6, YOLOv7 y YOLOv8 se centran en la optimización de la velocidad, la implementación de IA en el borde y la escalabilidad. YOLO-World introdujo la detección de vocabulario abierto mediante la integración de capacidades de lenguaje visual en el marco de YOLO. YOLO-World representa un gran avance porque combina: Inferencia en tiempo real Reconocimiento de vocabulario abierto Alineación de visión y lenguaje Implementación eficiente Cómo funciona YOLO-World YOLO-World fusiona las canalizaciones tradicionales de detección de objetos con incrustaciones conscientes del lenguaje. El sistema consta de varios componentes principales: 1. Codificador de imágenes El codificador de imágenes extrae características visuales de las imágenes de entrada. Identifica patrones como: formas, texturas, colores y límites de objetos. Estas características se convierten en representaciones numéricas llamadas incrustaciones. 2. Codificador de texto El codificador de texto procesa las indicaciones textuales. Por ejemplo: “Gato” “Coche deportivo rojo” “Equipaje de aeropuerto” Las descripciones de texto se transforman en incrustaciones semánticas. 3. Alineación visión-lenguaje: Las incrustaciones visuales y las incrustaciones de texto están alineadas dentro de un espacio de características compartido. Esto permite que el modelo compare regiones de la imagen con descripciones textuales y determine coincidencias. 4. Cabezal de detección El cabezal de detección predice: Cuadros delimitadores Puntuaciones de confianza Puntuaciones de similitud semántica El modelo genera ubicaciones de objetos que corresponden a indicaciones de texto. Características clave del rendimiento en tiempo real de YOLO-World: YOLO-World mantiene las capacidades de inferencia de alta velocidad de la familia YOLO. Esto permite su implementación en: Sistemas autónomos Cámaras inteligentes Robótica Dispositivos de IA de borde Reconocimiento de vocabulario abierto El modelo puede detectar objetos no vistos sin necesidad de reentrenamiento. Los usuarios simplemente proporcionan nuevas indicaciones. YOLO-World, mediante su sistema de detección de cero disparos, realiza un aprendizaje sin ejemplos previos al reconocer categorías ausentes en los conjuntos de datos de entrenamiento. Despliegue flexible El modelo admite: Entornos en la nube Dispositivos Edge Sistemas integrados GPU Canalizaciones de IA industrial Detección guiada por lenguaje Las indicaciones de texto permiten una detección de objetos altamente personalizada. Ejemplos incluyen: “Paquete dañado” “Personas con máscaras” “Vehículos eléctricos” Explicación de la arquitectura de YOLO-World La arquitectura de YOLO-World está diseñada para equilibrar la velocidad y la comprensión semántica. Red neuronal principal La red neuronal principal extrae las características de la imagen. Las redes troncales comunes incluyen: CSPDarknet EfficientNet Vision Transformers Neck Network El cuello combina características de múltiples escalas. Esto mejora la detección de: objetos pequeños, objetos grandes, escenas complejas y capa de fusión multimodal. Esta es la innovación principal. La capa de fusión integra: Incrustaciones visuales Incrustaciones de texto El modelo aprende relaciones semánticas entre el lenguaje y las regiones visuales. Cabezal de detección. La etapa final predice la localización del objeto y las puntuaciones de coincidencia. Ventajas de YOLO-World 1. Categorías de objetos ilimitadas. Los modelos tradicionales están limitados por las etiquetas de entrenamiento. YOLO-World puede reconocer prácticamente cualquier objeto descrito en un texto. 2. Costes de recapacitación reducidos: Las organizaciones ya no necesitan volver a capacitar a sus modelos para cada nueva categoría. Esto reduce drásticamente: Costos de anotación Tiempo de capacitación Gastos de infraestructura 3. Mejor escalabilidad: YOLO-World se escala de manera eficiente para sistemas de IA empresariales. 4. Interacción de usuario mejorada: Los usuarios interactúan de forma natural mediante indicaciones en lenguaje natural. 5. Generalización mejorada: El modelo se generaliza mejor a entornos no vistos. YOLO-World frente a los modelos YOLO tradicionales Característica YOLO tradicional YOLO-World Categorías fijas Sí No Vocabulario abierto No Sí Compatibilidad con mensajes de texto No Sí Detección de cero disparos Limitada Fuerte Velocidad en tiempo real Excelente Excelente Comprensión del lenguaje Ninguna Avanzado YOLO-World frente a los modelos de detección basados en CLIP YOLO-World se compara a menudo con los sistemas impulsados por CLIP. Modelos basados en CLIP: CLIP destaca en la comprensión de imágenes y texto, pero a menudo carece de eficiencia en la detección en tiempo real. Ventajas de YOLO-World YOLO-World proporciona: Inferencia más rápida Mejor localización Detección de objetos en tiempo real Capacidades de implementación en el borde Aplicaciones de YOLO-World Vehículos autónomos YOLO-World puede identificar objetos inesperados en la carretera mediante indicaciones de texto. Ejemplos incluyen: Ramas de árboles caídas Patinetes eléctricos Barreras de construcción Vigilancia inteligente Los sistemas de seguridad pueden detectar: Actividades sospechosas Violaciones de seguridad Objetos no autorizados Análisis minorista Los minoristas pueden rastrear: Categorías de productos Inventario en estantes Comportamiento del cliente Robótica Los robots pueden entender comandos flexibles como: “Recoge la botella roja” “Encuentra la caja de herramientas” Atención médica Los sistemas de imágenes médicas pueden ayudar en