Introducción
La visión artificial sigue avanzando hacia modelos que no solo son más precisos, sino también más rápidos, más fáciles de implementar y capaces de gestionar múltiples tareas de visión a través de un marco unificado.
En 2026, uno de los desarrollos más importantes en el ecosistema de Ultralytics es YOLO26, la última familia de modelos YOLO de Ultralytics. Lanzado en enero de 2026, YOLO26 introduce inferencia nativa de extremo a extremo, un cabezal de detección más ligero, técnicas de entrenamiento actualizadas y compatibilidad con una amplia gama de tareas de visión artificial.
Para las organizaciones que desarrollan productos basados en IA, YOLO26 resulta especialmente interesante porque aborda un desafío importante en la visión artificial aplicada a la producción: cómo lograr una alta precisión sin que la implementación sea innecesariamente compleja o computacionalmente costosa.
Esta guía explica todo lo que necesita saber sobre Ultralytics YOLO Vision en 2026, con especial atención a YOLO26, su arquitectura, capacidades, rendimiento, flujo de trabajo de capacitación, opciones de implementación, casos de uso y diferencias con respecto a YOLO11.
¿Qué es Ultralytics YOLO?
YOLO significa You Only Look Once (Solo miras una vez) y se refiere a una familia de modelos de visión artificial en tiempo real diseñados para procesar información visual de manera eficiente.
A diferencia de los sistemas tradicionales de visión artificial, que pueden requerir múltiples etapas para identificar y localizar objetos, YOLO aborda la detección de objetos como un problema de predicción unificado.
Con el paso de los años, el ecosistema YOLO se ha expandido más allá de la detección básica de objetos. Los modelos Ultralytics modernos pueden admitir:
- Detección de objetos
- Segmentación de instancias
- Segmentación semántica
- Clasificación de la imagen
- Estimación de poses
- Detección de cuadros delimitadores orientados
- Estimación de profundidad
- Seguimiento
- Detección y segmentación de vocabulario abierto
Ultralytics proporciona estas capacidades a través de un paquete común de Python y una interfaz de línea de comandos, lo que facilita a los desarrolladores y a los equipos de aprendizaje automático el entrenamiento, la evaluación, la implementación y la gestión de modelos de visión.

Que es yolo26?
YOLO26 es la última familia de modelos YOLO de Ultralytics, lanzada en enero de 2026.
Está diseñado en torno a cuatro áreas principales de mejora:
- Inferencia nativa de extremo a extremo
- Un cabezal de detección más ligero
- Una nueva receta de entrenamiento
- Mejoras específicas para diferentes problemas de visión artificial.
Uno de sus cambios más significativos es que YOLO26 utiliza por defecto un cabezal de detección uno a uno, lo que permite que el modelo produzca detecciones finales sin la supresión no máxima tradicional (NMS) como paso de posprocesamiento separado.
Esto es importante porque NMS tradicionalmente ha sido una etapa independiente en los procesos de detección de objetos. Eliminarlo de la ruta de inferencia predeterminada puede simplificar la implementación y reducir la sobrecarga del posprocesamiento.
Leer: YOLO26: La próxima evolución de la visión artificial en tiempo real
Por qué yolo26 Asuntos en 2026
La evolución de la visión artificial se centra cada vez más en la implementación práctica, en lugar de centrarse únicamente en el rendimiento en pruebas comparativas.
Un modelo puede tener una precisión excelente, pero aun así ser difícil de usar en un entorno de producción si:
- Requiere hardware costoso
- Tiene una alta latencia de inferencia.
- Requiere un procesamiento posterior complejo.
- Es difícil exportar
- Funciona mal en dispositivos periféricos.
- Requiere modelos separados para diferentes tareas de visión.
YOLO26 aborda varios de estos desafíos.
Según los datos de referencia publicados por Ultralytics, los modelos de detección YOLO26 varían entre 40.9 y 57.5 mAP en COCO, dependiendo del tamaño del modelo, con una latencia T4 TensorRT reportada de aproximadamente 1.7 ms a 11.8 ms.
El modelo YOLO26n, el más pequeño, también presenta una velocidad de inferencia ONNX de CPU de 38.9 ms, en comparación con los 56.1 ms del YOLO11n en las condiciones de referencia documentadas.
Ultralytics informa de una inferencia ONNX de CPU hasta un 43 % más rápida para YOLO26n en comparación con YOLO11n en una CPU Intel Xeon bajo su configuración de referencia.
Características principales de yolo26
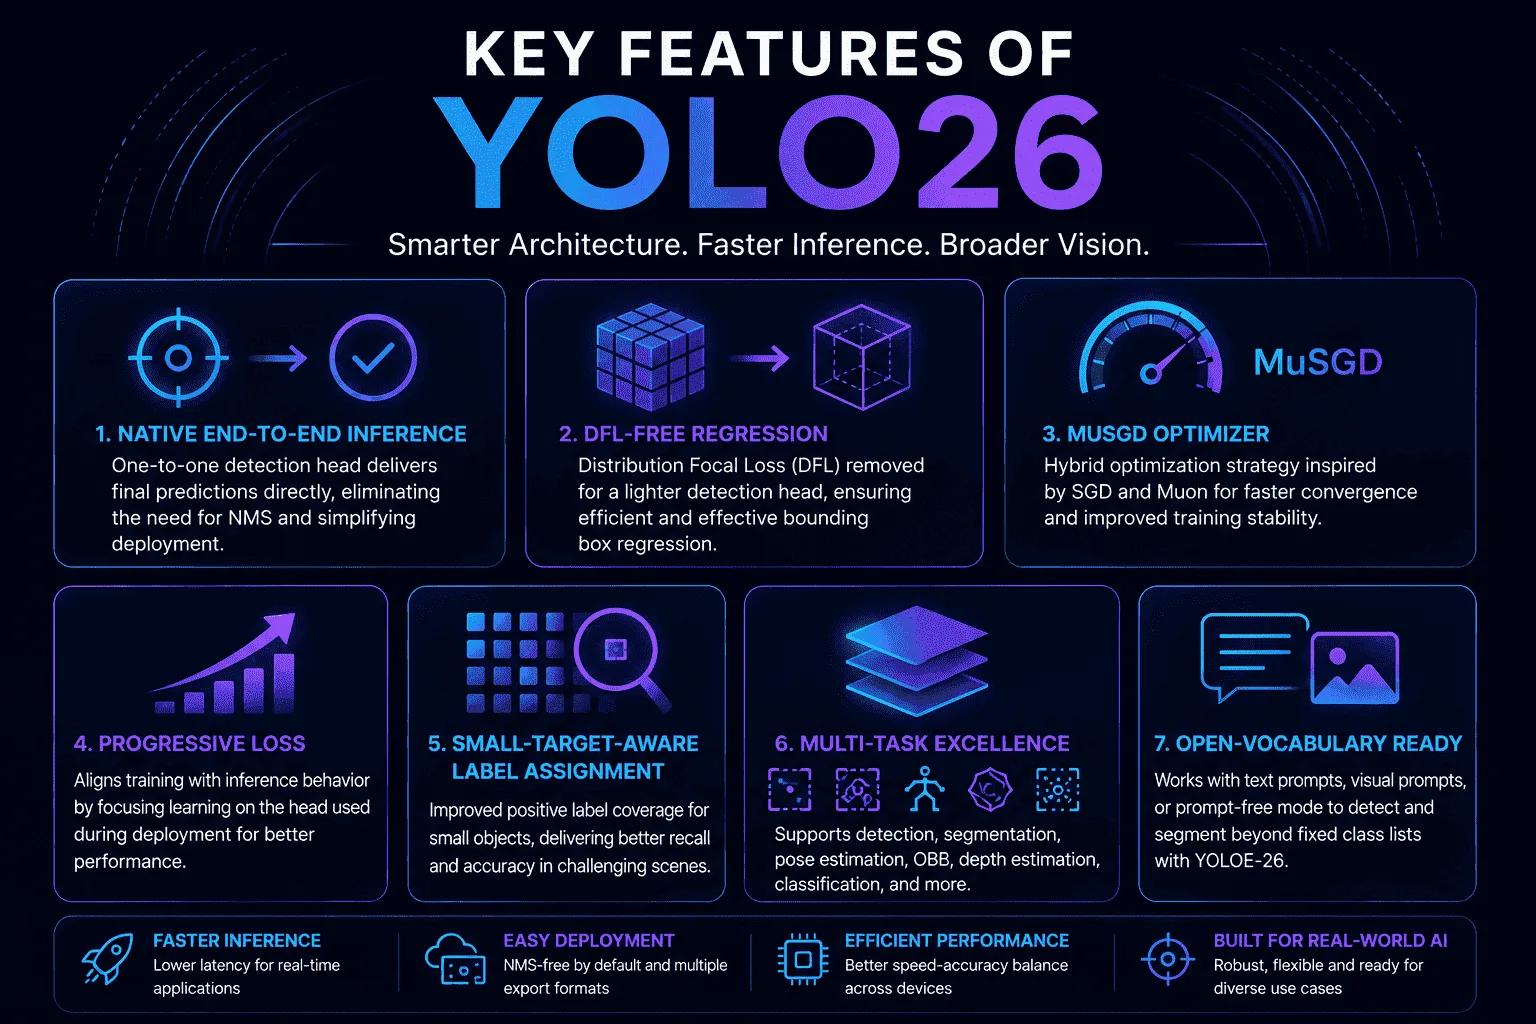
1. Inferencia nativa de extremo a extremo
Uno de los mayores cambios en YOLO26 es su arquitectura de detección nativa de extremo a extremo.
Los modelos tradicionales de detección de objetos pueden generar muchas predicciones superpuestas. Posteriormente, se aplica el método NMS para eliminar las predicciones redundantes y seleccionar las detecciones finales.
El cabezal de detección uno a uno predeterminado de YOLO26 está diseñado para producir predicciones finales directamente, eliminando la necesidad de NMS externo durante la inferencia estándar.
Esto puede proporcionar varias ventajas:
- Pipelines de inferencia más sencillos
- Posprocesamiento reducido
- Implementación más sencilla
- Ejecución más predecible en todas las plataformas.
- Baja latencia
Para las aplicaciones de IA en el borde de la red, estas mejoras pueden resultar especialmente valiosas.
2. Regresión sin DFL
YOLO26 elimina la pérdida focal de distribución (DFL) de su cabezal de detección.
El objetivo es simplificar la arquitectura de detección manteniendo un enfoque eficaz para la regresión de cuadros delimitadores.
Un cabezal de detección más sencillo también puede facilitar la exportación y el despliegue del modelo, especialmente cuando se trabaja en entornos con requisitos estrictos de compatibilidad computacional o gráfica.
3. Optimizador MuSGD
YOLO26 presenta MuSGD, un enfoque de optimización híbrido que combina ideas de SGD y de optimización al estilo de muones.
La receta de entrenamiento oficial utiliza MuSGD para los puntos de control YOLO26 entrenados en COCO. Ultralytics informa que los modelos se entrenaron con una resolución de 640×640 y un tamaño de lote de 128.
Esto ilustra una dirección importante en el desarrollo de la IA moderna: las técnicas de optimización originalmente asociadas con otras cargas de trabajo de aprendizaje profundo se están adaptando cada vez más a la visión artificial.
4. Pérdida progresiva
YOLO26 utiliza la función de pérdida progresiva para alinear mejor el entrenamiento con el comportamiento del modelo durante la inferencia.
El objetivo es centrar la formación de forma más eficaz en el cabezal de predicción que se utilizará realmente durante el despliegue.
Esto puede ayudar a reducir la discrepancia entre cómo se optimiza un modelo durante el entrenamiento y cómo funciona durante la inferencia en el mundo real.
5. Asignación de etiquetas teniendo en cuenta objetivos pequeños
La detección de objetos pequeños es un reto común en la visión por computadora.
YOLO26 introduce la asignación de etiquetas con reconocimiento de objetivos pequeños (STAL, por sus siglas en inglés) para mejorar la cobertura de etiquetas positivas para objetos pequeños.
Esto puede ser particularmente relevante para aplicaciones que involucren:
- Cámaras de tráfico
- Imágenes de drones
- Vigilancia
- Imágenes de satélite
- Inspección de fabricación
- Analítica minorista
Los objetos pequeños suelen ocupar solo un pequeño porcentaje de una imagen, lo que dificulta su detección fiable.
Tallas del modelo YOLO26
YOLO26 está disponible en cinco tamaños de detección principales:
Modelo | Parámetros | FRACASOS | COCO mAP | CPU ONNX | T4 TensorRT |
YOLO26n | 2.4 m | 5.4B | 40.9 | 38.9 ms | 1.7 ms |
YOLO26s | 9.5 m | 20.7B | 48.6 | 87.2 ms | 2.5 ms |
YOLO26m | 20.4 m | 68.2B | 53.1 | 220.0 ms | 4.7 ms |
YOLO26l | 24.8 m | 86.4B | 55.0 | 286.2 ms | 6.2 ms |
YOLO26x | 55.7 m | 193.9B | 57.5 | 525.8 ms | 11.8 ms |
Las cifras anteriores son los resultados de las pruebas de rendimiento publicadas por Ultralytics y deben considerarse como mediciones de referencia, no como garantías para cada configuración de hardware.
¿Qué modelo de YOLO26 debería elegir?
YOLO26n: Ideal cuando las prioridades son la baja capacidad de procesamiento, el tamaño reducido del modelo y el despliegue en el borde de la red.
YOLO26s: Una excelente opción cuando se necesita un equilibrio entre eficiencia y precisión.
YOLO26m: Adecuado para aplicaciones donde una mayor precisión justifica un mayor esfuerzo de cálculo.
YOLO26l: Diseñado para cargas de trabajo exigentes que requieren mayor precisión.
YOLO26x: Más adecuado para escenarios donde el rendimiento máximo en pruebas de referencia es más importante que el coste computacional.
¿Qué tareas realiza? yolo26 ¿Apoyo?
Una de las mayores ventajas de YOLO26 es que no se limita a la detección de objetos.
Esta familia de modelos admite múltiples tareas de visión artificial.
Detección de objetos
La detección de objetos identifica los objetos y determina su ubicación mediante cuadros delimitadores.
Las aplicaciones comunes incluyen:
- Detección de vehículos
- Detección de personas
- Detección de productos
- Inspección industrial
- Monitoreo de tráfico
- Sistemas de seguridad
Segmentación de instancia
La segmentación de instancias identifica objetos individuales y crea máscaras a nivel de píxel a su alrededor.
Por ejemplo, en lugar de simplemente detectar cinco coches, un modelo de segmentación puede identificar la forma precisa de cada coche.
Esto es útil para:
- Imagenes medicas
- Robótica
- Manufactura
- Agricultura
- Sistemas autónomos
Ultralytics informa de mejoras en la segmentación de instancias de YOLO26 en comparación con YOLO11, incluyendo ganancias reportadas de hasta 2.5 AP de caja y 3.7 AP de máscara en COCO.
Segmentación semántica
La segmentación semántica asigna clases a los píxeles de una imagen.
Esto resulta útil cuando el objetivo es comprender la estructura general de una escena en lugar de simplemente detectar objetos individuales.
Algunos ejemplos son:
- Segmentación de carreteras
- Segmentación de edificios
- Análisis de imágenes médicas
- Análisis de campo agrícola
Estimación de poses
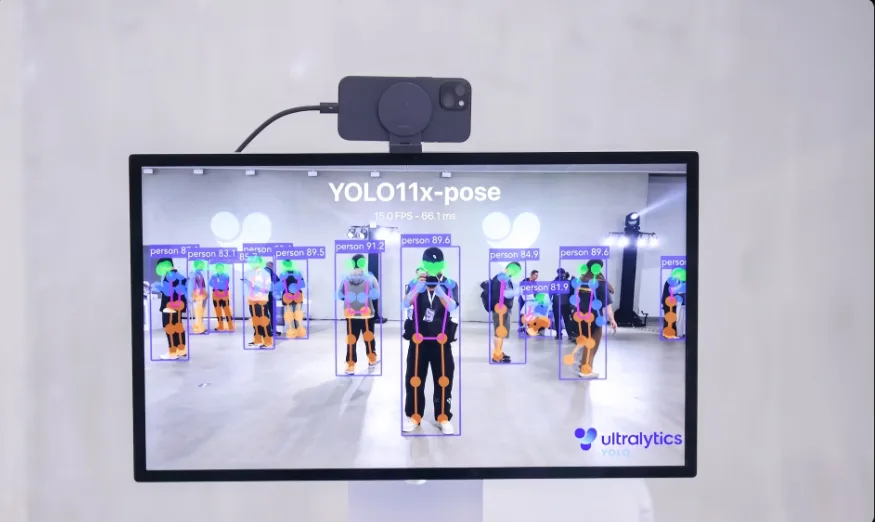
La estimación de la postura identifica puntos clave que representan la posición de personas u objetos.
Las aplicaciones incluyen:
- Analítica deportiva
- Aplicaciones de fitness
- La interacción persona-ordenador
- Reconocimiento de gestos
- Robótica
Ultralytics informa que los modelos de pose YOLO26 pueden proporcionar mejoras con respecto a YOLO11, con ganancias reportadas de hasta 7.2 AP en la estimación de pose COCO.
Detección de objetos orientados
Los cuadros delimitadores orientados, o OBB, son útiles cuando los objetos se rotan en lugar de alinearse con los ejes de la imagen.
Las aplicaciones típicas incluyen:
- Imágenes aéreas
- Imágenes de satélite
- Análisis de documentos
- Inspección industrial
- IA geoespacial
YOLO26 incluye mejoras especializadas de OBB, que incluyen una pérdida de ángulo actualizada y una decodificación optimizada.
Estimación de profundidad
YOLO26 también admite la estimación de profundidad monocular.
Esto significa que el modelo puede estimar la información de profundidad a partir de una sola imagen.
La estimación de profundidad tiene aplicaciones en:
- Robótica
- AR / VR
- Sistemas autónomos
- Comprensión de escenas 3D
- Cámaras inteligentes
YOLOE-26: Visión de vocabulario abierto
Otro desarrollo importante en torno al ecosistema YOLO26 es YOLOE-26.
Los modelos tradicionales de detección de objetos generalmente se entrenan con una lista predefinida de clases.
Los modelos de vocabulario abierto son diferentes.
Pueden utilizar texto o indicaciones visuales para identificar categorías que no necesariamente se limitan a una lista de clases fija establecida durante el proceso de capacitación original.
YOLOE-26 admite:
- Solicitud de texto
- indicaciones visuales
- Detección sin avisos
Esto resulta especialmente útil en entornos dinámicos donde las categorías que un sistema de IA necesita reconocer pueden cambiar con el tiempo.
Por ejemplo, un sistema de venta minorista podría adaptarse para buscar nuevas categorías de productos sin tener que reconstruir desde cero todo el proceso de visión estratégica.
YOLO26 vs YOLO11
YOLO11 sigue siendo un modelo importante de Ultralytics y se recomienda para cargas de trabajo de producción estables junto con YOLO26. Sin embargo, YOLO26 introduce varios cambios arquitectónicos orientados a la eficiencia en la inferencia y el despliegue de extremo a extremo.
Elemento | yolo11 | yolo26 |
tortugitas | 2024 | 2026 |
Inferencia predeterminada sin NMS | No | Sí: |
Cabezal de detección | Enfoque tradicional YOLO | Uno a uno + uno a muchos |
DFL | Usado | Remoto |
MuSGD | No | Sí: |
STAL | No | Sí: |
Pérdida progresiva | No | Sí: |
Detección | Sí: | Sí: |
Segmentación | Sí: | Sí: |
Pose | Sí: | Sí: |
OBB | Sí: | Sí: |
Profundidad | No | Sí: |
Vocabulario abierto | Mediante una familia de modelos independiente | YOLOE-26 |
YOLO11 sigue siendo una opción viable cuando un proyecto ya cuenta con una infraestructura YOLO11 consolidada, puntos de referencia existentes o requisitos de compatibilidad. YOLO26 resulta especialmente atractivo cuando la inferencia integral, la simplicidad de la implementación o las nuevas funcionalidades de las tareas son importantes.
Cómo instalar YOLO26
Poner en marcha Ultralytics YOLO es relativamente sencillo.
Instala el paquete usando pip:
ultralíticos de instalación de pip
A continuación, puedes cargar un modelo YOLO26 preentrenado:
de ultralíticos importar YOLO
modelo = YOLO(“yolo26n.pt”)
Ejecutar inferencia en una imagen:
resultados = modelo(“imagen.jpg”)
Ultralytics también proporciona un flujo de trabajo de línea de comandos:
yolo predict model=yolo26n.pt source=”image.jpg”
La documentación oficial proporciona flujos de trabajo en Python y en la interfaz de línea de comandos (CLI) para la predicción, el entrenamiento, la validación y la exportación de modelos.
Cómo entrenar YOLO26 con un conjunto de datos personalizado
Los modelos preentrenados son útiles, pero muchas aplicaciones del mundo real requieren un entrenamiento personalizado.
Un flujo de trabajo típico incluye:
Paso 1: recopilar datos
Cree un conjunto de datos representativo del entorno en el que operará el modelo.
Por ejemplo, un modelo de automóvil debería contener diferentes:
- Las condiciones climáticas
- Condiciones de iluminación
- Angulos de camara
- Tipos de vehículos
- Entornos viales
Paso 2: Anotar el conjunto de datos
Dependiendo de la tarea, las anotaciones pueden incluir:
- Cuadros delimitadores
- Máscaras de segmentación
- Puntos clave
- Cuadros delimitadores orientados
- Etiquetas de clasificacion
Una anotación de alta calidad es fundamental porque el rendimiento del modelo está fuertemente influenciado por la calidad y la diversidad de los datos de entrenamiento.
Paso 3: Preparar la configuración del conjunto de datos
Un conjunto de datos YOLO normalmente incluye una configuración YAML que describe los conjuntos de datos de entrenamiento y validación, así como los nombres de las clases.
Paso 4: Comienza el entrenamiento
Un ejemplo básico de Python es:
de ultralíticos importar YOLO
modelo = YOLO(“yolo26n.pt”)
resultados = modelo.entrenar(
datos="custom_data.yaml",
épocas = 100,
imgsz=640 )
Los ejemplos oficiales de Ultralytics utilizan el mismo flujo de trabajo general para ajustar los modelos YOLO en conjuntos de datos personalizados.
Estrategia de entrenamiento YOLO26
Entrenar un modelo de visión robusto implica mucho más que seleccionar un punto de control del modelo.
La receta oficial de entrenamiento YOLO26 incluye varias opciones destacables.
Los modelos publicados fueron entrenados utilizando:
- MuSGD
- Resolución de imagen de 640×640
- Tamaño del lote: 128
- Formación de extremo a extremo
- Aumento de mosaico
- Aumento de escala
- Pérdida progresiva
- Asignación de etiquetas teniendo en cuenta objetivos pequeños
La receta de entrenamiento también desactiva el aumento de mosaico durante la parte final del entrenamiento para ayudar al modelo a refinar sus predicciones.
Sin embargo, para conjuntos de datos personalizados, no conviene copiar ciegamente todos los parámetros de entrenamiento de COCO. El tamaño del conjunto de datos, la escala de los objetos, el equilibrio de clases, la calidad de la imagen y el hardware pueden influir en la configuración óptima.
Implementación de YOLO26
Un modelo de visión artificial solo resulta útil en producción si puede ejecutarse de manera eficiente en su entorno de destino.
YOLO26 está diseñado pensando en su implementación.
Los posibles entornos de implementación incluyen:
- Servidores en la nube
- GPU NVIDIA
- CPUs
- Dispositivos de inteligencia artificial de borde
- Los sistemas embebidos
- Cámaras inteligentes
- Plataformas robóticas
Ultralytics permite exportar modelos a formatos y plataformas como ONNX, TensorRT, CoreML, LiteRT y OpenVINO.
La arquitectura integral también puede reducir la complejidad de la implementación, ya que la ruta de inferencia predeterminada no requiere una etapa NMS separada.
Aplicaciones prácticas de YOLO26
Sector Sanitario
La visión artificial se puede utilizar para:
- Análisis de imágenes médicas
- Detección de estructuras anatómicas
- Segmentación médica
- Análisis de vídeo quirúrgico
- Monitoreo de pacientes
Las aplicaciones sanitarias requieren validación adicional, conjuntos de datos de alta calidad, controles de privacidad y una supervisión clínica adecuada.
Sistemas automotrices y autónomos
YOLO26 se puede utilizar para tareas de percepción visual como:
- Detección de vehículos
- Detección de peatones
- Reconocimiento de señales de tráfico
- Detección de objetos en la carretera
- Comprensión de la escena
Su enfoque en la inferencia eficiente puede hacerlo relevante para aplicaciones automotrices basadas en computación perimetral.
Comercio minorista y comercio electrónico
Las empresas minoristas pueden utilizar la visión artificial para:
- Detección de productos
- Monitoreo de estanterías
- Análisis de inventario
- Análisis del cliente
- Automatización del pago
Las capacidades de vocabulario abierto también pueden resultar útiles en entornos donde las categorías de productos cambian con frecuencia.
Manufactura
La visión artificial industrial es otra área de aplicación importante.
YOLO26 puede admitir:
- Detección de defectos
- Control de calidad
- Inspección de componentes
- Conteo de objetos
- Monitoreo de la seguridad de los trabajadores
Agricultura
La visión artificial puede ayudar a identificar:
- Los cultivos
- Frutas
- Malas hierbas
- Enfermedades de las plantas
- Equipamiento agrícola
Las mejoras en la detección de objetos pequeños pueden ser especialmente relevantes cuando los objetos ocupan solo una pequeña porción de una imagen.
Seguridad y vigilancia inteligente
Los modelos de detección en tiempo real pueden impulsar:
- Detección de personas
- Monitoreo de vehículos
- Vigilancia de zonas restringidas
- Análisis de multitudes
- Seguridad perimetral
Las organizaciones que implementen estos sistemas también deben tener en cuenta la privacidad, las regulaciones locales, la retención de datos y los requisitos de IA responsable.
Por qué la calidad de los datos sigue siendo importante
Ni siquiera la arquitectura de visión artificial más reciente puede compensar la mala calidad de los datos de entrenamiento.
Un modelo altamente optimizado entrenado con anotaciones inexactas o poco representativas puede tener un rendimiento inferior al de un modelo más pequeño entrenado con un conjunto de datos cuidadosamente seleccionado.
Para los proyectos de producción, las organizaciones deben prestar atención a:
Diversidad de datos: Incluir variaciones realistas.
Calidad de la anotación: Las etiquetas deben representar con precisión la tarea prevista.
Equilibrio de clases: Evitar el dominio excesivo de un pequeño número de clases.
Casos límite: Incluya ejemplos difíciles e inusuales.
Datos de validación: Mantenga los datos representativos separados de los datos de entrenamiento.
Cambio de dominio: Pruebe el modelo en el entorno donde realmente operará.
Esto es especialmente importante al pasar de conjuntos de datos públicos como COCO a dominios especializados como la atención médica, la automoción, la inspección industrial o el comercio minorista.
¿Deberías usar YOLO26 para tu proyecto?
YOLO26 resulta especialmente atractivo cuando su proyecto requiere:
- Visión artificial en tiempo real
- Inferencia de baja latencia
- Implementación de borde
- Tareas de visión múltiple
- Canalizaciones de implementación simplificadas
- Entrenamiento de modelo personalizado
- Detección moderna de extremo a extremo
- Capacidades de vocabulario abierto
Sin embargo, la elección de un modelo siempre debe basarse en pruebas y no únicamente en el nombre del modelo.
Antes de pasar a producción, compare los modelos candidatos utilizando los suyos propios:
- Conjunto de datos
- Componentes metálicos
- Resolucion de imagen
- Requisitos de latencia
- Requisitos de precisión
- Restricciones de memoria
- Entorno de implementación
Un modelo que funciona bien en COCO no necesariamente será el mejor modelo para un conjunto de datos de producción especializado.
El futuro de YOLO y la IA de visión
YOLO26 demuestra una tendencia más amplia en la visión artificial: la industria se está moviendo hacia modelos de visión unificados, eficientes y orientados a la implementación.
En lugar de optimizar exclusivamente para la precisión de referencia, los sistemas de visión modernos necesitan cada vez más combinar:
- Exactitud
- Velocidad
- Eficiencia
- Capacidades multitarea
- Despliegue flexible
- fácil integración
- Adaptabilidad
La introducción de la detección integral, la estimación de profundidad, las capacidades de vocabulario abierto y los múltiples cabezales de tareas especializadas ilustran cómo el ecosistema YOLO se está expandiendo más allá de la detección de objetos tradicional.
Para los desarrolladores y las empresas, esto significa que la pregunta más importante ya no es simplemente "¿Qué versión de YOLO tiene el mAP más alto?".
La mejor pregunta es:
¿Qué modelo ofrece la combinación adecuada de precisión, latencia, coste, flexibilidad y simplicidad de implementación para mi aplicación?
Conclusión
Ultralytics YOLO Vision 2026, liderado por YOLO26, representa un paso significativo en la evolución de la visión artificial en tiempo real.
Entre sus innovaciones más importantes se incluyen la inferencia nativa de extremo a extremo sin NMS, la regresión sin DFL, la optimización MuSGD, la pérdida progresiva, STAL y la compatibilidad ampliada con la segmentación, la pose, la estimación de profundidad, OBB y la visión de vocabulario abierto.
Para los equipos que desarrollen productos de IA en 2026, YOLO26 ofrece un excelente punto de partida para aplicaciones que abarcan desde cámaras inteligentes y robótica hasta atención médica, automoción, fabricación, comercio minorista e inspección industrial.
Al mismo tiempo, el modelo debe evaluarse en función de los requisitos reales del proyecto. La calidad de los datos, la precisión de las anotaciones, el hardware, las limitaciones de implementación y las pruebas específicas del dominio siguen siendo tan importantes como la propia arquitectura del modelo.
A medida que la visión artificial avanza hacia sistemas de IA más rápidos y flexibles, YOLO26 ofrece un claro ejemplo de hacia dónde se dirige la tecnología de visión en tiempo real.
Preguntas frecuentes
¿Qué es Ultralytics YOLO26?
Ultralytics YOLO26 es la última familia de modelos YOLO de Ultralytics, lanzada en enero de 2026. Proporciona capacidades de visión artificial en tiempo real con inferencia nativa de extremo a extremo y soporte para múltiples tareas de visión.
¿Qué novedades trae YOLO26?
Las principales mejoras incluyen inferencia de extremo a extremo sin NMS, regresión sin DFL, el optimizador MuSGD, pérdida progresiva, STAL y mejoras específicas para la tarea de segmentación, pose y detección de orientación.
¿Es YOLO26 mejor que YOLO11?
YOLO26 introduce nuevas características de arquitectura e implementación, y Ultralytics informa de un rendimiento de referencia y una inferencia de CPU mejorados para varias configuraciones. Sin embargo, YOLO11 sigue siendo una opción recomendada para cargas de trabajo de producción estables, por lo que la mejor opción depende de la aplicación y del entorno de implementación.
¿YOLO26 utiliza NMS?
El cabezal de detección uno a uno predeterminado de YOLO26 está diseñado para la inferencia de extremo a extremo sin NMS tradicional. También proporciona un cabezal uno a muchos que se puede utilizar cuando se prefieren las predicciones basadas en NMS tradicional.
¿Qué tareas puede realizar YOLO26?
YOLO26 admite detección de objetos, segmentación de instancias, segmentación semántica, estimación de profundidad monocular, clasificación de imágenes, estimación de pose y detección de objetos orientados.
¿Puedo entrenar YOLO26 con mi propio conjunto de datos?
Sí. YOLO26 se puede ajustar con precisión en conjuntos de datos personalizados utilizando la API o la interfaz de línea de comandos de Ultralytics para Python.
¿Puede YOLO26 ejecutarse en dispositivos periféricos?
Sí. YOLO26 está diseñado pensando en una implementación eficiente y se puede exportar a formatos como ONNX, TensorRT, CoreML, LiteRT y OpenVINO.
¿Qué es YOLOE-26?
YOLOE-26 es una extensión de vocabulario abierto de YOLO26 que admite indicaciones de texto, indicaciones visuales y funcionamiento sin indicaciones para la detección y segmentación.
¿Qué modelo YOLO26 es el mejor para la IA en el borde?
YOLO26n suele ser el punto de partida más adecuado cuando el tamaño del modelo, los requisitos computacionales y la latencia son limitaciones importantes. Las variantes de mayor tamaño pueden ofrecer mayor precisión a costa de un mayor esfuerzo computacional.
¿Es YOLO26 adecuado para proyectos comerciales?
YOLO26 puede utilizarse en proyectos comerciales, sujeto a los términos de licencia de Ultralytics aplicables. Las organizaciones deben revisar los requisitos de licencia AGPL-3.0 y Enterprise vigentes antes de su implementación comercial.
¿Cómo empiezo a usar YOLO26?
Puedes instalar el paquete Ultralytics con pip install ultralytics , cargar un modelo preentrenado yolo26n.pt y ejecutar la inferencia o ajustarlo con tu propio conjunto de datos.