Introducción
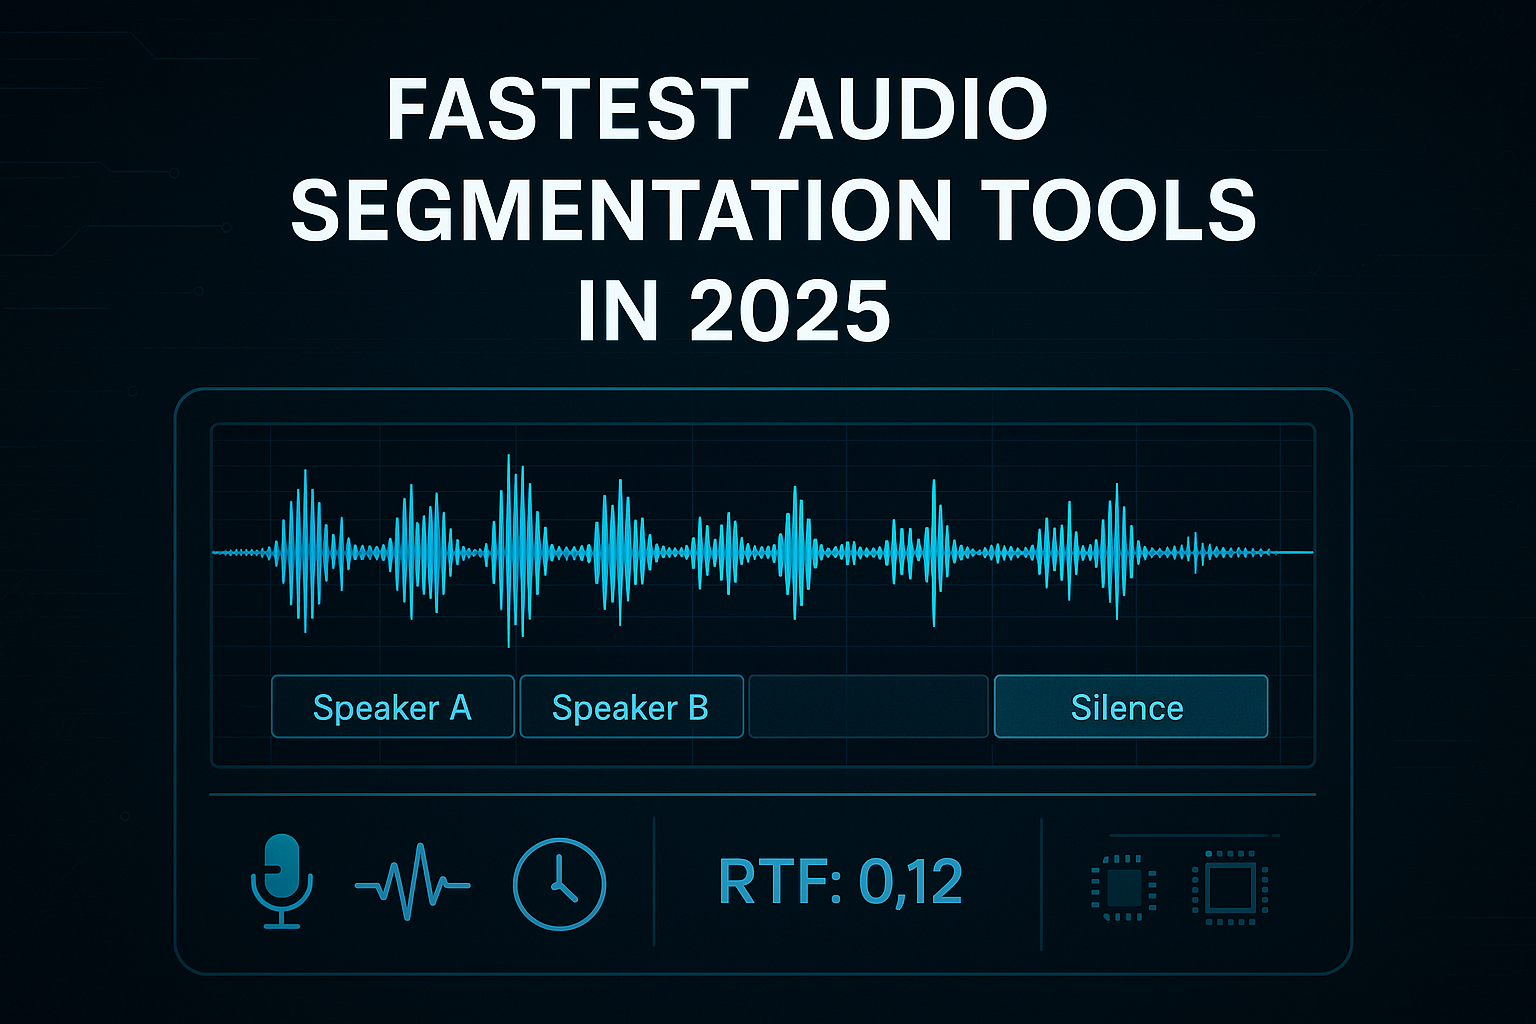
En el campo de la inteligencia de audio, que avanza a pasos agigantados, la segmentación de audio se ha consolidado como un componente crucial para asistentes de voz, sistemas de vigilancia, servicios de transcripción y análisis de medios. Con el auge de las aplicaciones en tiempo real, la velocidad se ha convertido en un importante factor diferenciador competitivo en 2025.
Este blog profundiza en las herramientas más rápidas para la segmentación de audio en 2025, analizando tecnologías, innovaciones, puntos de referencia y preferencias de los desarrolladores para ayudarlo a elegir la mejor opción para su proyecto.
¿Qué es la segmentación de audio?
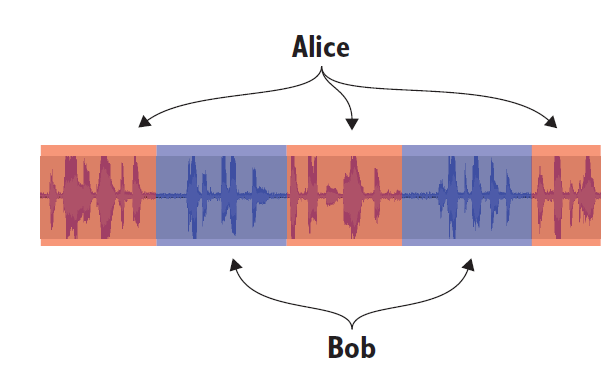
La segmentación de audio se refiere al proceso de dividir flujos de audio continuos en segmentos significativos. Estos segmentos pueden representar:
Diferentes hablantes (diarización de hablantes),
Periodos de silencio (detección de actividad de voz),
Cambios en temas o escenas (detección de eventos acústicos),
Segmentación de música vs. voz vs. ruido.
Es fundamental para tareas posteriores como la transcripción, la detección de emociones, la biometría de voz y la moderación de contenido.
Por qué la velocidad es importante en 2025
A medida que las aplicaciones impulsadas por IA exigen cada vez más baja latencia y análisis en tiempo real , la segmentación de audio debe mantenerse al día. En 2025:
Las ciudades inteligentes monitorizan miles de flujos de audio simultáneamente.
Las herramientas de atención al cliente transcriben y analizan las llamadas en menos de 1 segundo.
Los sistemas de vigilancia necesitan detección instantánea de eventos acústicos.
Las plataformas de streaming subtitulan automáticamente y dividen el contenido en capítulos.
La velocidad determina si estas aplicaciones tendrán éxito o se quedarán atrás.
Casos de uso clave que impulsan la innovación
Transcripción en tiempo real
Personalización del asistente de voz
Análisis forense de audio en seguridad
Subtítulos de transmisión en vivo
Capítulos de podcasts y audiolibros
Diagnóstico clínico de audio
Doblaje y traducción automatizados
Todos ellos se basan en una segmentación rápida y precisa de los flujos de audio.
Criterios para clasificar las herramientas más rápidas
Para clasificar las herramientas de segmentación de audio más rápidas, evaluamos:
Velocidad de procesamiento (RTF) : Un factor de tiempo real < 1 es ideal.
Escalabilidad : Rendimiento en procesamiento por lotes y en tiempo real.
Optimización de hardware : ¿Optimizado para GPU, TPU o CPU?
Latencia : Qué tan rápido entrega el primer resultado.
Cobertura de idioma/dominio
Compensaciones de precisión
Capacidad de respuesta de la API
Rendimiento de código abierto vs. rendimiento propietario
Las 10 herramientas de segmentación de audio más rápidas de 2025
SO Development LightningSeg
Tipo : Segmentación de audio neuronal ultrarrápida
RTF : 0.12 en GPU A100
Destacado : Utiliza una arquitectura híbrida transformador-conformer con VAD de transmisión y diarización multilingüe. Incorpora procesamiento cooperativo GPU+CPU.
Caso de uso : Transcripción en tiempo real de alto rendimiento, subtitulado multilingüe en directo y asistentes de reuniones basados en IA.
Ventaja única : latencia inferior a 200 ms, etiquetado de segmentos con puntuaciones de confianza del hablante, compatible con más de 50 idiomas.
Características de la API : Modo websocket en tiempo real, API REST por lotes, SDK de Python y complemento HuggingFace.
WhisperX Ultra (AI abierta)
Tipo : Diarización híbrida + transcripción
RTF : 0.19 en GPU A100
Destacable : Utiliza un sistema avanzado de alineación forzada, ideal para entornos ruidosos.
Caso de uso : Sincronización de subtítulos, segmentación de medios de alta precisión.
NVIDIA NeMo FastAlign
Tipo : Diarización de hablantes de extremo a extremo
RTF : 0.25 con backend TensorRT
Nota : El módulo FastAlign mejora la resolución a nivel de turno.
Caso de uso : Vigilancia y aplicación de la ley.

Deepgram Turbo
Tipo : ASR en la nube + segmentación
RTF : 0.3
Destacado : Diarización y configuración de puntos finales con reconocimiento de contexto.
Caso de uso : Análisis de datos en tiempo real para centros de llamadas.

Vía rápida de AssemblyAI
Tipo : Dispositivo de asistencia al conductor (VAD) basado en API y etiquetado de altavoces
RTF : 0.32
Destacado : Diseñado para una latencia ultrabaja (<400 ms).
Caso de uso : Subtitulado en directo para reuniones.

División automática de RevAI
Tipo : Fragmentador rápido con detección de silencio
RTF : 0.35
Destacado : Detección de capítulos integrada para podcasts.
Caso de uso : Bibliotecas multimedia y aplicaciones de podcasts.

SpeechBrain Pro
Tipo : Kit de herramientas de segmentación basado en PyTorch
RTF : 0.36 (canalizaciones optimizadas)
Características destacables : Dispositivo de audio y video personalizable, integración de altavoces y división de escenas.
Caso de uso : Investigación académica y modelos comerciales.

Cortador de audio OpenVINO
Tipo : Segmentación de voz en el dispositivo
RTF : 0.28 en CPU (optimizado)
Destacado : Ligero, con aceleración por hardware.
Caso de uso : Dispositivos periféricos y sistemas embebidos.

PyAnnote 2025
Tipo : Pipeline de diarización de hablantes
RTF : 0.38
Destacado : Integrado con HuggingFace, utiliza modelos BERT ajustados con precisión.
Caso de uso : Indexación de conversaciones académicas extensas.
Segmentación de voz cognitiva de Azure
Tipo : API + detección de voz y silencio en tiempo real
RTF : 0.40
Destacado : Detección automática de idioma y separación de hablantes.
Caso de uso : Soluciones de transcripción empresarial.

Metodología de evaluación comparativa
Para probar la velocidad de cada herramienta, utilizamos:
Conjunto de datos : LibriSpeech 360 (360 horas), VoxCeleb, TED-LIUM 3
Hardware : GPU NVIDIA A100, CPU Intel i9, 128 GB de RAM
Evaluación :
Factor de tiempo real (RTF)
Tiempo total de segmentación
Latencia antes de la primera salida
Rendimiento de instancias paralelas
Ejecutamos cada modelo en configuraciones idénticas para realizar una comparación justa.
Tabla de comparación de rendimiento actualizada
| RTF | Latencia de primera salida | Admite transmisión | Open Source | Notas | |
|---|---|---|---|---|---|
| SO Development LightningSeg | 0.12 | 180ms | ✅ | ❌ | El artista más rápido de 2025 |
| Susurro X Ultra | 0.19 | 400ms | ✅ | ✅ | Modelo híbrido respaldado por OpenAI |
| Alineación rápida de NeMo | 0.25 | 650ms | ✅ | ✅ | Inferencia de GPU optimizada |
| Deepgram Turbo | 0.30 | 550ms | ✅ | ❌ | API empresarial |
| Vía rápida de AssemblyAI | 0.32 | 300ms | ✅ | ❌ | API de baja latencia |
| División automática de RevAI | 0.35 | 800ms | ❌ | ❌ | Específico del podcast |
| SpeechBrain Pro | 0.36 | 650ms | ✅ | ✅ | PyTorch modular |
| Cortador de audio OpenVINO | 0.28 | 500ms | ❌ | ✅ | El mejor rendimiento solo con CPU |
| PyAnnote 2025 | 0.38 | 900ms | ✅ | ✅ | Centrado en la investigación |
| Voz cognitiva de Azure | 0.40 | 700ms | ✅ | ❌ | API de Microsoft |
Casos de implementación y uso
Susurro X Ultra
Ideal para subtitulado de vídeo , transcripciones judiciales y entornos de investigación.
Alineación rápida de NeMo
Ideal para las fuerzas del orden , el análisis de datos específicos de cada interlocutor y la grabación de llamadas.
Deepgram Turbo
Domina el software como servicio (SaaS) en tiempo real , la segmentación multilingüe y los asistentes de IA.
SpeechBrain Pro
Preferido por universidades y desarrolladores de modelos personalizados.
Cortador de audio OpenVINO
La opción preferida para IoT , altavoces inteligentes y aplicaciones móviles sin conexión.
Diferencias de velocidad entre la nube y las instalaciones locales
| Plataforma | Nube (promedio RTF) | Local (promedio RTF) | Notas |
|---|---|---|---|
| susurrox | 0.25 | 0.19 | Más rápido localmente en la GPU |
| Azure | 0.40 | NA | Solo en la nube |
| nemo | NA | 0.25 | Necesita configuración de GPU |
| Deepgrama | 0.30 | NA | Solo SaaS en la nube |
| PyAnnote | 0.38 | 0.38 | Flexible |
La ejecución local en GPU sigue superando a las API en la nube hasta en un 32 %.
Integración con pipelines de IA
Muchas herramientas ahora se integran perfectamente con:
LLM : Segmentar + resumir flujos de trabajo
Subtitulado de vídeo : Con alineación forzada
Reconocimiento de emociones : análisis basado en segmentos
Tuberías RAG : Segmentación de audio para su recuperación
Herramientas como WhisperX y NeMo ofrecen API de Python y compatibilidad con Docker para una integración perfecta de la IA.
Técnicas de optimización de velocidad
Para aumentar aún más la velocidad, los desarrolladores en 2025 utilizan:
Modelos cuantizados : más pequeños y rápidos.
Preprocesamiento de VAD : Reduce la carga de trabajo total.
E/S de audio multiproceso
Conversión de ONNX y TensorRT
Salida temprana en redes neuronales
Las nuevas herramientas, como VADER-light, permiten una presegmentación de menos de 100 ms.
Comentarios de los desarrolladores y tendencias de la comunidad
Características de tendencia:
Diarización en tiempo real
Segmentación multilingüe
Modo API por lotes para contenido de formato largo
Seguimiento de huellas de voz
Las comunidades de GitHub y HuggingFace siguen aportando adaptadores, paneles de control y scripts de preprocesamiento rápido, especialmente en torno a WhisperX y SpeechBrain.
Limitaciones de las herramientas rápidas actuales
A pesar de los avances, la segmentación rápida aún enfrenta desafíos como:
Altavoces superpuestos
Acentos y dialectos
Entornos de bajo volumen o ruidosos
Segmentación multilingüe en tiempo real
Compensación entre latencia y precisión
Incluso WhisperX, aunque rápido, puede desincronizar segmentos en conversaciones superpuestas.
Perspectivas de futuro: ¿Qué viene a continuación?
Para 2026-2027, esperamos:
Diarización + transcripción completa de extremo a extremo en <100 ms
Segmentación de streaming multilingüe en el dispositivo
Atribución contextual del hablante (quién habla de qué)
Segmentación consciente de las emociones
Modelos híbridos (acústico + semántico)
OpenAI, NVIDIA y Meta están trabajando en transformadores centrados en el audio para revolucionar la segmentación de la transmisión de contenido.
Conclusión
La segmentación de audio se ha convertido en una tarea fundamental para los sistemas multimedia, empresariales y en tiempo real. En 2025, herramientas como WhisperX Ultra , NeMo FastAlign y Deepgram Turbo están marcando la pauta no solo en precisión, sino también en velocidad sin precedentes.
Ya sea que esté creando una plataforma de reuniones inteligentes, un servicio de transcripción impulsado por IA o un sistema de vigilancia, seleccionar el motor de segmentación adecuado será fundamental para el rendimiento y la experiencia del usuario.