Introducción
En el vertiginoso mundo de la visión artificial, pocas tareas han acaparado tanta atención —e impulsado tanta innovación— como la detección y segmentación de objetos. Desde las primeras técnicas basadas en características diseñadas manualmente hasta los avanzados modelos de IA actuales capaces de segmentar cualquier cosa, la evolución ha sido verdaderamente revolucionaria. Uno de los puntos de inflexión más significativos se produjo con el lanzamiento de la familia de detectores de objetos YOLO (You Only Look Once) , que priorizaba el rendimiento en tiempo real sin comprometer significativamente la precisión.
En 2023 surgió otro gran avance: el modelo Segment Anything Model (SAM) de Meta AI . SAM representa un cambio hacia modelos de propósito general con capacidad de aprendizaje automático, capaces de comprender y segmentar objetos arbitrarios, incluso aquellos que nunca antes han visto.
Este blog explora la fascinante trayectoria de la detección y segmentación de objetos, rastreando su linaje desde YOLO hasta SAM y descubriendo cómo el campo ha evolucionado para satisfacer las crecientes demandas de automatización, autonomía e inteligencia.
Los primeros días de la detección de objetos
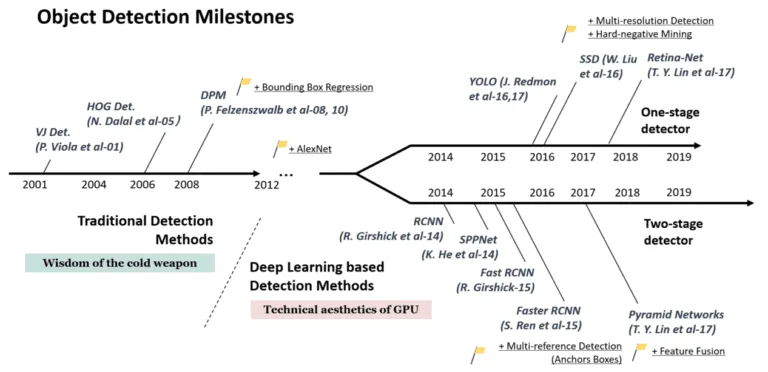
Antes del auge del aprendizaje profundo, la detección de objetos era un proceso basado en reglas y computacionalmente costoso. El flujo de trabajo clásico implicaba:
Extracción de características mediante técnicas como SIFT, HOG o SURF.
Propuesta de región mediante ventanas deslizantes o búsqueda selectiva.
Clasificación mediante modelos tradicionales de aprendizaje automático como máquinas de vectores de soporte (SVM) o árboles de decisión.
La falta de capacidad de entrenamiento de extremo a extremo y el alto costo computacional significaban que estos métodos a menudo eran lentos y poco confiables en condiciones del mundo real.
Detector Viola-Jones
Una de las primeras soluciones prácticas para la detección de rostros fue el algoritmo de Viola-Jones . Este combinaba imágenes integrales y características tipo Haar con una cascada de clasificadores, demostrando una alta velocidad para su época. Sin embargo, era un algoritmo especializado y no generalizable a otras clases de objetos.
Modelos de piezas deformables (DPM)
Los DPM introdujeron cierta flexibilidad, tratando los objetos como composiciones de partes. Si bien obtuvieron resultados respetables en pruebas de rendimiento como PASCAL VOC, su dependencia de funciones personalizadas y una optimización compleja dificultaron la escalabilidad.
El YOLO Revolution
El lanzamiento de YOLO en 2016 por Joseph Redmon marcó un cambio de paradigma significativo. YOLO introdujo una red neuronal de extremo a extremo que realizaba simultáneamente la clasificación y la regresión de cuadros delimitadores en una sola pasada hacia adelante.
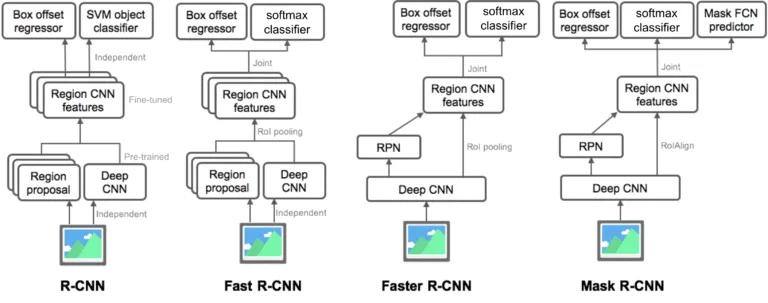
YoLoV1 (2016)
Se trató la detección como un problema de regresión.
Dividió la imagen en una cuadrícula; cada celda de la cuadrícula predijo cuadros delimitadores y probabilidades de clase.
Se logró una velocidad en tiempo real (~45 FPS) con una precisión aceptable.
Inconveniente : Tuvo dificultades con objetos pequeños y con varios objetos muy juntos.
YOLOv2 y YOLOv3 (2017-2018)
Se introdujeron cuadros de anclaje para una mejor localización.
Se utilizaron Darknet-19 (v2) y Darknet-53 (v3) como redes troncales.
YOLOv3 adoptó la detección multiescala , mejorando la precisión en objetos de diferentes tamaños.
Superó a detectores anteriores como Faster R-CNN en velocidad y comenzó a cerrar la brecha de precisión.
De YOLOv4 a YOLOv7: Progreso liderado por la comunidad
Después de que Redmon se retiró del desarrollo, la comunidad dio un paso al frente.
YOLOv4 (2020) : Introdujo CSPDarknet, la activación de Mish y las técnicas de Bolsa de Regalos/Bolsa de Ofertas Especiales.
YOLOv5 (2020) : Aunque no es oficial, YOLOv5 de Ultralytics se popularizó gracias a su base en PyTorch y su facilidad de uso (plug-and-play).
YOLOv6 y YOLOv7 : Introdujeron optimizaciones adicionales, arquitecturas personalizadas y un aumento del mAP en los conjuntos de datos COCO y VOC.
Estas iteraciones redujeron significativamente la brecha entre los detectores en tiempo real y sus contrapartes más lentas y precisas.
YOLOv8 a YOLOv12: Hacia arquitecturas modernas
YOLOv8 (2023) : Centrado en la modularidad, la segmentación de instancias y la usabilidad.
De YOLOv9 a YOLOv12 (2024-2025) : Transformadores integrados , módulos de atención y comprensión del lenguaje visual , acercando a YOLO a las capacidades de modelos generalistas como SAM.
CNN basadas en regiones: la familia R-CNN
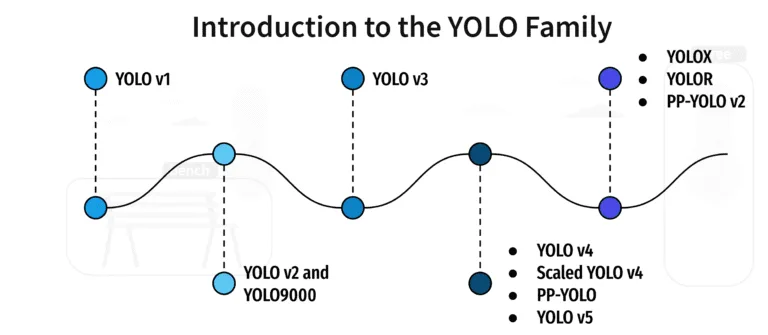
Antes de YOLO, el marco de trabajo dominante era R-CNN , desarrollado por Ross Girshick y su equipo.
R-CNN (2014)
Se generaron 2000 propuestas de regiones mediante búsqueda selectiva.
Se introdujo cada región en una CNN (AlexNet) para la extracción de características.
Características clasificadas de SVM; cuadros delimitadores refinados de regresión.
Preciso pero dolorosamente lento (~47 s/imagen en la GPU).
R-CNN rápida (2015)
Velocidad mejorada mediante el uso de una CNN compartida para toda la imagen.
Se utilizó la técnica de agrupación de ROI para extraer características de tamaño fijo de las propuestas.
Mucho más rápido, pero todavía depende de métodos de propuesta de región externa.
R-CNN más rápido (2016)
Se introdujo la Red de Propuestas Regionales (RPN, por sus siglas en inglés).
Capacitación completa de principio a fin.
Se convirtió en el estándar de oro en precisión durante varios años.
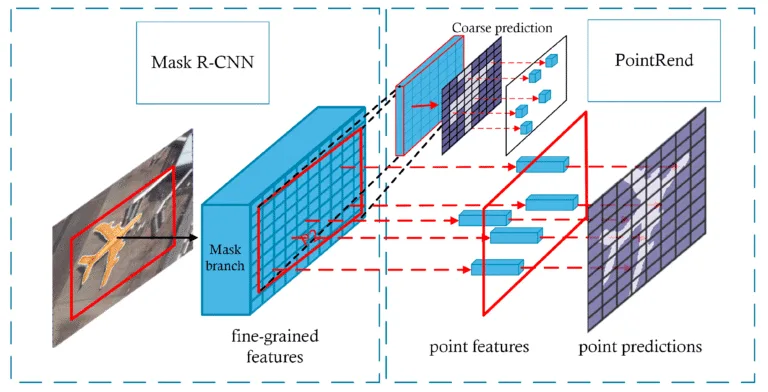
Máscara R-CNN
Se ha ampliado Faster R-CNN añadiendo una rama de segmentación.
Segmentación de instancias habilitada.
Extremadamente influyente, ampliamente adoptado en el ámbito académico y la industria.
Detectores sin ancla: una nueva era
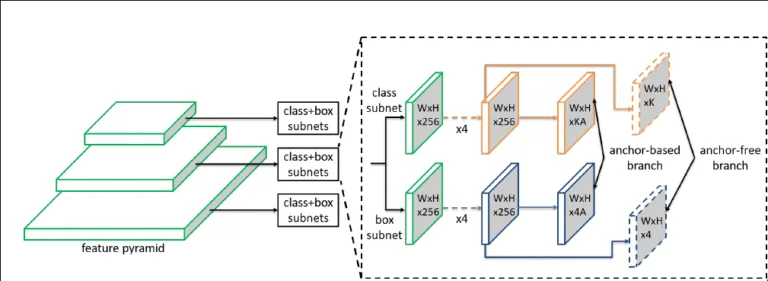
Las cajas de anclaje eran una muleta que añadía complejidad. Los investigadores buscaban enfoques sin anclaje para simplificar el entrenamiento y mejorar la generalización.
CornerNet y CentroNet
Predice directamente las esquinas o centros de los objetos.
Computación reducida y rendimiento mejorado en casos extremos.
FCOS (Detección de objetos de una etapa totalmente convolucional)
Se eliminaron anclas, propuestas y posprocesamiento.
Se trató la detección como un problema de predicción por píxel.
Inspiró métodos más nuevos en conducción autónoma y robótica.
Estos modelos anticiparon avances posteriores en la predicción densa e inspiraron enfoques de segmentación más flexibles.
El auge de los transformadores de visión
La revolución de la PNL provocada por los transformadores pronto se reflejó en la visión por computadora.
ViT (Transformador de visión)
Dividí las imágenes en parches y los procesé como palabras en PNL.
Escalabilidad demostrada con grandes conjuntos de datos.
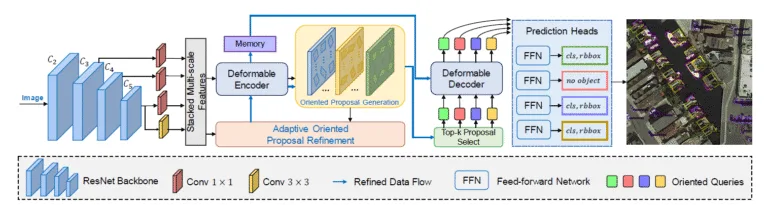
DETR (Transformador de detección)
Detección de objetos de extremo a extremo mediante transformadores.
Sin NMS, anclas ni propuestas: solo predicciones directas.
Más lento pero más robusto y extensible.
Las variantes de DETR sirven ahora como base para muchos modelos de segmentación, incluido SAM.
Segmentación en el punto de mira: de Mask R-CNN a DeepLab
Segmentación semántica vs. instancia vs. panóptica
Semántico : Clasifica cada píxel (por ejemplo, DeepLab).
Instancia : Distingue entre múltiples instancias de la misma clase (por ejemplo, Mask R-CNN).
Panóptico : Combina ambos (por ejemplo, FPN panóptico).
Familia DeepLab (v1 a v3+)
Se utilizaron convoluciones atrosas (dilatadas) para un mejor contexto.
Excelentes resultados de segmentación semántica.
A menudo se combina con CNN de red troncal o transformadores.
Estos enfoques sobresalieron en entornos estructurados pero carecían de generalidad.
Presentamos SAM: el modelo Segment Anything de Meta AI
Lanzado en 2023, SAM (Segment Anything Model) de Meta AI marcó un hito.
Generalización de disparo cero
Entrenado con más de mil millones de máscaras en 11 millones de imágenes.
Puede segmentar cualquier objeto con:
Mensaje de texto
Apuntar y hacer clic
Cuadro delimitador
Indicaciones de forma libre
Arquitectura de interiores
Basado en una estructura ViT.
Características:
Codificador de indicaciones
Codificador de imagen
Descodificador de máscara
Altamente paralelo y eficiente.
Puntos fuertes
Funciona de inmediato en conjuntos de datos no vistos.
Produce máscaras con píxeles perfectos.
Excelente en segmentación interactiva.
Análisis comparativo: YOLO vs. R-CNN vs. SAM
| Elemento | YOLO | Más rápido/Máscara R-CNN | SAM |
|---|---|---|---|
| Velocidad | Gestión del riesgo | De media a lenta | Media |
| Exactitud | Alto | Muy Alta | Extremadamente alto (a nivel de píxel) |
| Segmentación | Sólo en versiones recientes | Segmentación de instancias fuerte | Uso general, disparo cero |
| usabilidad | ¡Fácil | Requiere ajuste | Conecta y reproduce |
| Aplicaciones | Sistemas en tiempo real | Investigación y medicina | Visión multipropósito |
SAM no sustituye a YOLO ni a R-CNN, sino que es una herramienta complementaria para aplicaciones que requieren una segmentación flexible e interactiva.
Aplicaciones en la Industria
Vehículos autónomos
YOLO: Detección de carriles y peatones.
Máscara R-CNN: Detección de límites de objetos.
SAM: Comprensión de entornos complejos, segmentación de objetos raros.
Sector Sanitario
Máscara R-CNN y DeepLab: Detección de tumores, segmentación de órganos.
SAM: Anotación de anomalías raras en exploraciones radiológicas con datos mínimos.
Agricultura
YOLO: Detección de plagas, malezas y cultivos.
SAM: Contar frutas o segmentar partes de plantas para análisis de rendimiento.
Comercio minorista y vigilancia
YOLO: Seguimiento de objetos en tiempo real.
SAM: Etiquetado de artículos en inventario o segmentación de multitudes.
Desafíos y limitaciones
YOLO : Todavía tiene dificultades con objetos extremadamente pequeños.
Redes neuronales convolucionales (R-CNN) : Requieren una gran capacidad de cálculo.
SAM :
Uso intensivo de memoria GPU.
Puede sobresegmentar o subsegmentar en escenas saturadas.
Se necesita una mejor comprensión multimodal.
El futuro: hacia modelos de visión generalistas
Con modelos como GPT-4V y Gemini que demuestran razonamiento multimodal, la tendencia en visión se dirige hacia modelos fundamentales que puedan:
Comprender imágenes, vídeos y textos.
Detectar, describir y razonar sobre el contenido.
Realice segmentación, clasificación y generación, todo en uno.
La fusión de la velocidad de YOLO , la precisión de R-CNN y la flexibilidad de SAM podría constituir la columna vertebral de la IA de próxima generación.
Conclusión
Desde los avances en tiempo real de YOLO hasta las capacidades generalistas de SAM, la evolución de la detección y segmentación de objetos refleja la trayectoria general de la IA: hacia sistemas más rápidos , inteligentes y generalizables . Cada hito se ha basado en el anterior, acercándonos a máquinas que ven y comprenden el mundo como nosotros.
De cara al futuro, una cosa está clara: el futuro de la visión artificial no reside en elegir entre YOLO y SAM, sino en integrar las fortalezas de ambos para construir sistemas de IA que sean tan adaptables, rápidos e inteligentes como los desafíos que están diseñados para resolver.