Introducción
En la visión artificial, la segmentación solía parecer el “trabajo manual” de la IA: hacer clic aquí, dibujar un cuadro allí, corregir esa máscara, repetir unas miles de veces, tratar de no llorar.
El Modelo Segment Anything (SAM) original de Meta convirtió ese trabajo pesado en un truco de magia de apuntar y hacer clic: al tocar unos pocos píxeles se obtenía una máscara de objeto limpia. SAM 2 amplió su alcance a los vídeos, incorporando segmentación programable en tiempo real a escenas en movimiento.
Ahora llega SAM 3 como el siguiente gran paso: no solo segmenta los elementos en los que haces clic , sino también los conceptos que describes . En lugar de sugerir manualmente cada objeto, puedes decir "todos los taxis amarillos" o "jugadores con camisetas rojas" y dejar que el modelo encuentre, segmente y rastree cada coincidencia en imágenes y vídeos.
Este blog analiza en profundidad SAM 3: qué es, en qué se diferencia de sus predecesores, qué significa realmente “Segmentación de conceptos programable” y cómo cambia la forma en que pensamos sobre los modelos de base visual.
1. De SAM a SAM 3: Una breve cronología
Antes de sumergirnos en SAM 3, conviene dar un paso atrás y ver cómo llegamos hasta aquí.
SAM (v1): Clic para segmentar
El SAM original introdujo una idea potente: un modelo de segmentación amplio y generalista capaz de segmentar cualquier elemento con indicaciones visuales: puntos, cuadros o máscaras aproximadas. Se entrenó con un conjunto de datos masivo y diverso y mostró un excelente rendimiento de segmentación de cero disparos en múltiples dominios.
SAM 2: Imágenes y vídeos, en tiempo real
SAM 2 extendió el concepto al vídeo , tratando una imagen como un vídeo de un solo fotograma y añadiendo un mecanismo de memoria de transmisión para admitir la segmentación en tiempo real en secuencias largas.
Mejoras clave en SAM 2:
Modelo unificado para imágenes y vídeos
Memoria de transmisión para un procesamiento de vídeo eficiente
Motor de datos de modelo en bucle para crear un enorme conjunto de datos de segmentación de video SA-V
Pero SAM 2 seguía el mismo patrón de interacción: se especificaba una ubicación concreta (punto/cuadro/máscara) y se obtenía una instancia de objeto a la vez.
SAM 3: De “este objeto” a “este concepto”
SAM 3 cambia las reglas del juego al introducir la Segmentación de Conceptos Anunciables (PCS) : en lugar de decir "segmenta lo que está debajo de este clic", puedes decir "segmenta todos los perros de este vídeo" y obtener:
Todas las instancias de ese concepto
Máscaras de segmentación para cada instancia
Identidades consistentes para cada instancia en todos los fotogramas (seguimiento)
En otras palabras, SAM 3 ya no es solo una herramienta de segmentación, sino un modelo unificado de detección, segmentación y seguimiento de vocabulario abierto para imágenes y vídeos.
2. ¿Qué es exactamente SAM 3?
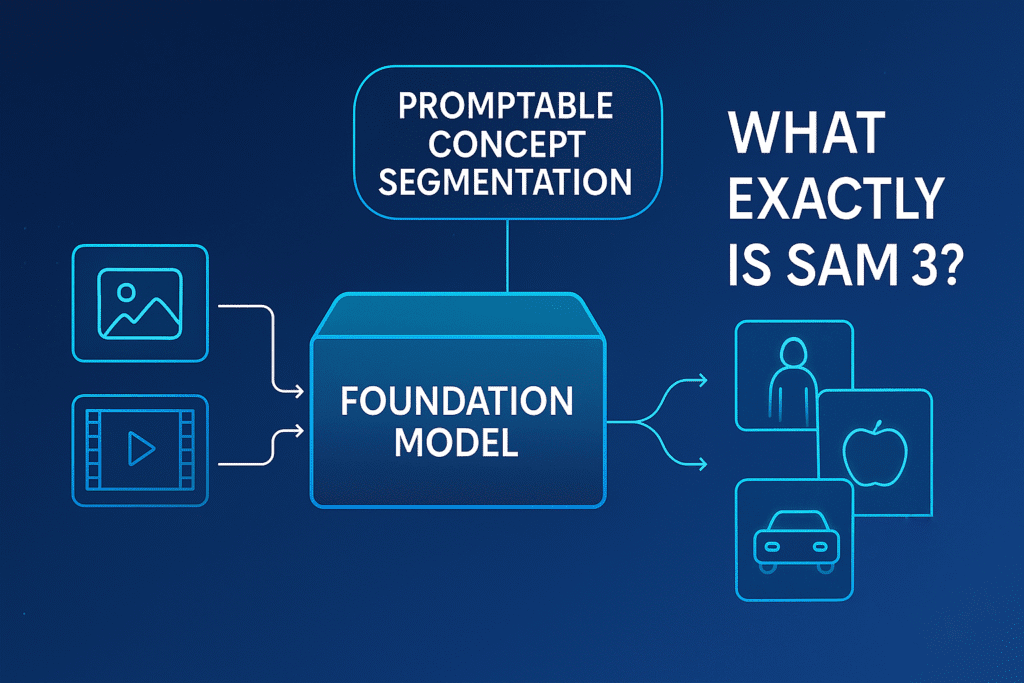
En esencia, SAM 3 es un modelo base unificado para la segmentación mediante indicaciones en imágenes y vídeos que funciona a partir de indicaciones conceptuales.
Capacidades
Según el comunicado y la descripción técnica de Meta, SAM 3 puede:
Detectar y segmentar objetos
Dado un texto o una indicación visual, SAM 3 encuentra todas las instancias de objetos coincidentes en una imagen o video y devuelve máscaras de instancias.
Seguimiento de objetos a lo largo del tiempo
En el caso del vídeo, SAM 3 mantiene identidades estables, por lo que se puede seguir el mismo objeto a lo largo de los fotogramas.
Trabajar con múltiples tipos de indicaciones
Texto : “autobús escolar amarillo”, “persona con mochila”
Ejemplos de imágenes : ejemplos de cuadros/máscaras de un objeto
Indicaciones visuales : puntos, recuadros, máscaras (estilo SAM 2)
Indicaciones combinadas : por ejemplo, “coche rojo” + un ejemplar, para un control aún más preciso.
Apoyar la segmentación de vocabulario abierto
No se basa en un conjunto cerrado de clases predefinidas. En su lugar, utiliza indicaciones del lenguaje y ejemplos para generalizar nuevos conceptos.
Escalar a grandes colecciones de imágenes y vídeos
SAM 3 está diseñado explícitamente para manejar el problema de “encontrar todo como X” en grandes conjuntos de datos, no solo en un solo cuadro.
En comparación con SAM 2, SAM 3 formaliza PCS y agrega comprensión de conceptos basada en el lenguaje al tiempo que preserva (y mejora) las capacidades de segmentación interactiva de versiones anteriores.
3. Segmentación de conceptos programable (PCS): la gran idea
La "segmentación de conceptos mediante indicaciones" es la nueva tarea central que aborda SAM 3. Usted proporciona una indicación de concepto y el modelo devuelve máscaras e identificadores para todos los objetos que coinciden con ese concepto.
Los estímulos conceptuales pueden ser:
Indicaciones de texto
Frases nominales simples como “manzana roja”, “gato rayado”, “jugador de fútbol de azul”, “coche en el carril izquierdo”.
Ejemplares de imágenes
Cuadros de ejemplo positivos/negativos alrededor de objetos que te interesan.
Indicaciones combinadas
Texto + ejemplos, por ejemplo, “camión de reparto” más un cuadro delimitador de ejemplo para guiar el modelo.
Esto es fundamentalmente diferente de las indicaciones visuales clásicas del estilo SAM:
| Elemento | SAM / SAM 2 | SAM 3 (PCS) |
|---|---|---|
| Tipo de aviso | Visual (puntos/cuadros/máscaras) | Texto, ejemplos, elementos visuales o combinaciones |
| Salida por mensaje | Una instancia por interacción | Todas las instancias del concepto |
| Alcance de la tarea | Local, a nivel de instancia | Global, a nivel de concepto en todos los marcos |
| Vocabulario | Implícito, no impulsado por el lenguaje | Vocabulario abierto mediante texto + ejemplos |
Esto significa que puedes hacer cosas como:
“Encuentra todas las motocicletas en este vídeo de tráfico de 10 minutos.”
“Segmentar a todas las personas que usan casco en un conjunto de datos de una obra en construcción.”
“Contar todas las manzanas verdes frente a las manzanas rojas en un escaneo de almacén.”
Todo sin hacer clic manualmente en cada objeto. El sueño de una segmentación a escala similar a una consulta está mucho más cerca de hacerse realidad.
4. Bajo el capó: Cómo funciona SAM 3 (conceptualmente)
Meta ha publicado una descripción general y ha puesto en código abierto la implementación de referencia a través de GitHub y centros de modelos como Hugging Face.
Si bien los detalles exactos de implementación se encuentran en el documento y el código oficiales, los ingredientes de alto nivel se ven aproximadamente así:
Columna vertebral de la visión
Un potente codificador de imágenes y vídeos transforma cada fotograma en una rica representación de características espaciotemporales.
Codificador de conceptos (lenguaje + ejemplos)
Las indicaciones de texto se codifican utilizando un modelo de lenguaje o un codificador de texto.
Los ejemplos visuales (por ejemplo, cuadros/máscaras alrededor de un objeto de ejemplo) se codifican como características visuales.
El sistema fusiona estos elementos en una representación conceptual que representa "lo que usted está solicitando".
Fusión de visión rápida
La incorporación de conceptos interactúa con las características visuales (por ejemplo, a través de la atención) para resaltar las regiones que corresponden al concepto solicitado.
Cabezal de segmentación de instancias
A partir del mapa de características fusionadas, el modelo produce:
Máscaras binarias/suaves
ID de instancia
Cuadros de detección o puntuaciones opcionales
Componente temporal para seguimiento
Para video, SAM 3 utiliza mecanismos inspirados en la memoria de transmisión de SAM 2 para mantener identidades consistentes para los objetos en todos los cuadros, lo que permite un seguimiento eficiente de conceptos a lo largo del tiempo.
Se puede pensar en SAM 3 como “SAM 2 + un potente motor de conceptos de lenguaje de visión”, envuelto en un único modelo unificado.
5. SAM 3 vs SAM 2 y detectores tradicionales
¿Cómo se compara realmente SAM 3 con los sistemas anteriores?
Comparado con SAM 2
Según análisis de Meta y de terceros:
Rendimiento de PCS
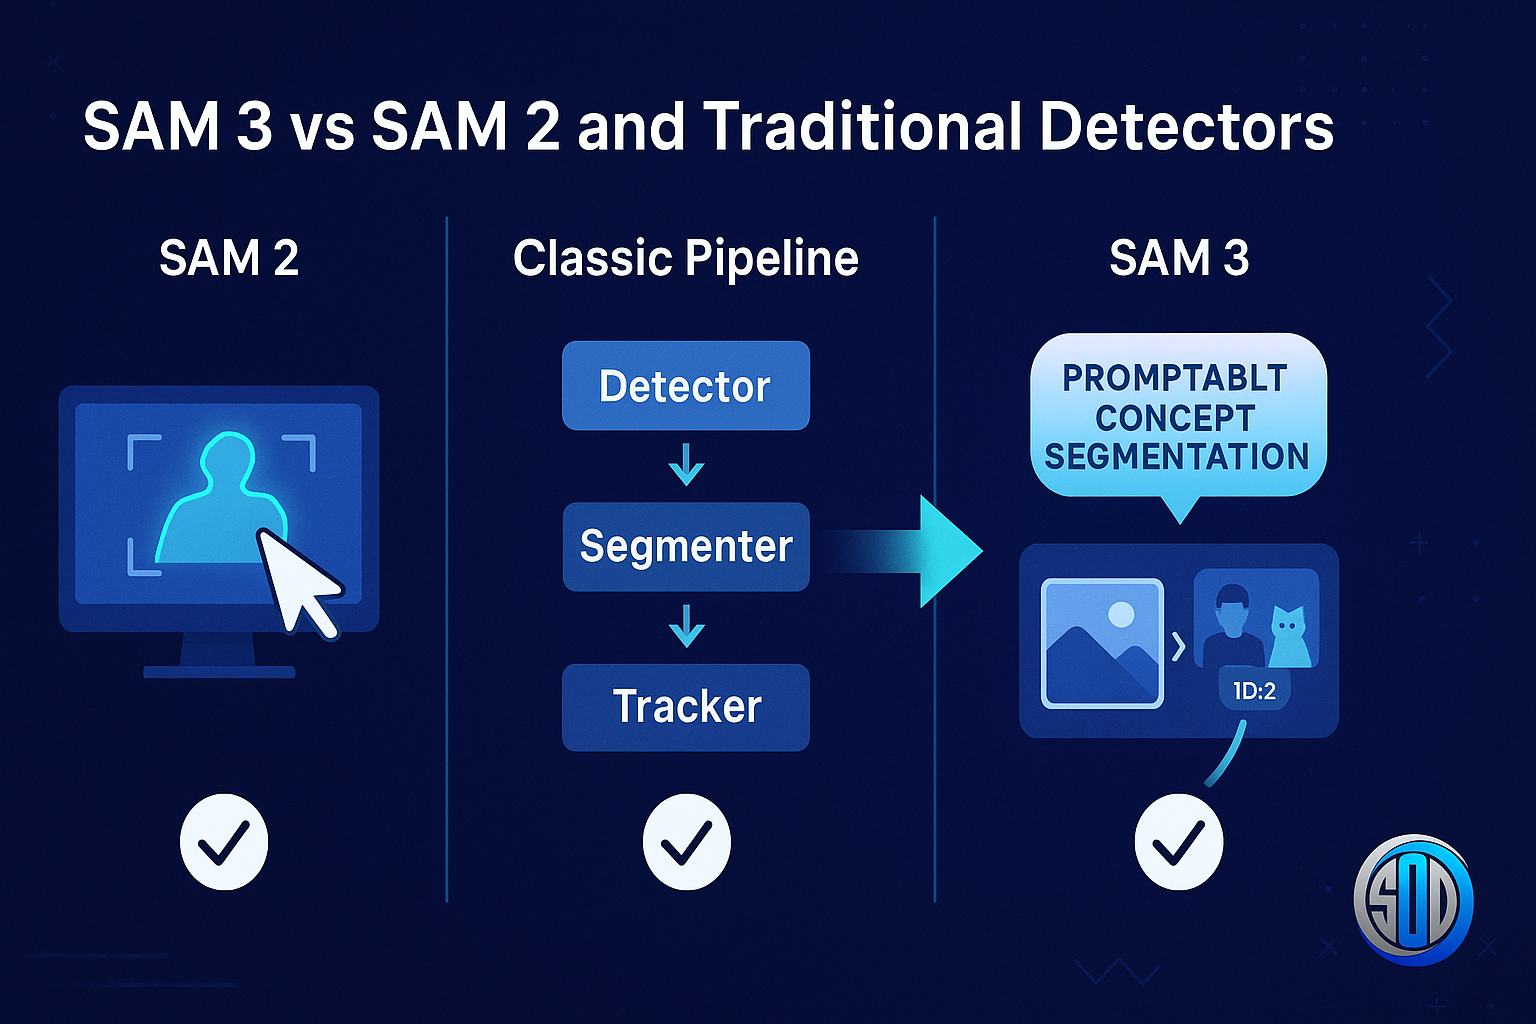
SAM 3 logra aproximadamente el doble de rendimiento que los sistemas anteriores en las pruebas comparativas de segmentación de conceptos mediante indicaciones, sin dejar de ser potente para la segmentación interactiva.
Flexibilidad inmediata
SAM 2: sólo indicaciones visuales (puntos/cuadros/máscaras).
SAM 3: texto, ejemplos, indicaciones visuales o combinaciones.
Alcance de la operación
SAM 2: excelente para “segmentar este objeto aquí” en imágenes/videos.
SAM 3: diseñado para “segmentar cada instancia de este concepto en imágenes/vídeos”.
Comportamiento de vocabulario abierto
SAM 2 se generaliza bien, pero sin una base lingüística explícita.
SAM 3 integra explícitamente el lenguaje, permitiendo indicaciones como “persona sosteniendo un teléfono inteligente” o “pequeñas embarcaciones cerca de la orilla”.
En comparación con las canalizaciones clásicas de detección y segmentación
Las tuberías tradicionales a menudo combinan:
Un detector (por ejemplo, YOLO, Faster R-CNN) para cuadros delimitadores
Un modelo de segmentación (por ejemplo, Mask R-CNN, DeepLab) para máscaras
Un rastreador (por ejemplo, SORT, ByteTrack) para vincular objetos entre marcos
SAM 3 pretende unificar estos pasos en un solo modelo:
Modelo de base única para la detección, segmentación y seguimiento de conceptos.
Vocabulario abierto : no limitado por una lista de clases fija.
Comportamiento controlable mediante indicaciones : comportamiento controlado por el lenguaje y los ejemplos.
Eso no significa que los detectores clásicos estén obsoletos (los modelos al estilo YOLO aún pueden ser más eficientes para la detección pura en conjuntos de etiquetas fijos), pero para una comprensión visual flexible y abierta, SAM 3 ofrece una solución más general.
6. Casos de uso reales para SAM 3
SAM 3 no es sólo un juguete académico; Meta ya lo está integrando en sistemas y herramientas de producción.
A continuación se presentan algunos escenarios concretos en los que SAM 3 tiene un impacto especial:
6.1. Creación y etiquetado de conjuntos de datos a gran escala
Si está creando un conjunto de datos para:
Conducción autónoma
Robótica
Analítica minorista
Imágenes médicas (cuando existan indicaciones o conjuntos de datos apropiados)
A menudo es necesario segmentar miles o millones de instancias de objetos. SAM 3 puede:
Utilice indicaciones de texto ("peatón", "bicicleta", "semáforo") para segmentar automáticamente a los candidatos.
Utilice pocos ejemplos para adaptarse rápidamente a nuevos tipos de objetos.
Proporciona identificadores de seguimiento consistentes en todos los fotogramas de vídeo, lo que acelera enormemente la anotación.
Los anotadores humanos pueden luego verificar y refinar estas máscaras en lugar de dibujar todo desde cero.
6.2. Comprensión y análisis de vídeo
Para análisis de vídeo:
“Rastrea a todas las personas que entran por esta puerta durante el día”.
“Segmente todos los vehículos que pasan por el carril más a la izquierda”.
“Detectar y segmentar todos los artículos colocados en un estante específico”.
SAM 3 puede gestionar estas solicitudes basadas en conceptos en un único marco unificado manteniendo identidades de objetos estables.
6.3. AR/VR y herramientas creativas
Meta destaca su uso en aplicaciones de consumo, incluidas funciones de edición mejoradas en herramientas como el flujo de edición multimedia de Instagram.
Ejemplos:
Los creadores pueden solicitar “resaltar a todas las personas” o “seleccionar el cielo y las montañas” para aplicar efectos.
Los usuarios pueden eliminar o rediseñar conceptos específicos (“cambiar todos los autos a azules”) sin necesidad de tediosas máscaras manuales.
6.4. Robótica e IA encarnada
Para los robots que operan en el mundo real, la segmentación a nivel de concepto es increíblemente útil:
“Recoge todos los bloques rojos”.
“Evite a las personas y a las mascotas”.
“Coloca todas las herramientas en el banco de trabajo”.
Las funciones de seguimiento de conceptos y vocabulario abierto de SAM 3 facilitan la conexión de instrucciones simbólicas (lenguaje) con la percepción visual fundamentada en entornos dinámicos.
7. Experiencia práctica con SAM 3
Meta ha lanzado SAM 3 abiertamente, incluyendo:
Una página dedicada al producto y a la documentación.
Un repositorio oficial de GitHub con código para inferencia y ajuste fino.
Puntos de control y configuraciones del modelo en Hugging Face.
Un espacio de experimentación interactiva con Segment Anything para la experimentación en el navegador.
Flujo de trabajo típico (de alto nivel)
Instalar dependencias y descargar puntos de control
Siga las instrucciones del
facebookresearch/sam3repositorio para instalar los paquetes de Python necesarios y recuperar los pesos del modelo.
Cargar un modelo SAM 3
Elija una variante (por ejemplo, base/grande), cárguela desde el punto de control y muévala a su dispositivo preferido (CPU/GPU).
Prepara tu mensaje
Mensaje de texto, ejemplos de imágenes o ambos.
Ejecutar inferencia
Llame a la API adecuada desde el repositorio de GitHub para obtener máscaras e identidades de seguimiento para sus imágenes/videos.
Posprocesar y visualizar
Superponga máscaras en los cuadros, rastree identificaciones a lo largo del tiempo, exporte a formatos de anotación (COCO, YOLO, etc.) o integre en canales posteriores.
Los documentos oficiales y los tutoriales de terceros (por ejemplo, Roboflow, Ultralytics, blogs de la comunidad) ya muestran ejemplos completos del uso de SAM 3 para la segmentación y el seguimiento a nivel de concepto.
8. Limitaciones, desafíos y preguntas abiertas
Por impresionante que sea SAM 3, no es una varita mágica. Algunas advertencias importantes:
8.1. Lenguaje ambiguo o complejo
El vocabulario abierto es poderoso, pero indicaciones como "coche genial" u "objeto interesante" son impredecibles. Incluso indicaciones más precisas ("persona con una bolsa roja") pueden ser complicadas en escenas confusas o casos extremos.
Diseñar buenos estímulos y agregar ejemplos seguirá siendo importante para lograr un comportamiento sólido.
8.2. Requisitos de cómputo y memoria
SAM 3 es un modelo de base grande. Para ejecutarlo en vídeos de alta resolución, especialmente para grandes conjuntos de datos, se requiere:
Memoria de GPU significativa
Estrategias eficientes de procesamiento por lotes y transmisión
Integración cuidadosa en los sistemas de producción
Para tareas livianas o de borde, los detectores clásicos o modelos de segmentación más pequeños aún pueden ser preferibles.
8.3. Sesgo y equidad
Debido a que SAM 3 está entrenado con datos visuales y textuales a gran escala, puede heredar:
Sesgos en los conjuntos de datos
Sesgo geográfico, demográfico y contextual
Se requiere una evaluación cuidadosa al utilizar SAM 3 en áreas sensibles (p. ej., vigilancia, contratación, triaje médico). La versión abierta permite auditorías externas, pero la implementación responsable sigue estando en manos de los profesionales.
8.4. Vídeo de horizonte largo y oclusión
El seguimiento de muchas instancias conceptuales en vídeos largos con oclusiones intensas sigue siendo un problema complejo. SAM 3 mejora con respecto a SAM 2, pero seguirá habiendo cambios de identidad, objetos perdidos y máscaras ruidosas, especialmente en escenas con mucha gente o poca visibilidad.
9. Por qué es importante SAM 3
SAM 3 es importante por varias razones:
Unificación de tareas
La detección, la segmentación y el seguimiento se integran en un modelo base en lugar de tres canales separados.
Segmentación por idioma nativo
Puede controlar la percepción visual directamente con el texto, conectando los modelos de lenguaje y los modelos de visión de forma más natural.
Escalando desde la interacción hasta la recuperación
Los primeros modelos SAM se centraban en la interacción con imágenes y fotogramas individuales.
SAM 3 escala para “recuperar todas las instancias de X” en grandes corpus de imágenes y videos.
Apertura del ecosistema
Meta publicó pesos, puntos de referencia y código, lo que permite a los investigadores y equipos de la industria ajustar, adaptar y desarrollar sobre SAM 3
En muchos sentidos, SAM 3 hace por la segmentación lo que los sistemas modernos de gestión del lenguaje hicieron por el lenguaje: convierte una herramienta específica para una tarea concreta en un sistema fundamental de propósito general que permite la generación de indicaciones.
Conclusión
SAM 3 marca un cambio claro en cómo pensamos sobre la segmentación: de “dibujar máscaras alrededor de los objetos” a “pedir conceptos y dejar que el modelo se encargue del resto”.
Al unificar la detección, la segmentación y el seguimiento en torno a la segmentación de conceptos mediante indicaciones , y al convertir las indicaciones de texto y ejemplos en elementos de primera clase, SAM 3 abre la puerta a:
Creación de conjuntos de datos más rápida y económica
Análisis de vídeo más flexible
AR/VR más inteligentes y herramientas creativas
Mayor percepción de robots y agentes encarnados
Aún queda mucho trabajo por delante (reducir las necesidades de procesamiento, gestionar indicaciones complejas, mitigar sesgos y mejorar el seguimiento a largo plazo), pero la dirección es clara.
Si SAM significaba "segmentar cualquier cosa que puedas señalar", SAM 3 se acerca más a "segmentar cualquier cosa que puedas describir ". Y eso supone un gran paso hacia sistemas de IA verdaderamente multimodales y conscientes de los conceptos, que ven el mundo de una forma un poco más parecida a la nuestra, pero sin la fatiga visual.