Introducción
Bienvenido a "Dominando el ajuste fino de los modelos de lenguaje grandes: estrategias de datos para una IA más inteligente" , una guía completa para transformar modelos de lenguaje grandes genéricos (LLM, por sus siglas en inglés) en herramientas especializadas que resuelven problemas del mundo real.
En la era de la IA, los modelos de lenguaje natural como GPT-4 y LLaMA han revolucionado industrias gracias a su capacidad para generar texto, analizar datos e incluso escribir código. Sin embargo, estos modelos, tal como vienen configurados, son generalistas : carecen de la precisión necesaria para tareas específicas como diagnosticar enfermedades raras, detectar fraudes financieros o redactar contratos legales. Aquí es donde entra en juego el ajuste fino.
¿Por qué esta serie?
El ajuste fino de un modelo LLM es más que un simple ejercicio técnico: es un proceso estratégico que depende de la calidad de los datos , las prácticas éticas y la eficiencia computacional . La mayoría de las guías se centran en fragmentos de código o conceptos teóricos, pero a menudo omiten el porqué y el cómo de la curación de datos, lo que deja a los modelos propensos a sesgos, ineficiencia o irrelevancia.
En esta serie aprenderás:
Cómo obtener, limpiar y ampliar datos para tareas específicas del dominio.
Técnicas para mitigar sesgos y garantizar el cumplimiento de las regulaciones globales.
Estrategias avanzadas como el aprendizaje federado y RLHF (aprendizaje de refuerzo a partir de la retroalimentación humana).
Estudios de casos reales de las industrias de atención médica, finanzas y derecho.
Ya sea usted ingeniero de aprendizaje automático, científico de datos o entusiasta de la IA, esta guía le proporcionará información práctica para crear modelos de aprendizaje automático más inteligentes , seguros y escalables.
Fundamentos de ajuste fino de LLM
¿Qué es el ajuste fino?
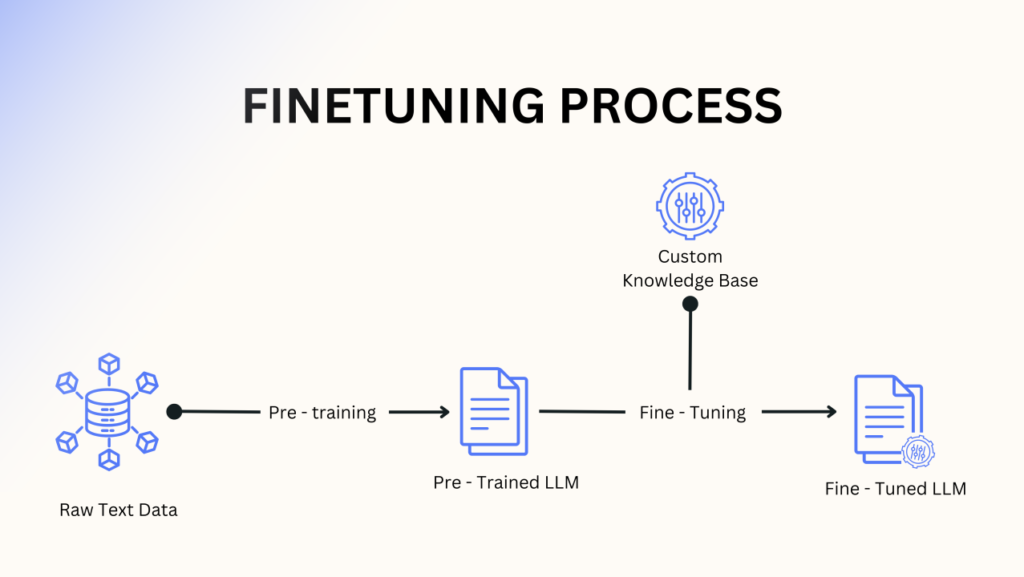
El ajuste fino adapta un LLM previamente entrenado (como GPT-4 o LLaMA) para especializarlo en una tarea específica al entrenarlo en un conjunto de datos más pequeño y específico del dominio.
Conceptos clave :
Aprendizaje por transferencia : Aprovechar el conocimiento adquirido en una formación previa general para resolver problemas específicos.
Olvido catastrófico : Un riesgo en el que el modelo “olvida” habilidades generales durante el ajuste fino. Se mitiga mediante técnicas como la consolidación elástica de pesos.
Análisis técnico en profundidad :
El ajuste fino actualiza los pesos del modelo mediante retropropagación y descenso de gradiente.
Las funciones de pérdida (por ejemplo, entropía cruzada) se adaptan a la tarea (clasificación, generación, etc.).
Ejemplo :
Un LLM preentrenado alcanza una precisión del 70 % en tareas de control de calidad médica. Tras perfeccionar 10,000 92 notas clínicas anotadas, la precisión alcanza el XNUMX %.
Visual :
Tablas/Datos :
| Tamaño de los datos de preentrenamiento | Ajuste fino del tamaño de los datos | Task | Ganancia de precisión |
|---|---|---|---|
| 1 billones de tokens | 10,000 muestras | Diagnostico medico | + 22% |
| 500 mil millones de tokens | 5,000 muestras | Revisión de contratos legales | + 18% |
Estrategias de recopilación de datos
Por qué es importante la recopilación de datos
El éxito en el ajuste fino depende de la calidad , la diversidad y la relevancia de los datos. Los datos deficientes pueden provocar ilusiones, sesgos o generalizaciones erróneas.
Fuentes de datos clave
1. Conjuntos de datos públicos
Ventajas :
Bajo costo y acceso rápido.
Cobertura amplia (por ejemplo, Common Crawl ).
Contras :
Ruido (texto irrelevante o de baja calidad).
Restricciones de licencia (por ejemplo, cumplimiento del RGPD).
Principales conjuntos de datos públicos para el ajuste fino:
| Conjunto de datos | Dominio | Tamaño | Caso de uso |
|---|---|---|---|
| WikiTexto | Lenguaje general | 100 millones de fichas | Línea base de modelado del lenguaje |
| PubMed | Sector Sanitario | 30 millones de resúmenes | Control de calidad médico |
| OpenLegal | Legal | 10 contratos | Análisis de contrato |
| Subtítulos de COCO | Visión + Texto | Imágenes 500K | Tareas multimodales |
2. Datos internos
Fuentes :
Interacciones con los clientes : Registros de chat, tickets de soporte, correos electrónicos.
Contenido propietario : manuales técnicos, wikis internas, repositorios de código.
Datos de sensores/transacciones : Para tareas específicas del dominio (por ejemplo, registros de dispositivos IoT).
Ejemplo:
Una empresa minorista utiliza reseñas de clientes y descripciones de productos para perfeccionar un LLM y ofrecer recomendaciones personalizadas.
Mejores prácticas :
Anonimización : Elimine la información de identificación personal (PII) utilizando herramientas como Presidio.
Control de versiones : Realice un seguimiento de las iteraciones del conjunto de datos con herramientas como DVC.
3. Datos sintéticos
Cuándo usarlo :
Datos limitados del mundo real (por ejemplo, condiciones médicas raras).
Restricciones de privacidad (por ejemplo, registros financieros).
Métodos de generación :
Plantillas basadas en reglas:
# Ejemplo: Generar cláusulas legales sintéticas
plantillas = [
    "El {partido} no {actuará} sin el consentimiento escrito de la {autoridad}.",
    "Cualquier disputa que surja en virtud de este contrato se regirá por la ley de {jurisdicción}".
]
las que elijas = {
    "fiesta": ["Concesionario", "Licenciante"],
    "acción": ["terminar", "modificar", "transferir"],
    "autoridad": ["la Junta", "el director ejecutivo"]
}
Contenido generado por LLM :
Utilice GPT-4, Claude o Llama 3 para simular datos (por ejemplo, consultas de clientes falsas).
Filtrar las salidas por relevancia y corrección.
Control de calidad:
Intervención humana : Que expertos revisen entre el 10% y el 20% de los datos sintéticos.
Verificación cruzada : Compare los resultados sintéticos con muestras del mundo real utilizando métricas como BLEU o ROUGE.
Comparación de fuentes de datos
| Aspecto | Datos públicos | Datos internos | Datos sintéticos |
|---|---|---|---|
| Costo | Bajo | Moderado | Bajo |
| Personalización | Limitada | Alto | Alto |
| Riesgo de privacidad | Moderado | Alto | Bajo |
| Uso recomendado | Tareas de referencia | Uso específico del dominio | Datos sensibles/escasos |
Herramientas para la recopilación de datos
| Función | Flujo de trabajo de ejemplo | |
|---|---|---|
| Abrazando la cara | Alojamiento y conservación de conjuntos de datos | Carga datasets.load_dataset("pubmed") |
| Esnórquel | Débil supervisión del etiquetado | Crear funciones de etiquetado para preguntas frecuentes |
| Gretel | Generación de datos sintéticos | Generar registros sintéticos de pacientes |
| Escala AI | Etiquetado humano a escala | Anotar 10 XNUMX tickets de soporte |
Errores comunes y soluciones
Primaria:Sobreajuste a conjuntos de datos pequeños.
Solución:Combinar datos sintéticos y reales + utilizar regularización (por ejemplo, abandono).Primaria:Anotaciones sesgadas.
Solución:Utilice el consenso de múltiples anotadores + herramientas como Estudio de etiquetas.Primaria:Fuga de datos (datos de prueba en entrenamiento).
Solución: Divisiones estrictas de entrenamiento/prueba + hash (por ejemplo, Filtros de floración).
Estudio de caso: Detección de fraude financiero
Objetivo : Perfeccionar un modelo LLM para detectar descripciones de transacciones sospechosas.
Estrategia de datos :
Se recopilaron 1,000 ejemplos etiquetados de casos históricos de fraude.
Se generaron 5,000 patrones de fraude sintético utilizando plantillas basadas en reglas (por ejemplo, “Pago a {entidad desconocida} por {servicio ambiguo}”).
Datos aumentados con reemplazo de sinónimos (por ejemplo, “transferencia bancaria” → “transferencia bancaria”).
Resultado :
La precisión mejoró del 65 % al 91 % en las transacciones no vistas.
Abastecimiento ético y mitigación de sesgos
Por qué son importantes la ética y los sesgos
Los datos de entrenamiento sesgados dan lugar a resultados de modelos de aprendizaje automático injustos o perjudiciales (por ejemplo, recomendaciones de contratación discriminatorias, elaboración de perfiles raciales en la detección de fraudes). Las prácticas éticas de datos son fundamentales para el cumplimiento normativo (RGPD, Ley de IA) y la confianza del usuario.
Fuentes comunes de sesgo en los datos de LLM
| Tipo de sesgo | Mareas Ideales para Lecciones | Ejemplo |
|---|---|---|
| Sesgo de muestreo | Sub/sobrerrepresentación de grupos | Datos médicos sesgados hacia los pacientes masculinos |
| Sesgo de etiquetado | Subjetividad del anotador | “Asertivo” etiquetado como “agresivo” para las mujeres |
| Sesgo histórico | Desigualdades pasadas incrustadas en los datos | Los datos de denegación de préstamos reflejan racismo sistémico |
| Sesgo lingüístico | Sobrerrepresentación de las lenguas dominantes | 80% de los datos de entrenamiento en inglés |
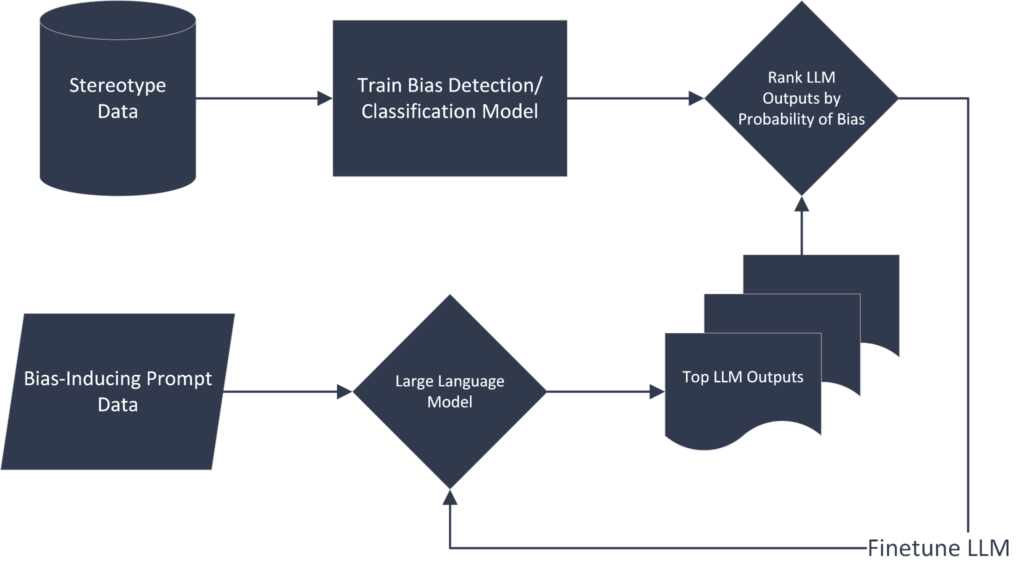
Marco de mitigación de sesgos paso a paso
1. Audite su conjunto de datos
Herramientas :
Métricas a monitorizar :
Relación de impacto dispar:
(Selection Rate for Protected Group) / (Selection Rate for Majority Group)Brechas de precisión : Diferencias de rendimiento entre distintos grupos demográficos.
Ejemplo:
Un chatbot de RRHH entrenado con datos de contratación sesgados muestra una tasa de recomendación un 25% menor para las candidatas femeninas.
2. Estrategias para eliminar sesgos
a) Preprocesamiento (nivel de datos)
Reponderación : Asigne ponderaciones más altas a los grupos subrepresentados durante la capacitación.
# Ejemplo: Ajustar los pesos de muestra para el desequilibrio
desde aprender.utils.peso_clase importar calcular_peso_de_muestra pesos_de_muestra = calcular_peso_de_la_muestra(peso_clase="equilibrado", y=etiquetas_de_tren)
Sobremuestreo : Utilice técnicas como SMOTE o NLPAug para datos de texto.
b) Procesamiento interno (nivel de modelo)
Eliminación de sesgos adversariales : Entrene el modelo para eliminar atributos sensibles (por ejemplo, género, raza) de las incrustaciones.

Restricciones de equidad : penalice las predicciones sesgadas utilizando bibliotecas como TensorFlow Constrained Optimization.
c) Posprocesamiento (nivel de salida)
Calibración : Ajustar los umbrales de predicción para diferentes grupos.
Opciones de rechazo : Marque los resultados inciertos o sesgados para su revisión humana.
3. Diversificar las fuentes de datos
Diversidad lingüística : Incluir lenguas con pocos recursos (por ejemplo, suajili, bengalí) utilizando conjuntos de datos como OSCAR.
Diversidad demográfica : Colabore con anotadores globales a través de plataformas como Appen o Remotasks.
Lista de verificación para la diversidad :
Incluya dialectos (por ejemplo, inglés vernáculo afroamericano).
Equilibrar género y raza en los equipos de anotadores.
Validar la representación geográfica.
Estudio de caso: Mitigación del sesgo de género en la selección de currículums
Problema : Un programa de maestría en derecho (LLM) para la clasificación de currículos favorecía a los candidatos masculinos en puestos tecnológicos.
Solución :
Auditoría : Fairlearn reveló una disparidad del 30% en las tasas de recomendación.
Eliminación de sesgos :
Reponderación : Se duplicó el peso de los currículos femeninos.
Entrenamiento adversario : Se eliminaron las señales de género de las incrustaciones.
Procesamiento posterior : Se ajustaron los umbrales de puntuación para las candidatas femeninas.
Resultado :
| Métrico | Antes | Después |
|---|---|---|
| Disparidad de género | 30% | 5% |
| Precisión general | 82% | 85% |
Herramientas para una IA ética
| Función | |
|---|---|
| IBM AI Fairness 360 | Detección y mitigación integral de sesgos |
| Evaluación de la cara abrazada | Métricas para la equidad del conjunto de datos/modelo |
| Themis | Sesgo de auditoría en la clasificación de textos |
Consideraciones reglamentarias
Ley de IA de la UE : Exige evaluaciones de sesgo para los sistemas de IA de alto riesgo.
ISO 42001 : Normas para la ética y la transparencia en la IA.
Errores comunes y soluciones
Primaria:La sobrecompensación del sesgo conduce a una discriminación inversa.
Solución:Utilice métricas de imparcialidad que equilibren la precisión y la equidad.Primaria:Ignorar la interseccionalidad (por ejemplo, raza + género).
Solución:Subgrupos de auditoría (por ejemplo, mujeres negras, veteranos discapacitados).
Análisis profundo: Entrenamiento adversarial para la eliminación de sesgos
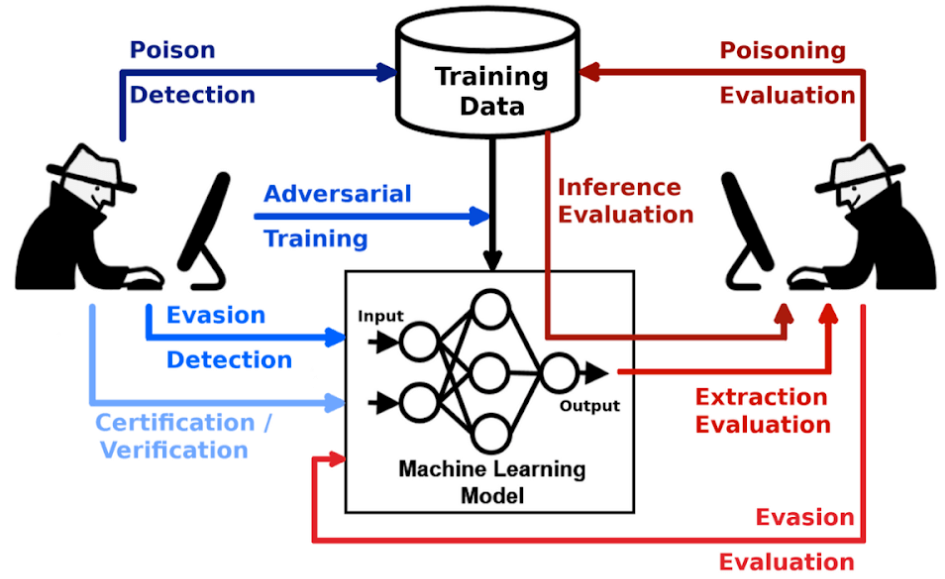
El entrenamiento adversario es una técnica que obliga a un modelo a eliminar atributos sensibles (por ejemplo, género, raza) de sus representaciones internas, manteniendo al mismo tiempo el rendimiento en la tarea. Así es como funciona:
1. Arquitectura de interiores
Modelo principal : Predice la tarea objetivo (por ejemplo, la selección de currículos).
Modelo adversario : Predice el atributo protegido (por ejemplo, el género) a partir de las incrustaciones del modelo principal.
2. Proceso de entrenamiento
El modelo principal tiene como objetivo maximizar la precisión de la tarea, minimizando al mismo tiempo la capacidad del adversario para predecir los atributos protegidos.
El adversario intenta maximizar la precisión de la predicción de atributos protegidos.
Pseudocódigo de PyTorch :
# Definir el modelo principal (por ejemplo, BERT) y el adversario (por ejemplo, MLP)
modelo primario = Clasificación BertForSequence()
adversario = antorcha.nn.Secuencial(antorcha.nn.Lineal(768, 1))  # 768-incrustaciones dim

# Funciones de pérdida
pérdida de tarea = CruzEntropíaPérdida()
pérdida del adversario = BCEWithLogitsLoss()

# Bucle de entrenamiento adversarial
por la lote in cargador de datos:
    # Paso hacia adelante a través del modelo principal
    salidas = modelo primario(lote["ID de entrada"])
    incrustaciones = salidas.estados ocultos[-1][:, 0, :]  # Incrustaciones de tokens CLS

    # El adversario predice un atributo protegido (por ejemplo, el género)
    protegidos_preds = adversario(incrustaciones)
    pérdida de publicidad = pérdida del adversario(protegidos_preds, lote["etiquetas_de_género"])

    # Pérdida de tareas (por ejemplo, clasificación del currículum)
    pérdida de tarea = pérdida de tarea(salidas.logits, lote["etiquetas_de_tarea"])

    # Pérdida total: task_loss - λ * adv_loss (minimiza la pérdida de la tarea, maximiza la pérdida del adversario)
    pérdida total = pérdida de tarea + parámetro lambda * (-pérdida de publicidad)
    pérdida total.hacia atrás()
    optimizador.paso()
Hiperparámetros clave :
λ (lambda_param) : Controla el equilibrio entre el rendimiento de la tarea y la equidad (por ejemplo, λ = 0.1).
Complejidad del adversario : Las redes de adversarios más profundas pueden detectar sesgos más sutiles.
3. Caso práctico: Eliminación del sesgo de género en la contratación
Conjunto de datos : 10,000 currículos etiquetados con el género (inferido a partir de los nombres) y los resultados de la contratación.
Resultado :
Sin entrenamiento adversario : El adversario predijo el género con un 85 % de precisión a partir de las incrustaciones.
Con el entrenamiento adversario : la precisión del adversario se redujo al 52 % (casi aleatoria), mientras que la precisión de la tarea se mantuvo estable.
Herramientas regulatorias y marcos de cumplimiento
Implementar una IA ética requiere alinearse con las regulaciones en constante evolución. A continuación, se presenta un desglose de herramientas y estándares:
1. Reglamentos clave
| Regulación | <b></b><b></b> | Requisitos |
|---|---|---|
| Ley de IA de la UE | Sistemas de IA de alto riesgo (por ejemplo, contratación, atención médica) | Auditorías de sesgo, transparencia y supervisión humana |
| GDPR | Privacidad de datos de la UE | Explicabilidad, derecho a optar por no participar |
| ISO 42001, | Sistemas globales de gestión de IA | Directrices éticas, evaluaciones de riesgos |
2. Herramientas para el cumplimiento
a) IBM AI Fairness 360
Función : Detección y mitigación de sesgos de extremo a extremo.
Flujo de trabajo :
Cargue el conjunto de datos y defina atributos protegidos (por ejemplo, raza).
Calcular métricas de equidad (impacto dispar, paridad estadística).
Aplicar mitigadores (reponderación, eliminación del sesgo adversarial).
desde aif360.conjuntos de datos importar Conjunto de datos de etiquetas binarias
desde aif360.algoritmos.preprocesamiento importar Repesando

# Cargar conjunto de datos
datos = Conjunto de datos de etiquetas binarias(df=df, nombres de etiquetas=['contratar'], nombres de atributos protegidos=['carrera'])

# Aplicar repesaje
rw = Repesando(grupos sin privilegios=[{'carrera': 0}], grupos privilegiados=[{'carrera': 1}])
conjunto de datos_transformado = rw.encajar_transformar(datos)
b) Evaluación del abrazo facial
Función : Evaluar los modelos en cuanto a imparcialidad, toxicidad y sesgo.
Ejemplo : Calcular el sesgo de género en la generación de texto:
importar evaluar el sesgo = evaluar.carga("inclinación")

Resultados  = parcialidad.calcular(
    predicciones=["La enfermera dijo...", "El ingeniero dijo..."],
    atributo protegido="género",
    atributo_objetivo="ocupación"
)
Imprimir(Resultados ["puntuación de sesgo de género"])
c) La herramienta "Qué pasaría si..." de Google
Función : Visualizar el rendimiento del modelo en diferentes subgrupos.
Caso de uso : Comparar las tasas de falsos positivos entre diferentes razas en un modelo de aprobación de préstamos.

3. Lista de verificación de cumplimiento
Realice una auditoría de sesgo utilizando Fairlearn o Aequitas.
Documentar fuentes de datos y pautas de etiquetado.
Implementar tarjetas modelo (por ejemplo, Google Model Cards ).
Establecer canales de revisión humana para casos extremos.
Caso práctico: Cumplimiento de la Ley de IA de la UE para un chatbot de atención médica
Escenario : Un sistema LLM de verificación de síntomas implementado en Europa debe cumplir con la Ley de IA de la UE.
Medidas adoptadas :
Auditoría de sesgos : Se utilizó IBM AI Fairness 360 para detectar disparidades relacionadas con la edad en las sugerencias de diagnóstico.
Mitigación : Se aplicó entrenamiento adversario para eliminar el sesgo de edad en las incrustaciones.
Transparencia : Se publicó una ficha del modelo que detalla los datos de entrenamiento, las limitaciones y las métricas de sesgo.
Supervisión humana : Se integró un paso de revisión clínica para predicciones de alto riesgo (por ejemplo, síntomas de cáncer).
Resultado :
Pasó la evaluación de conformidad de la UE.
Se redujeron los falsos negativos en pacientes mayores de 65 años en un 40%.
Desafíos y Soluciones
| Desafío | Solución |
|---|---|
| Regulaciones conflictivas | Usar herramientas como Bastante IA para el mapeo de condicionalidad. |
| Altos costos de computación | Opte por un entrenamiento adversarial eficiente en parámetros (congele la mayoría de las capas). |
| Requisitos legales dinámicos | Suscríbete a las actualizaciones regulatorias a través de Luminoso. |
Técnicas de aumento de datos
¿Por qué aumentar los datos?
El aumento de datos expande artificialmente los conjuntos de datos de entrenamiento para mejorar la robustez y la generalización del modelo , especialmente cuando los datos etiquetados son escasos. En el caso de los modelos de lenguaje natural (LLM), mitiga el sobreajuste y mejora el rendimiento en tareas o lenguajes poco representados.
Métodos de aumento basados en texto
1. Reemplazo de sinónimos
Reemplace palabras con términos contextualmente similares preservando el significado.
Ejemplo:
Original: “El software falló debido a una fuga de memoria.”
Ampliado: “El programa falló debido a un desbordamiento de RAM.”
Herramientas :
NLPAug : Biblioteca de Python para sustituciones a nivel de palabra.
WordNet : Base de datos léxica de sinónimos.
importar nlpaug.augmenter.palabra clave as Naw

# Inicializar el aumentador de sinónimos
ago = Naw.SinónimoAgo(agosto_src='red de palabras')
texto aumentado = ago.aumentar("El modelo logró una alta precisión".)
Imprimir(texto aumentado)  # "El sistema alcanzó una alta precisión."
2. Retrotraducción
Traduce texto a otro idioma y de vuelta al original. Introduce diversidad sintáctica.
Ejemplo :
Original (EN): “El paciente informó de fuertes dolores de cabeza.”
Traducido al francés: “Lepatient a signalé des maux de tête sévères”.
Traducido de nuevo al inglés: “El paciente informó de migrañas severas.”
Herramientas :
Transformadores de cara abrazados (por ejemplo,
facebook/m2m100modelo).API de Google Translate.
Impacto :
En una tarea de análisis de la opinión del cliente, la retrotraducción mejoró la puntuación F1 en un 15 % para los idiomas con pocos recursos.

3. Parafrasear con LLM
Utilice LLM como GPT-4 o Claude para reformular oraciones conservando el significado semántico.
Ejemplo de solicitud :
Parafraseando este texto formalmente: “La aplicación se congela constantemente cuando subo fotos”.
Resultado:
“La aplicación experimenta constantemente problemas de latencia durante la carga de archivos multimedia”.
Mejores prácticas :
Ajuste de temperatura: uso
temperature=0.7Para equilibrar creatividad y consistencia.Control de calidad: Filtre los resultados con métricas como BERTScore.
4. Aumento contextual
Enmascarar palabras aleatorias y predecir reemplazos utilizando modelos de estilo BERT.
Ejemplo :
Original: “Las [MASK] se dispararon tras el informe de ganancias.”
Ampliado: “Las acciones se dispararon tras la publicación del informe de ganancias”.
Herramientas :
TextAttack : Marco de trabajo para perturbaciones contextuales.
Aumento de datos estructurados
Para datos tabulares, de código o multimodales:
1. Datos tabulares
Inyección de ruido:Añadir ruido gaussiano a las características numéricas (por ejemplo,
age = 30 ± 2).Perturbación por intercambio : Intercambia valores entre filas (por ejemplo, intercambia el "salario" entre dos empleados).
2. código
Cambio de nombre de variables:
def calculate_sum(x, y)→def compute_total(a, b).Transformaciones que preservan la lógica : Convierte bucles en comprensiones de listas.
Ejemplo :
# Original
por la i in distancia(10):
    Imprimir(i * 2)

# Aumentada
Imprimir([i * 2 por la i in distancia(10)])
Flujo de trabajo de aumento de datos
Analizar las lagunas de datos : Identificar clases o patrones subrepresentados.
Seleccione las técnicas : priorice los métodos que se ajusten a los objetivos de la tarea (por ejemplo, la retrotraducción para brindar soporte multilingüe).
Generar y filtrar : Eliminar ejemplos de baja calidad utilizando puntuaciones de similitud (por ejemplo, similitud del coseno < 0.7).
Evaluar : Probar los datos aumentados en un conjunto de validación.

Estudio de caso: Ampliación de un modelo de análisis de sentimientos
Problema : El modelo LLM de una startup para reseñas de productos tenía una precisión del 90% en inglés, pero solo del 60% en español debido a la limitación de datos.
Solución :
Tradujo 1,000 reseñas del inglés al español mediante traducción inversa.
Se utilizó GPT-4 para generar 500 reseñas sintéticas en español.
Se aplicó la sustitución de sinónimos para diversificar el vocabulario.
Resultados :
| Idioma | Precisión (Antes) | Precisión (después) |
|---|---|---|
| Español | 60% | 85% |
| Inglés | 90% | 91% |
Comparación de herramientas
| Método | Uso recomendado | |
|---|---|---|
| NLPAug | Reemplazo de sinónimos | Perturbaciones rápidas de texto |
| Ataque de texto | Ediciones contextuales | Robustez adversaria |
| Gretel | Datos sintéticos | Tareas sensibles a la privacidad |
| Abrazando la cara | Parafraseando | Reformulación de alta calidad |
Errores y soluciones
Sobreaumento :
Síntomas : El ruido enmascara la señal (por ejemplo, "El software es excelente" → "La aplicación es terrible").
Solución : Utilizar umbrales de similitud semántica (por ejemplo, filtrar las salidas con BERTScore < 0.8).
Degradación del lenguaje :
Síntomas : La retrotraducción produce frases poco naturales.
Solución : Utilice modelos avanzados (por ejemplo, GPT-4 en lugar de los modelos seq2seq más antiguos).
Técnicas avanzadas
Mixup for Text : Combina incrustaciones de dos oraciones (por ejemplo, interpola reseñas "positivas" y "negativas").
Aumento basado en GAN : Entrenar un generador para crear datos sintéticos (por ejemplo, CycleGAN para la transferencia de estilo).
GAN (redes generativas adversarias)
Las GAN son una clase de redes neuronales que generan datos sintéticos enfrentando dos modelos entre sí:
Generador : Crea datos falsos.
Discriminador : Distingue entre datos reales y falsos.
Cómo funcionan las GAN para el aumento de texto
Generador : Recibe ruido aleatorio como entrada y genera texto sintético como salida.
Discriminador : Evalúa si el texto es real (del conjunto de entrenamiento) o falso (del generador).
Entrenamiento adversario : El generador mejora hasta que el discriminador ya no puede distinguir entre lo real y lo falso.
Desafíos con las GAN de texto
Salidas discretas : El texto no es diferenciable, lo que dificulta las actualizaciones basadas en gradientes.
Colapso de modo : El generador produce una variedad limitada de texto.
Evaluación : Medir la calidad del texto generado es subjetivo.
Implementación de GAN de texto
Ejemplo: SeqGAN (GAN de secuencia)
SeqGAN utiliza el aprendizaje por refuerzo (RL) para entrenar al generador, tratando la generación de texto como un proceso secuencial de toma de decisiones.
Flujo de trabajo de PyTorch :
importar antorcha
importar antorcha.nn as nn

# Generador (basado en LSTM)
clase Generador(nn.Módulo ):
    def __init__(yo, tamaño del vocabulario, embedded_dim, oculta_dim):
        súper ().__init__()
        yo.incrustación = nn.Incrustar(tamaño del vocabulario, embedded_dim)
        yo.lstm = nn.LSTM(embedded_dim, oculta_dim)
        yo.fc = nn.Lineal(oculta_dim, tamaño del vocabulario)

    def HACIA EL FUTURO(yo, ruido):
        integrado = yo.incrustación(ruido)
        salida, _ = yo.lstm(integrado)
        logits = yo.fc(salida)
        volvemos logits

# Discriminador (basado en CNN)
clase Discriminado(nn.Módulo ):
    def __init__(yo, tamaño del vocabulario, embedded_dim):
        súper ().__init__()
        yo.incrustación = nn.Incrustar(tamaño del vocabulario, embedded_dim)
        yo.conv1 = nn.Conv1d(embedded_dim, 128, tamaño_del_núcleo=3)
        yo.fc = nn.Lineal(128, 1)

    def HACIA EL FUTURO(yo, envíenos mensaje de texto):
        integrado = yo.incrustación(envíenos mensaje de texto).trueque(0, 2, 1)  # [lote, incrustar, seq_len]
        Características = antorcha.reanudación(yo.conv1(integrado)).max(oscuro=2)[0]
        volvemos antorcha.sigmoideo(yo.fc(Características))

# Bucle de entrenamiento (simplificado)
generador = Generador(tamaño del vocabulario=10000, embedded_dim=256, oculta_dim=512)
discriminado = Discriminado(tamaño del vocabulario=10000, embedded_dim=256)

por la época in distancia(100):
    # Discriminador de trenes
    datos reales = cargar_lote_de_texto_real()  # [tamaño_de_lote, longitud_de_secuencia]
    datos falsos = generador(antorcha.Randn(tamaño del lote, longitud de secuencia))
    pérdida_real = BCEWithLogitsLoss(discriminado(datos reales), antorcha.las(tamaño del lote))
    pérdida_falsa = BCEWithLogitsLoss(discriminado(datos falsos.despegar()), antorcha.Ceros(tamaño del lote))
    pérdida_d = pérdida_real + pérdida falsa pérdida d.hacia atrás()
    optimizador_d.paso()

    # Generador de trenes (a través del gradiente de política)
    recompensas = discriminado(datos falsos)  # Recompensa = confianza del discriminador
    brillo = -antorcha.mean(antorcha.log(recompensas))  # Maximizar la recompensa
    brillo.hacia atrás()
    optimizador_g.paso()
Mejoras clave :
Gumbel-Softmax : Aproximación diferenciable para la generación de texto discreto.
Wasserstein GAN (WGAN) : Utiliza la distancia del transportador de tierra para un entrenamiento estable.
Estudio de caso: GAN para la ampliación de textos médicos
Objetivo:Generar notas clínicas sintéticas para entrenar un LLM para enfermedades raras.
Método:
Entrenó una GAN con 1,000 notas clínicas reales.
Usé el generador para crear 5,000 notas sintéticas.
BioBERT ajustado en el conjunto de datos aumentados.
Resultados :
| Métrico | Solo datos reales | Real + Sintético |
|---|---|---|
| Exactitud | 72% | 88% |
| Recordar | 65% | 82% |
2. Mixup para texto
Mixup es una técnica de regularización que interpola linealmente pares de entradas y etiquetas para crear datos aumentados. Diseñada originalmente para imágenes, se ha adaptado para texto en el espacio de incrustación.
Cómo funciona Mixup para el texto
Interpolación de incrustación :
Tome dos oraciones de entrada y sus incrustaciones.
Generar una nueva incrustación:
embedmix = λ ⋅ embed1 + (1 − λ) ⋅ embed2 embed mix = λ ⋅ embed 1 + ( 1 − λ ) ⋅ embed 2
La etiqueta se interpola de manera similar:
ymix = λ ⋅ y1 + (1 − λ) ⋅ y2 y mix = λ ⋅ y1 + ( 1 − λ ) ⋅ y2
Decodificación : Mapear la incrustación mixta de vuelta al espacio de tokens (opcional).

Implementación de Mixup para texto
Ejemplo con incrustaciones BERT
desde transformers importar BertModelo, BertTokenizer
importar tokenizador de antorcha = BertTokenizer.de_preentrenado('bert-base-sin carcasa')
modelo = BertModelo.de_preentrenado('bert-base-sin carcasa')

# Dos oraciones de entrada
oración1 = "¡La película fue fantástica!"
oración2 = "La película fue terrible."

# Tokenizar y obtener incrustaciones
entradas1 = tokenizer(oración1, tensores de retorno="pt")
entradas2 = tokenizer(oración2, tensores de retorno="pt")
incrustaciones1 = modelo(**entradas1).último estado oculto.mean(oscuro=1)  # [1, 768]
incrustaciones2 = modelo(**entradas2).último estado oculto.mean(oscuro=1)

# Confusión
parámetro lambda = 0.7  # Relación de mezcla
incrustación mixta = parámetro lambda * incrustaciones1 + (1 - parámetro lambda) * incrustaciones2

# (Opcional) Decodificar incrustación mixta (experimental)
# Requiere entrenar un decodificador o usar VAE
Variantes avanzadas
SentMix : Combina incrustaciones de oraciones y las decodifica con un decodificador GPT-2.
TMix : Mezcla estados ocultos entre capas de transformadores.
Caso práctico: Análisis de sentimientos mediante la confusión
Objetivo:Mejorar la solidez de un clasificador de sentimientos en reseñas ambiguas.
Método:
Se aplicó Mixup a las incrustaciones de reseñas positivas/negativas.
Se entrenó un clasificador en las incrustaciones interpoladas.
Resultados :
| Métrico | Base | Con Mixup |
|---|---|---|
| Exactitud | 85% | 89% |
| Puntuación F1 | 83% | 88% |
GAN vs. Mixup: ¿cuándo utilizar cuál?
| Aspecto | GAN | Confusión |
|---|---|---|
| Tipo de datos | Texto, tabular, multimodal | Incrustaciones (texto, imágenes) |
| Caso de uso | Generación de conjuntos de datos sintéticos | Regularización de modelos |
| Complejidad: | Alta (inestabilidad del entrenamiento) | Bajo (interpolación simple) |
| Uso recomendado | Datos escasos y sensibles a la privacidad | Reducir el sobreajuste |
Puntos Clave
Las GAN destacan por generar datos sintéticos diversos, pero requieren una puesta a punto cuidadosa.
Mixup es un regularizador ligero y eficaz para mejorar la robustez del modelo.
Combine ambos métodos para el aumento y la regularización de datos (por ejemplo, entrene con datos generados por GAN + aplique Mixup durante el entrenamiento).
Preguntas Frecuentes
P: ¿Puede Mixup crear texto sin sentido?
R: Sí, la interpolación de incrustaciones puede no corresponder a oraciones coherentes. Úsela para regularización, no para generación directa de texto.
P: ¿Existen GAN que funcionen de manera inmediata para texto?
A: Inténtalo TextoGAN or GPT-3 para generación controlada.
P: ¿Cómo evaluar el texto generado por GAN?
A: Utilice métricas como AZUL, ROUGE, o evaluación humana.
Estudios de casos reales y lecciones aprendidas
Caso práctico 1: Atención sanitaria: diagnóstico de enfermedades raras
Primaria
Una red hospitalaria tuvo dificultades para diagnosticar trastornos genéticos raros debido a los limitados registros de pacientes anotados (solo 500 casos).
Solución
Generación de datos sintéticos : Se utilizó Gretel para crear 5,000 registros de pacientes sintéticos con GPT-4, garantizando el cumplimiento de la normativa HIPAA.
Aprendizaje activo : Se priorizaron los casos inciertos para la anotación por parte de expertos, reduciendo el esfuerzo de etiquetado en un 40 %.
Mitigación de sesgos : Se auditaron datos sintéticos para comprobar la diversidad demográfica utilizando Fairlearn.
Resultados
| Métrico | Línea base (solo datos reales) | Después del aumento |
|---|---|---|
| Precisión de diagnóstico | 62% | 88% |
| Falsos negativos | 28% | 9% |
Lecciones aprendidas :
Los datos sintéticos deben imitar el ruido del mundo real (por ejemplo, errores tipográficos en las notas clínicas).
Colaborar con los médicos desde el principio para validar la calidad de los datos.
Caso práctico 2: Finanzas – Detección de fraude
Primaria
El LLM de un banco para el análisis de fraudes en transacciones tuvo altos índices de falsos positivos (35%) debido a datos desequilibrados (99% de transacciones legítimas).
Solución
Aumento de datos :
Se generaron patrones de fraude sintético utilizando plantillas basadas en reglas (por ejemplo, “Pago a {entidad_desconocida} por {servicio_sospechoso}”).
Se aplicó la traducción inversa a descripciones de transacciones que no estaban en inglés.
Capacitación con criterios de costo : La ponderación de la clase de fraude es 10 veces mayor durante la capacitación.
Resultados
| Métrico | Antes | Después |
|---|---|---|
| Precisión | 65% | 92% |
| Falsos positivos | 35% | 8% |
Lecciones aprendidas :
La simple ampliación de datos no es suficiente; los ajustes algorítmicos (por ejemplo, los pesos de las clases) son fundamentales.
Los bucles de retroalimentación en tiempo real con analistas de fraude mejoraron iterativamente.
Caso práctico 3: Legal – Automatización de la revisión de contratos
Primaria
Una firma de abogados necesitaba extraer cláusulas (por ejemplo, términos de rescisión) de contratos antiguos, pero carecía de datos etiquetados.
Solución
Supervisión débil : Se utilizó Snorkel para crear heurísticas de etiquetado basadas en palabras clave (por ejemplo, "terminar", "fecha de vigencia").
Aprendizaje por transferencia : Se perfeccionó el modelo RoBERTa con documentos públicos presentados ante la SEC antes de especializarse en contratos.
Intervención humana : Los abogados revisaron el 10% de las predicciones del modelo para refinar los datos de entrenamiento.
Resultados
| Métrico | Revisión manual | LLM + Human-in-Loop |
|---|---|---|
| Tiempo por contrato | 45 minutos | 8 minutos |
| Cláusula de revocación | 95% | 98% |
Lecciones aprendidas :
El entrenamiento previo específico del dominio (presentaciones ante la SEC) proporcionó una mejor inicialización que los LLM de propósito general.
La escasa supervisión redujo los costes de etiquetado en un 70%.
Caso práctico 4: Venta minorista: Atención al cliente multilingüe
Primaria
El chatbot de una plataforma de comercio electrónico manejó bien las consultas en inglés, pero falló en español e hindi (65 % de precisión).
Solución
Retrotraducción : Se convirtieron 10 000 tickets de soporte en inglés a español/hindi y viceversa.
Regularización de mezcla : Incrustaciones interpoladas de consultas en inglés y en otros idiomas para mejorar la robustez.
Entrenamiento adversario : Se eliminó el sesgo lingüístico de las incrustaciones para evitar el sobreajuste a la sintaxis del inglés.
Resultados
| Idioma | Precisión (Antes) | Precisión (después) |
|---|---|---|
| Español | 65% | 89% |
| hindi | 60% | 82% |
Lecciones aprendidas :
La mezcla mejoró la generalización pero requirió un ajuste cuidadoso de λ (0.3-0.7 funcionó mejor).
Los tokenizadores específicos del idioma (por ejemplo, IndicBERT para hindi) mejoraron el rendimiento.
Herramientas en acción
| Experiencia | Herramientas clave | Propósito |
|---|---|---|
| Sector Sanitario | Gretel, Fairlearn, BioBERT | Datos sintéticos, auditorías de sesgo |
| Finanzas | Esnórquel, GPT-4, PyTorch | Supervisión débil, ponderación de clases |
| Legal | RoBERTa, spaCy, Label Studio | Extracción y anotación de cláusulas |
| Venta al Por Menor | NLPAug, Cara abrazada, TensorFlow | Aumento multilingüe, Mixup |
Errores comunes y soluciones
| Trampa | Solución |
|---|---|
| Sobreajuste a datos sintéticos | Limite los datos sintéticos al 30–50% del total. |
| Ignorar los casos extremos | Utilice el aprendizaje activo para descubrir muestras raras. |
| Subestimar los costos de computación | Comience con métodos de parámetros eficientes (LoRA). |
Puntos Clave
Los datos sintéticos no son la solución mágica : valide rigurosamente con expertos en la materia.
La mitigación de sesgos es innegociable : incorpore auditorías en cada flujo de trabajo.
Los enfoques híbridos son la clave del éxito : combinando el aumento de datos, el aprendizaje activo y la revisión humana.
Tendencias y herramientas futuras para el perfeccionamiento de LLM
1. Paradigmas emergentes de ajuste fino
a) Aprendizaje por refuerzo a partir de la retroalimentación humana (RLHF)
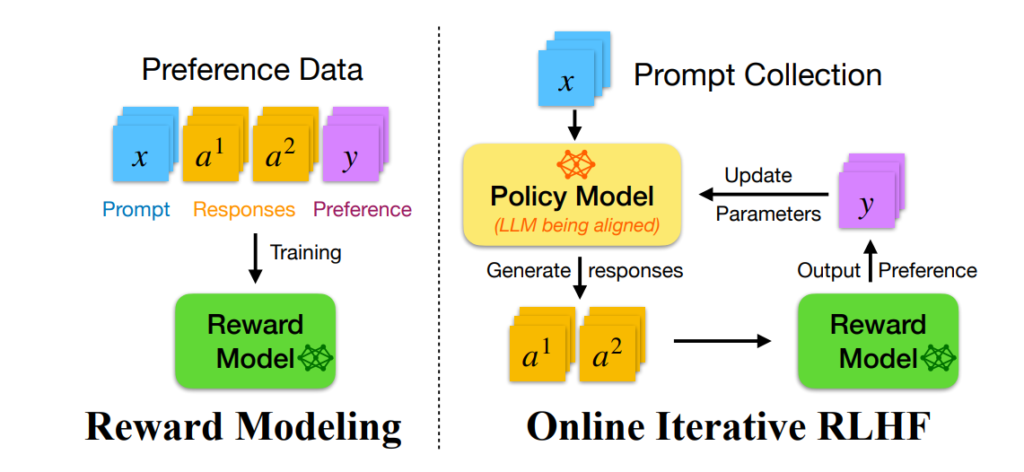
RLHF alinea los LLM con las preferencias humanas combinando el ajuste fino con el modelado de recompensas.
Cómo funciona :
Recopilar clasificaciones humanas de los resultados del modelo (por ejemplo, “La respuesta A es mejor que la respuesta B”).
Entrenar un modelo de recompensa para predecir las preferencias humanas.
Ajuste el LLM utilizando la Optimización de Políticas Proximales (PPO) para maximizar las recompensas.
Aplicaciones :
Reducir resultados dañinos (por ejemplo, ChatGPT de OpenAI).
Alineando los chatbots de ventas con la voz de la marca.
Herramientas :
TRL (Biblioteca de Aprendizaje por Refuerzo de Transformadores).
b) Ajuste fino multimodal
Adaptación de los sistemas de gestión del lenguaje natural (LLM) para procesar texto, imágenes y audio simultáneamente.
Ejemplo :
Ajuste Flamingo o GPT-4V para generar descripciones de productos a partir de imágenes.
Estrategia de datos :
Utilice el aprendizaje contrastivo para alinear las incorporaciones en todas las modalidades.
Utilice conjuntos de datos como LAION-5B para el preentrenamiento.
Desafíos :
Altos costos de computación (entrenamiento en datos 4D: lote × tiempo × alto × ancho).
Complejidad de anotación (por ejemplo, etiquetado de pares imagen-texto).
c) Ajuste fino en el dispositivo
Implementación de ajustes ligeros directamente en dispositivos de borde (teléfonos, sensores de IoT).
Técnicas :
TinyLoRA : Comprime adaptadores LoRA mediante cuantización.
Aprendizaje federado : Actualiza los modelos en diferentes dispositivos sin necesidad de datos centralizados.
Herramientas :
TensorFlow Lite para modelos optimizados para dispositivos móviles.
OpenFL para flujos de trabajo de aprendizaje federado.
2. Herramientas de gobernanza y cumplimiento de la IA
Los marcos regulatorios están presionando para que se realicen ajustes auditables y transparentes.
Herramientas clave:
| Función | Caso de uso | |
|---|---|---|
| Aprendizaje justo | Métricas de sesgo y mitigación | Informes de cumplimiento del RGPD/EEOC |
| Verificación de IA | Gobernanza de extremo a extremo (IMDA de Singapur) | Pistas de auditoría para modelos financieros |
| Tarjetas modelo | Documentación estandarizada (Google) | Transparencia en la IA en el sector sanitario |
Tendencia :
Las plataformas de cumplimiento automatizadas (por ejemplo, Holistic AI ) generarán informes de auditoría a través de API.
3. Plataformas de código abierto vs. plataformas comerciales
| Aspecto | Código abierto (por ejemplo, Hugging Face) | Comercial (por ejemplo, OpenAI, Cohere) |
|---|---|---|
| Costo | Gratuito/impulsado por la comunidad | Pago por token o suscripción |
| Personalización | Control total sobre datos y modelos | Limitado a las restricciones de la API |
| Cumplimiento | Autogestionado | El vendedor asume la responsabilidad |
| Uso recomendado | Investigación, casos de uso altamente especializados | Implementación rápida, escalabilidad |
4. Caso práctico: RLHF para atención al cliente
Problema : El chatbot de una compañía de telecomunicaciones a menudo sugería pasos de solución de problemas irrelevantes.
Solución :
Se recopilaron 10,000 XNUMX valoraciones de comentarios humanos sobre las respuestas del chatbot.
Entrenó un modelo de recompensa usando TRL.
Se ajustó el LLM con PPO para priorizar las respuestas mejor calificadas.
Resultados :
| Métrico | Antes de RLHF | Después de RLHF |
|---|---|---|
| Satisfacción del Cliente | 68% | 92% |
| Tasa de resolución | 45% | 81% |
5. Herramientas futuras a tener en cuenta
Kit de herramientas en el dispositivo de Llama 3 : el próximo conjunto de herramientas de Meta para el ajuste fino de LLM en dispositivos periféricos.
RLHF Cloud de Stability AI : Servicio gestionado para el aprendizaje por refuerzo ético.
Búsqueda de arquitectura neuronal (NAS) : herramientas de AutoML para diseñar capas de ajuste fino personalizadas.
Desafíos adelante
Eficiencia energética : Entrenamiento de modelos con más de mil millones de parámetros en energías renovables.
Soberanía de datos : Cómo desenvolverse en las leyes de protección de datos transfronterizas (por ejemplo, UE frente a China).
Ataques adversarios : Protección contra la inyección instantánea y el robo de modelos.
Puntos Clave
Los modelos RLHF y multimodales dominarán los sistemas de IA empresariales.
Las herramientas regulatorias son imprescindibles para los despliegues globales.
Las plataformas híbridas (de código abierto + comerciales) combinarán flexibilidad y escalabilidad.
Infografía: El futuro de la pila LLM

Contenido adicional 1: Entrevista con un especialista en ética de IA
La Dra. Maya Singh, especialista en ética principal del AI Governance Institute, comparte sus ideas sobre los desafíos éticos en el ajuste de los estudios de maestría en derecho.
P: ¿Cuáles son los riesgos éticos más pasados por alto en el perfeccionamiento del LLM?
Dr. Singh : “Tres riesgos clave me quitan el sueño:
Bucles de retroalimentación : Los modelos entrenados con datos generados por los usuarios (por ejemplo, redes sociales) amplifican los sesgos existentes. Un detector de discurso de odio entrenado con datos de Reddit llegó a etiquetar el inglés vernáculo afroamericano (AAVE) como "tóxico" un 65 % más a menudo que el inglés estándar.
Consentimiento informado : Muchas empresas procesan datos de clientes sin consentimiento explícito. ¿Los usuarios dieron su consentimiento para que sus tickets de soporte se utilizaran para entrenar chatbots?
Justicia ambiental : El entrenamiento de modelos masivos impacta de manera desproporcionada a las comunidades marginadas cercanas a los centros de datos. Una sola ejecución de entrenamiento de GPT-3 emite aproximadamente 500 toneladas de CO₂.”*
P: ¿Cómo pueden los equipos equilibrar la innovación con prácticas éticas?
Dr. Singh : “Incorpore a especialistas en ética en los equipos de ingeniería desde el primer día. En mi instituto, utilizamos un 'Marco 4D' :
Datos diversos : auditar los conjuntos de datos para comprobar su representación (género, raza, idioma).
Documentación : Publicar fichas de modelos que detallen las fuentes de datos y las limitaciones.
Control descentralizado : Permitir que los usuarios opten por no participar en la recopilación de datos.
Deber de diligencia : Asignar el 10% del presupuesto de computación a la mitigación de sesgos.”*
P: ¿Cuál es su opinión sobre los datos sintéticos para dominios sensibles?
Dr. Singh : “Es un arma de doble filo. Los registros médicos sintéticos evitan los riesgos de la HIPAA, pero pueden heredar sesgos del modelo generador. Recientemente, descubrimos que las notas de pacientes generadas por GPT-4 subestiman el dolor crónico en mujeres. Siempre valide los datos sintéticos comparándolos con distribuciones del mundo real.”
Contenido adicional 2: Análisis profundo del aprendizaje federado
Cómo optimizar los LLM en datos descentralizados sin comprometer la privacidad
¿Qué es el aprendizaje federado (FL)?
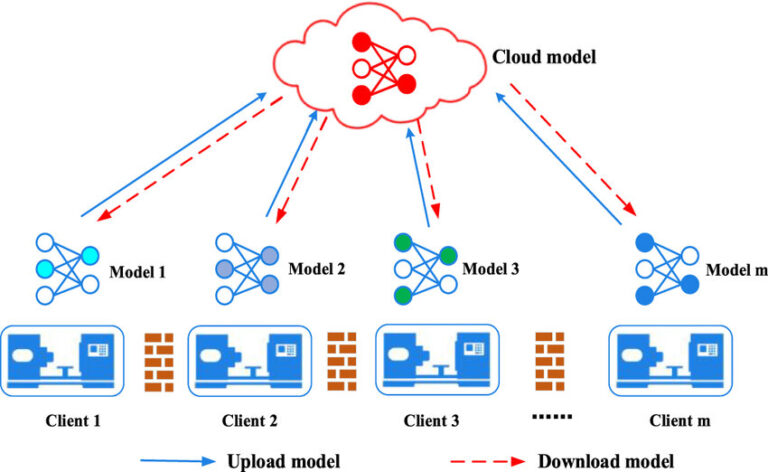
FL entrena modelos en dispositivos descentralizados (por ejemplo, teléfonos, hospitales) sin compartir datos brutos. Solo se agregan las actualizaciones del modelo (gradientes).
Ajustes de FL para LLM: paso a paso
Inicialización : El servidor distribuye un LLM base (por ejemplo, BERT) a los dispositivos.
Entrenamiento local : Cada dispositivo ajusta el modelo con sus propios datos.
Agregación segura : Las actualizaciones se cifran (por ejemplo, mediante cifrado homomórfico) y se promedian.
Actualización global : El servidor envía el modelo mejorado de vuelta a los dispositivos.
Fragmento de código (PyTorch + PySyft) :
importar antorcha
importar sift as sy

# Inicializar nodos FL (hospitales, en este caso)
Gancho. = sy.Antorcha con gancho(antorcha)
hospital1 = sy.Trabajador virtual(Gancho., id="hospital1")
hospital2 = sy.Trabajador virtual(Gancho., id="hospital2")

# Distribuir modelo
modelo global = Clasificación BertForSequence()
modelo global.send(hospital1)
modelo global.send(hospital2)

# Bucle de entrenamiento local
def entrenar_en_dispositivo(modelo, en):
    optimizador = antorcha.optimo.Adam(modelo.parámetros())
    por la lote in en:
        de = modelo(**lote).pérdida pérdida.hacia atrás()
        optimizador.paso()
    volvemos modelo

# Gradientes agregados
hospital1_modelo = entrenar_en_dispositivo(modelo global.copia(), datos del hospital1)
hospital2_modelo = entrenar_en_dispositivo(modelo global.copia(), datos del hospital2)

 con  sy.agregación(depurar=Cierto):
    modelo global = (hospital1_modelo + hospital2_modelo) / 2
Desafíos y Soluciones
| Desafío | Solución |
|---|---|
| Heterogeneidad de datos | Utilice optimización adaptativa (por ejemplo, FedProx). |
| Gastos generales de comunicación | Comprimir actualizaciones con cuantización. |
| Ataques a la privacidad | Añadir ruido de privacidad diferencial (ε=1.0). |
Estudio de caso: Ajuste fino federado para datos de salud portátiles
Objetivo: Predecir emergencias cardíacas sin compartir datos del paciente.
Nuevo enfoque:
Se implementó TinyBERT en 1,000 relojes inteligentes.
Ajustado localmente según datos de frecuencia cardíaca/actividad.
Actualizaciones agregadas semanalmente con privacidad diferencial de ε=0.5.
Resultados :
89% de precisión frente al 78% del entrenamiento centralizado (debido a una mayor personalización).
Cero violaciones de datos en una prueba de 12 meses.
Herramientas para el aprendizaje federado
| Caso de uso | |
|---|---|
| PySyft | Prototipos de investigación |
| TensorFlow federado | FL a escala de producción |
| Flor | FL entre dispositivos (IoT/borde) |
El futuro de los LLM federados
RLHF federado : Recopila comentarios humanos a través de diferentes dispositivos.
FL basado en blockchain : Registros de auditoría inmutables para el sector sanitario y financiero.
Conclusión
El perfeccionamiento de los modelos de lógica descriptiva (LLM) ya no es un lujo, sino una necesidad para las empresas y los investigadores que buscan aprovechar todo el potencial de la IA. Como hemos explorado en esta serie, el camino desde un modelo de propósito general hasta un experto en un dominio específico depende de prácticas estratégicas de datos.
Los datos como base : Los conjuntos de datos de alta calidad, diversos y obtenidos de forma ética son imprescindibles. Desde la generación de datos sintéticos hasta las auditorías de sesgo, cada paso debe priorizar la relevancia y la equidad.
La eficiencia se une a la innovación : métodos eficientes en parámetros como LoRA y el aprendizaje federado democratizan el acceso al ajuste fino, reduciendo los costos y el impacto ambiental.
El toque humano : Ya sea a través de la metodología RLHF o del aprendizaje activo, la experiencia humana sigue siendo insustituible para alinear los modelos con las necesidades del mundo real.
El camino a seguir
El futuro de los másteres en Derecho (LLM) reside en la especialización : modelos que comprendan no solo el idioma, sino también los matices de su sector. A medida que las herramientas evolucionan, mantenerse a la vanguardia requerirá:
Adopción de marcos emergentes como el ajuste fino en el dispositivo y las arquitecturas multimodales.
Integración de la ética en cada flujo de trabajo, desde la recopilación de datos hasta la implementación.
Colaborar entre disciplinas para resolver desafíos como la eficiencia energética y los ataques adversarios.