Introducción
Los LLM modernos ya no son curiosidades. Son infraestructura de primera línea. La búsqueda, la codificación, el soporte, el análisis y el trabajo creativo ahora se canalizan a través de modelos que leen, razonan y actúan a escala. Los ganadores no se definen solo por el número de parámetros. Ganan ejecutando un ciclo disciplinado: seleccionan mejores datos, eligen arquitecturas que se ajusten a las limitaciones, capacitan y alinean con cuidado, y luego miden lo que realmente importa en producción.
Esta guía adopta una perspectiva de sistemas. Empezamos con los datos, ya que la calidad y la cobertura marcan el límite. Examinamos arquitecturas (densas, de MoE e híbridas) desde la perspectiva de la latencia, el coste y la capacidad. Mapeamos los procesos de entrenamiento desde el preentrenamiento hasta el ajuste de instrucciones y la optimización de preferencias. Después, pasamos a la inferencia, donde el rendimiento, la cuantificación y la recuperación determinan la experiencia del usuario. Finalmente, tratamos la evaluación como una función operativa, no como un pasatiempo para clasificar.
La postura es práctica y progresista. Los ecosistemas abiertos superan a los silos cuando se respetan la privacidad y las licencias. La seguridad es un requisito del producto, no un comunicado de prensa. La eficiencia es la política climática con otro nombre. Y sí, se puede tener rigor sin disminuir la velocidad: los perfiladores y las tablas de ablación son más económicos que las interrupciones.
Si desarrolla productos LLM, este manual muestra los factores que impulsan los resultados: qué recopilar, qué entrenar, qué ofrecer y qué medir. Si actualiza una pila existente, encontrará patrones de integración para contexto extenso, uso de herramientas, RAG y evaluación en línea. Durante el proceso, mantenemos un tono claro y listas de verificación concisas. El objetivo es simple: crear modelos útiles, veraces y asequibles. Si hacemos una broma, es solo para mantener los gráficos activos.
Por qué triunfan los LLM: una visión de sistemas
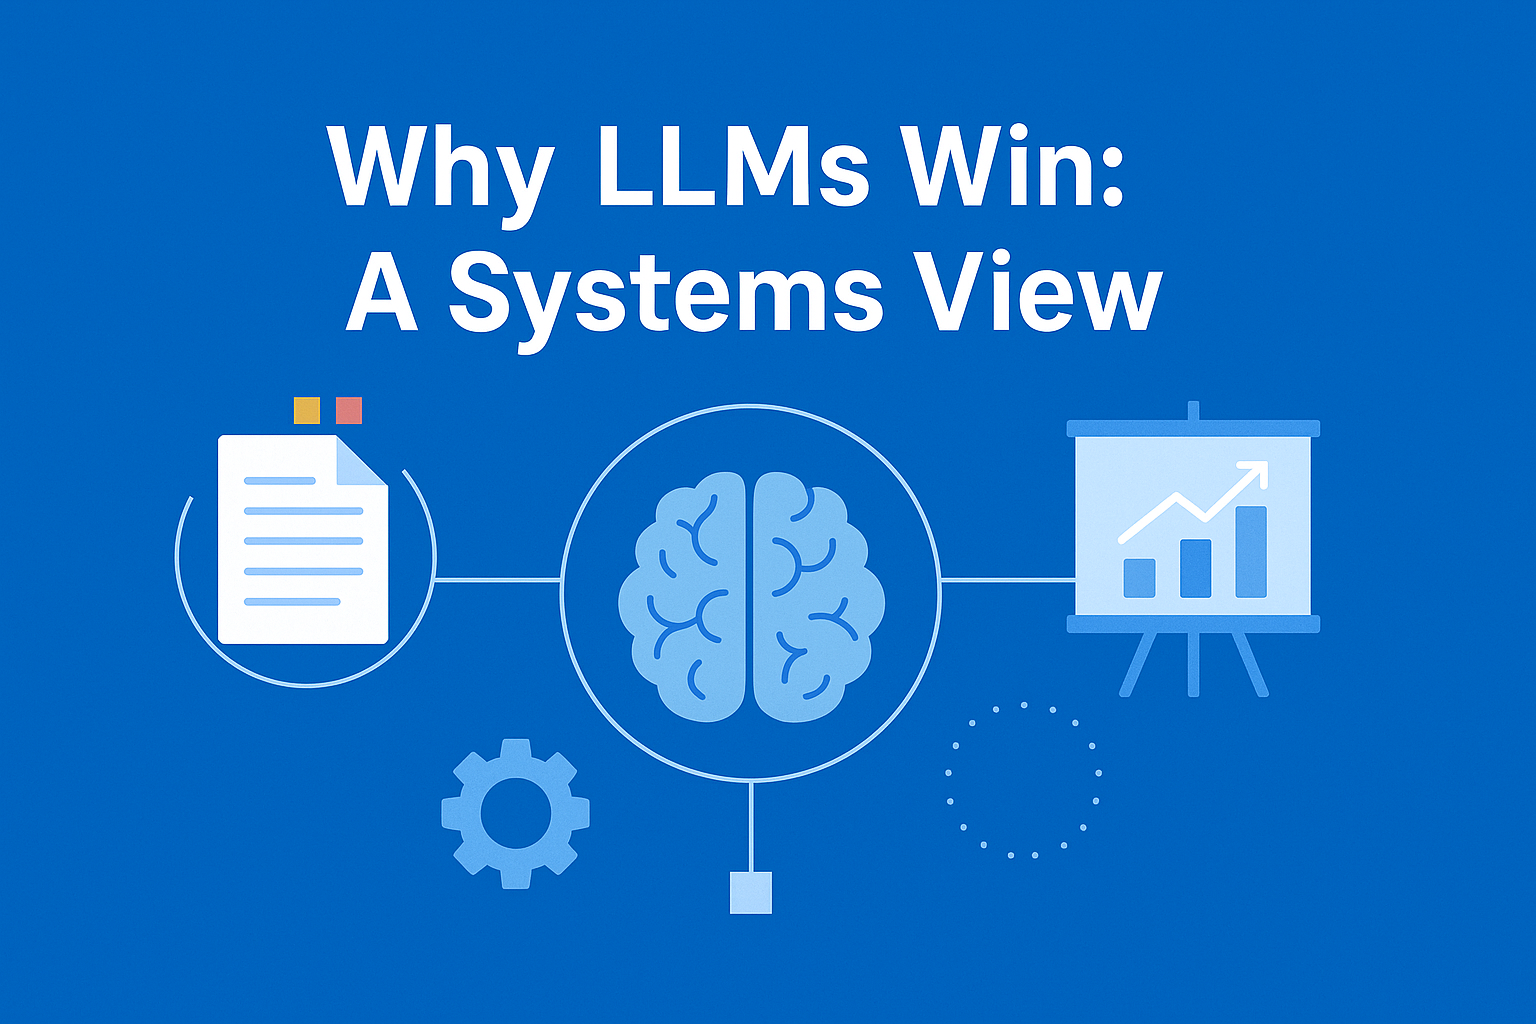
Los LLM funcionan porque tres volantes se refuerzan mutuamente:
La escala y la diversidad de los datos mejoran las suposiciones previas y la generalización.
La arquitectura transforma la computación en capacidad mediante sesgos inductivos eficientes y memoria.
Los sistemas de entrenamiento aprovechan el hardware a gran escala al tiempo que adaptan los modelos a las preferencias humanas.
Considere un LLM como un sistema integral. Las entradas son tokens y herramientas. Las palancas son la calidad de los datos, las opciones de arquitectura y los programas de entrenamiento. Las salidas son la precisión, la latencia, la seguridad y el costo. Los equipos modernos iteran todo el ciclo, no solo las ponderaciones del modelo.
Los datos en el núcleo
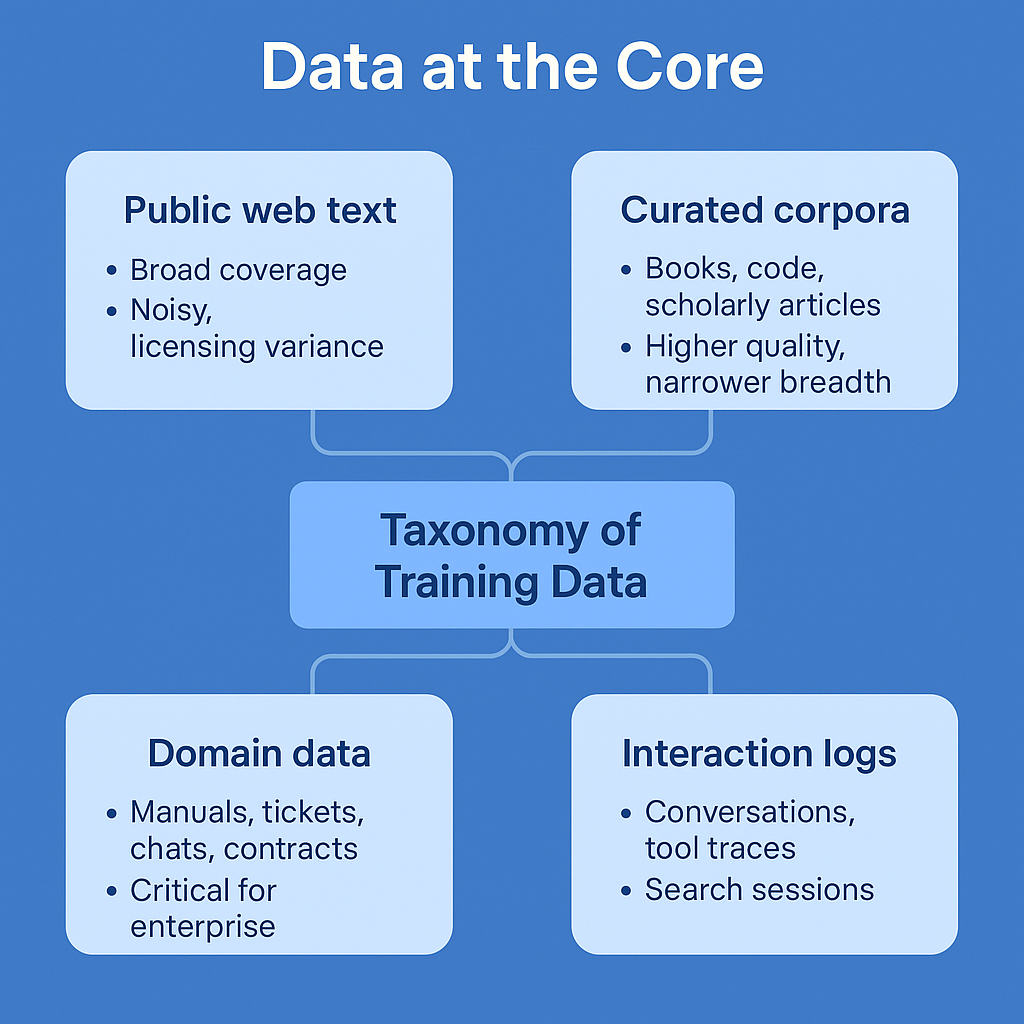
Taxonomía de datos de entrenamiento
Texto web público: amplia cobertura, ruidoso, variación en las licencias.
Corpus seleccionados: libros, código, artículos académicos. Mayor calidad, menor alcance.
Datos del dominio: manuales, tickets, chats, contratos, registros médicos electrónicos (EMR), informes financieros. Fundamentales para la empresa.
Registros de interacción: conversaciones, seguimiento de herramientas, sesiones de búsqueda. Muy útiles para después de la formación.
Datos sintéticos: autoaprendizaje, explicaciones autogeneradas, diversas paráfrasis. Un control para ajustar la cobertura.
Un modelo de base sólido utiliza datos de preentrenamiento amplios y diversos para aprender lenguaje general. La excelencia del dominio se alcanza posteriormente mediante un postentrenamiento y una recuperación específicos.
Calidad, diversidad y cobertura
Calidad : corrección, coherencia, exhaustividad.
Diversidad : géneros, dialectos, ámbitos, estilos.
Cobertura : temas, casos excepcionales, entidades poco comunes.
Utilice muestreo ponderado: aumente la frecuencia de muestreo de géneros escasos pero valiosos (soluciones matemáticas, código, textos procedimentales) y reduzca la frecuencia de muestreo de contenido repetitivo o spam de bajo valor. Mantenga taxonomías de temas y mida la representación. Aplique heurísticas basadas en la entropía y la perplejidad para aproximar la dificultad y la novedad.
Limpieza, deduplicación y control de la contaminación
Limpieza : eliminar el código repetitivo, normalizar Unicode, eliminar los rastreadores, corregir el marcado defectuoso.
Eliminación de duplicados : MinHash/LSH o similitud de incrustación con umbrales por dominio. Conservar una copia de alta calidad.
Contaminación : protéjase contra la fuga de datos entre pruebas y entrenamiento. Mantenga listas de bloqueo de elementos de evaluación, marcas de tiempo de rastreo y comprobaciones casi duplicadas. Registre la procedencia para responder a la pregunta "¿de dónde proviene un token?".
Estrategia de tokenización y vocabulario
Los sistemas modernos favorecen los tokenizadores BPE o Unigram a nivel de byte con cobertura multilingüe. Objetivos de diseño:
Escrituras raras y compactas sin aumento del tamaño del vocabulario.
Manejo estable de puntuación, números y código.
Baja inflación de tokens para texto de dominio (matemáticas, legal, código).
Evalúe el costo de tokenización por dominio. Un pequeño cambio en el tokenizador puede modificar los costos del contexto y la estabilidad del entrenamiento.
Datos estructurados y de contexto largo
Si esperas más de 128k tokens:
Entrenar con programas de secuencias largas y codificaciones posicionales adecuadas.
Incluir formatos de datos estructurados : JSON, XML, tablas, registros.
Enseñar el cumplimiento del formato mediante la generación con restricciones de esquema y ejemplos con pocos ejemplos.
Datos sintéticos y volantes de datos
Los datos sintéticos llenan lagunas:
Las explicaciones y los fundamentos aumentan la fidelidad en las tareas de razonamiento.
Los pares contrastantes mejoran los límites de rechazo y seguridad.
Los contrafactuales ponen a prueba el razonamiento y reducen el aprendizaje abreviado.
Construir un ciclo de datos : desplegar → recopilar interacciones de usuario y casos de fallos → aplicar correcciones con datos sintéticos → validar → volver a entrenar.
Privacidad, cumplimiento y licencias
Mantenga los metadatos de la licencia por muestra.
Aplicar un proceso de depuración de datos de identificación personal con detectores por capas y revisión humana para dominios de alto riesgo.
Brindar soporte a las solicitudes de los interesados mediante el seguimiento de la procedencia y los períodos de retención de datos.
Conjuntos de datos de evaluación: Construyendo un criterio confiable
Evaluaciones de diseño que reflejen tu realidad:
Capacidad estática : comprensión del lenguaje, razonamiento, programación, matemáticas, multilingüismo.
Específico del dominio : sus políticas, formatos, documentación del producto.
Transmisión en vivo en línea : tráfico en la sombra, avisos de alerta temprana, sondeos contrafactuales.
Gire las pruebas y evite el sobreajuste. Mantenga el equipo de prueba sellado.
Arquitecturas que escalan
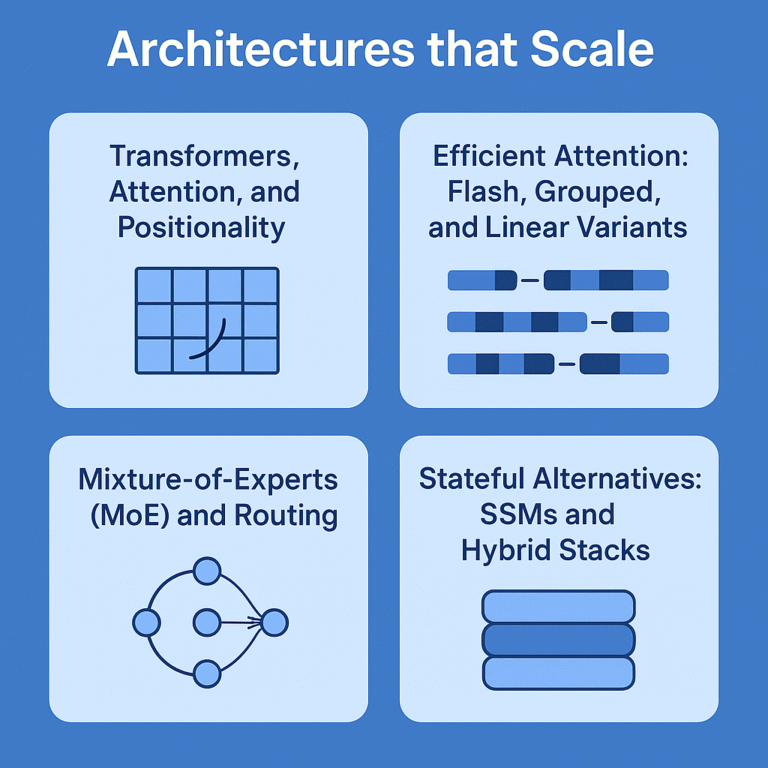
Transformadores, atención y posicionalidad
La línea base sigue siendo Transformers solo con decodificador y atención causal. Componentes clave:
Atención multi-cabeza para representación distribuida.
Redes neuronales de alimentación directa con variantes controladas (GEGLU/Swish-Gated) para la expresividad.
LayerNorm/RMSNorm para mayor estabilidad.
Codificaciones posicionales para inyectar orden.
Atención eficiente: variantes flash, agrupadas y lineales
FlashAttention : Núcleos conscientes de E/S, atención precisa con mejor localidad de memoria.
Atención a múltiples consultas o consultas agrupadas : menos nodos de clave/valor, decodificación más rápida con una mínima pérdida de calidad.
Mecanismos de atención lineal y técnicas de kernel: útiles para secuencias muy largas, pero a costa de la exactitud.
Ampliación del contexto: RoPE, ALiBi y trucos de extrapolación
RoPE (incrustaciones rotativas) : opción predeterminada fuerte para el preentrenamiento de contexto largo.
ALiBi : sesgo de atención que ajusta el contexto sin necesidad de reentrenar las tablas posicionales.
El escalado NTK/rope y la continuación al estilo YaRN pueden extender el contexto efectivo, pero siempre validan en evaluaciones de contexto largo.
Las cachés segmentadas y la atención por ventanas pueden reducir el coste cuadrático en la inferencia.
Mezcla de expertos (MoE) y enrutamiento
MoE aumenta el recuento de parámetros con un cómputo limitado por token:
El enrutamiento Top-k (k=1 o 2) activa un subconjunto de expertos.
El equilibrio de pérdidas evita el colapso de los expertos.
El paralelismo entre expertos es una nueva dimensión en la formación distribuida.
Beneficios: mayor capacidad con FLOPs similares. Costos: complejidad, riesgo de inestabilidad, dificultades de servicio.
Alternativas con estado: SSM y pilas híbridas
Los modelos de espacio de estados estructurados (SSM) y sus sucesores ofrecen modelado de secuencias en tiempo lineal. Los modelos híbridos combinan bloques SSM para la memoria con mecanismos de atención para una recuperación flexible. Casos de uso: secuencias muy largas, procesamiento en tiempo real.
Multimodalidad: Texto+Visión+Audio
Los asistentes modernos combinan modalidades:
Los codificadores de visión (similares a ViT/CLIP) proyectan imágenes en flujos de tokens.
Los codificadores/descodificadores de audio gestionan el reconocimiento automático de voz (ASR) y la síntesis de voz (TTS).
Estrategias de fusión : fusión temprana mediante adaptadores aprendidos o fusión tardía mediante llamadas a herramientas.
Uso de herramientas, llamada de funciones y agentes
Enseñe a los modelos a llamar a funciones con argumentos JSON. Proporcione las especificaciones de la herramienta durante el entrenamiento y el ajuste de las instrucciones. Para los agentes:
Ciclo de planificación y resolución con autocrítica.
Recuperación y memoria estructurada para la conexión con la tierra.
Ejecución de la herramienta de envoltura de reguladores de seguridad.
Entrenamiento a escala
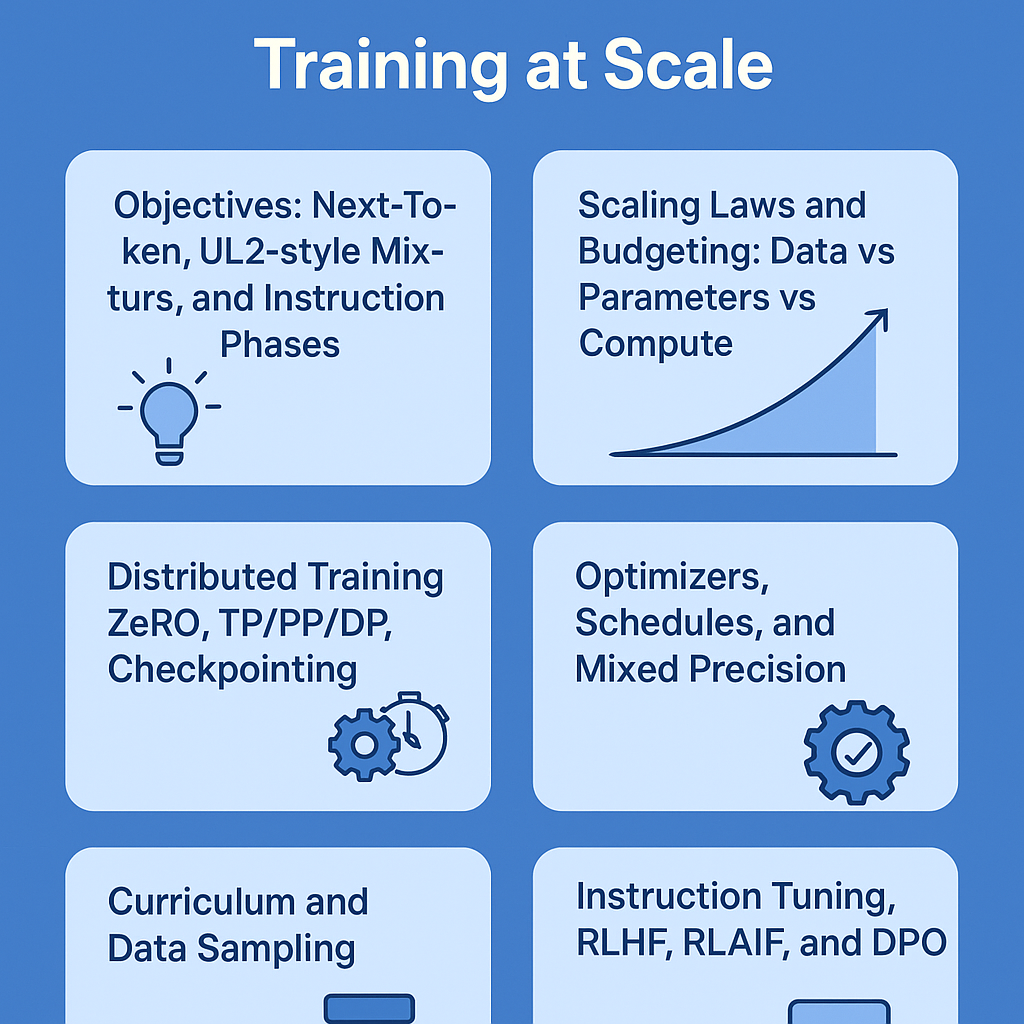
Objetivos: Next-Token, mezclas estilo UL2 y fases de instrucción
Preentrenamiento : predicción del siguiente token con segmentos enmascarados intercalados para mayor robustez.
SFT (Ajuste Fino Supervisado) : instrucción que sigue a partir de ejemplos de alta calidad.
Optimización de preferencias : RLHF, RLAIF o DPO para alinear los resultados con las preferencias humanas sin que se produzca un colapso de las políticas.
Leyes de escala y presupuesto: datos vs. parámetros vs. cómputo
Siga las recetas óptimas de cálculo:
Parámetros de equilibrio y tokens.
Si no puedes aumentar la capacidad de cómputo, gástala en más tokens antes de añadir parámetros.
Establezca como objetivo entre 10 y 20 tokens o más por parámetro como punto de partida aproximado para la planificación de modelos LLM de propósito general. Valide con proyectos piloto.
Entrenamiento distribuido: ZeRO, TP/PP/DP, puntos de control
Paralelismo de datos (DP) para mejorar el rendimiento.
Tensor Parallel (TP) divide las matrices entre diferentes dispositivos.
Capas de particiones de Pipeline Parallel (PP).
Las etapas de ZeRO gestionan los estados y gradientes del optimizador de fragmentos.
El sistema de puntos de control de activación intercambia capacidad de procesamiento por memoria.
Utilice el entrenamiento con particionamiento completo para modelos muy grandes. Compruebe si hay interbloqueos o corrupción del estado del optimizador desde el principio.
Optimizadores, programaciones y precisión mixta
La descomposición de peso AdamW/desacoplada sigue siendo el estándar.
Adafactor reduce el consumo de memoria.
Utilice la descomposición coseno con calentamiento.
Entrena con BF16 o FP16 autocast. Mantén los pesos maestros de FP32.
El recorte de degradado protege contra actualizaciones explosivas.
Currículo y muestreo de datos
Comience con secuencias más fáciles y cortas.
Avanzar hacia contextos más largos y dominios más difíciles.
El muestreo basado en la temperatura sobre distribuciones de fuentes evita el sobreajuste a dominios frecuentes.
Ajuste de instrucciones, RLHF, RLAIF y DPO
SFT establece el seguimiento de instrucciones.
RLHF : entrenar un modelo de recompensa basado en las preferencias humanas y luego optimizar una política con PPO o variantes.
RLAIF : reemplazar o complementar las etiquetas humanas con retroalimentación asistida por modelos.
DPO : optimización directa de políticas sin un modelo de recompensa explícito, utilizando pares elegidos frente a pares rechazados. Proceso más sencillo, resultados sólidos.
Mantener conjuntos de datos de preferencias de seguridad para codificar los límites de rechazo, el tono y la inocuidad.
Seguridad, equipos rojos y barandillas
Preentrenamiento con filtros que tienen en cuenta la toxicidad y ejemplos de políticas.
Después del entrenamiento, con datos de preferencias específicas de seguridad.
Equipo rojo que utiliza taxonomías de jailbreak y avisos adversarios que reconocen herramientas.
Protege los modelos con medidas de seguridad : clasificadores de contenido, listas de herramientas permitidas y limitación de velocidad.
Inferencia y despliegue
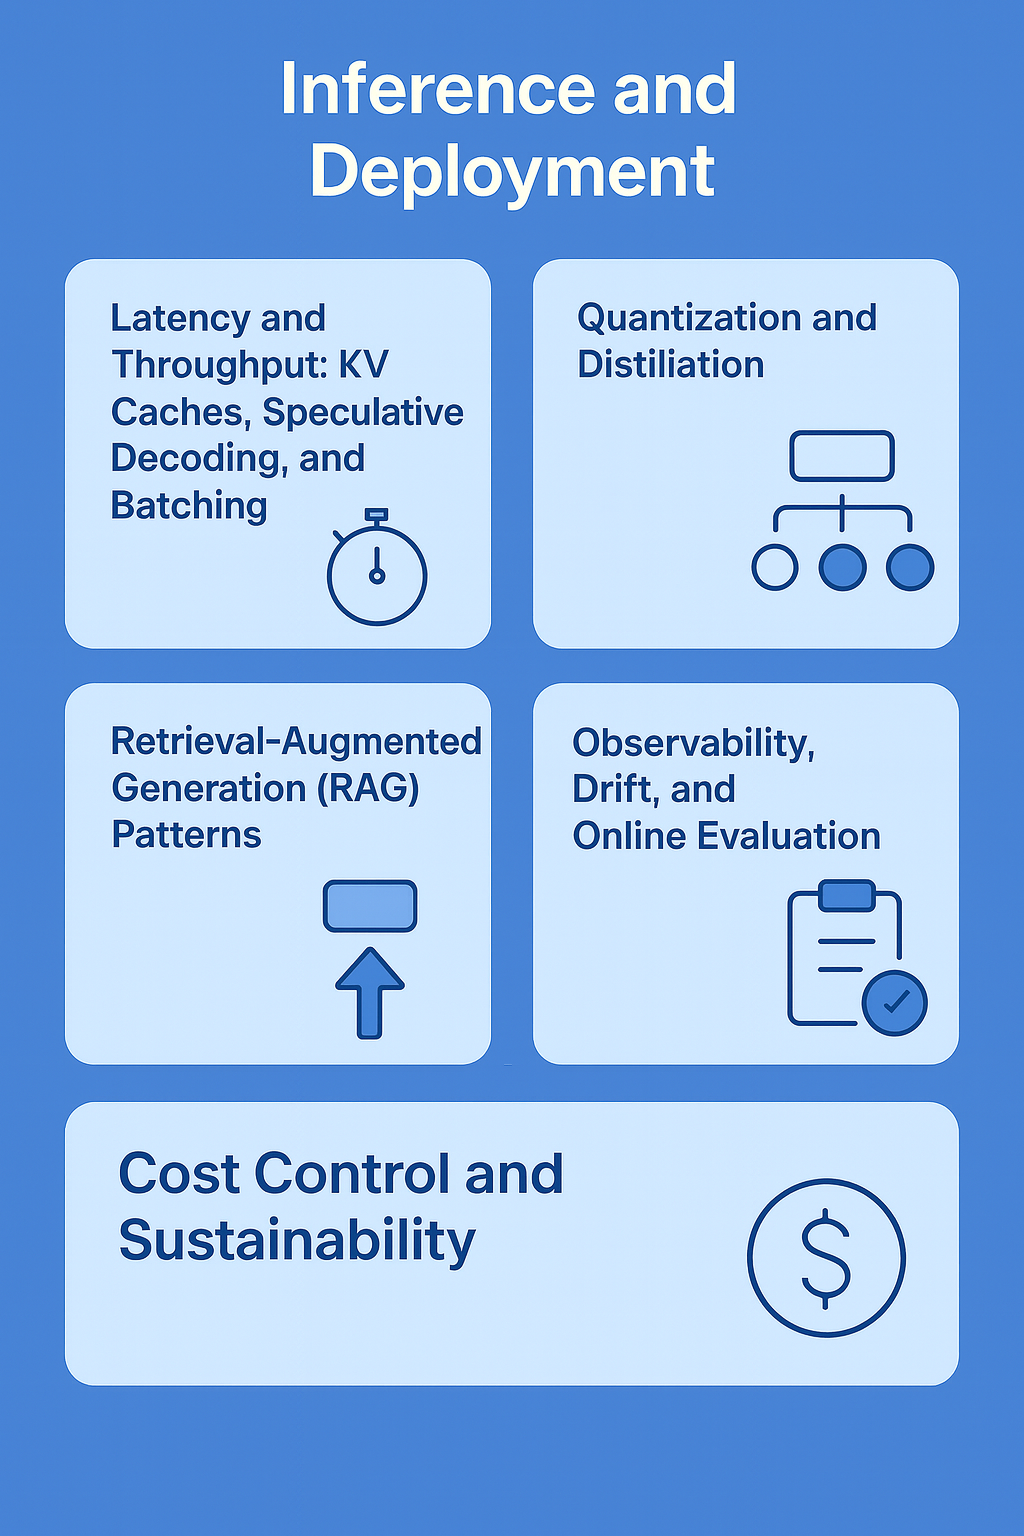
Latencia y rendimiento: cachés KV, decodificación especulativa y procesamiento por lotes
La reutilización de la caché KV acelera la transmisión. Fije la caché en la GPU para sesiones de alta demanda.
Decodificación especulativa : un modelo pequeño preliminar propone tokens, un modelo grande los verifica. Reduce la latencia con una calidad similar.
Procesamiento por lotes : el procesamiento por lotes dinámico y continuo maximiza la utilización de la GPU.
La atención paginada y los núcleos de decodificación tensorializados estabilizan el rendimiento en contextos largos.
Cuantización y destilación
Cuantización posterior al entrenamiento : INT8/INT4 con manejo de valores atípicos (por ejemplo, AWQ) para obtener grandes aumentos en el rendimiento.
QAT mejora la calidad con pocos bits cuando se puede volver a entrenar.
Destilación : entrenar a un estudiante más pequeño en los resultados y fundamentos del profesor. Conservar registros del uso de las herramientas para que los estudiantes hereden las habilidades.
Patrones de recuperación-generación aumentada (RAG)
Diseño del índice : búsqueda híbrida densa+léxica.
Segmentación : tamaño según límites semánticos; superposición para garantizar la continuidad.
Citas : pedir al modelo que base las respuestas en los intervalos recuperados.
RAG iterativo : recuperar → generar preguntas → recuperar de nuevo para cubrir las lagunas.
Actualización : índices activos para actualizaciones diarias; almacenamiento en frío para archivos.
Observabilidad, deriva y evaluación en línea
Seguimiento de la latencia P50/P95 , tokens/s , longitud del contexto , tasas de aciertos de caché.
Supervisar la seguridad del contenido , los sustitutos de alucinaciones y la cobertura de conexión a tierra.
Realiza pruebas A/B en tráfico de respaldo.
Alerta sobre desviación del dominio y fallo de la herramienta.
Control de Costos y Sostenibilidad
Para muchas cargas de trabajo, se recomiendan modelos más pequeños con RAG .
Utilice el servicio cuantizado y el uso compartido de GPU.
Programe lotes fuera de las horas pico para trabajos de baja prioridad.
Perfil para eliminar cuellos de botella ocultos (tokenización de CPU, sobrecarga del serializador, transferencias PCIe).
Evaluación que importa
Puntos de referencia de capacidad
Lenguaje básico : comprensión, resumen, traducción.
Razonamiento : matemáticas, lógica, generación/depuración de código.
Contexto extenso : recuperación y fidelidad en un rango de 32 a 256 tokens.
Multilingüe : equilibrado entre las principales familias y sistemas de escritura.
Multimodal : tareas tipo OCR, gráficos, capturas de pantalla de la interfaz de usuario, diagramas.
Pruebas de robustez, seguridad y protección
Mensajes de advertencia y conjuntos de herramientas para jailbreak.
Verificación de fundamentos : compare las citas con las afirmaciones.
Seguridad de la herramienta : simular salidas de herramientas maliciosas.
Privacidad : sondeos de memorización para cadenas sensibles.
Métricas alineadas con el negocio
Éxito en las tareas y rendimiento en el primer intento para sus flujos de trabajo.
Tiempo de resolución y tasa de deflexión en el soporte.
Precisión y fidelidad para RAG.
Tiempo humano ahorrado para los copilotos internos.
Planos de casos
Construyendo un LLM de dominio
Objetivo: un asistente que domine sus políticas, formularios y procedimientos operativos estándar (SOP).
Pasos:
Gestionar el corpus del dominio. Agregar manuales, procedimientos operativos estándar (POE), tickets, correos electrónicos y esquemas.
Auditoría de tokenización: garantizar una baja inflación de la jerga del dominio.
Selección del modelo base: comience con un modelo robusto 7B–13B o 70B según el presupuesto de latencia.
RAG primero: construir una recuperación híbrida y gobernanza de documentos.
SFT: enseñar formatos, referencias y límites de rechazo.
Alineación de preferencias: DPO en escenarios realistas.
Seguridad: agregue rechazos específicos del dominio y filtros PII.
Evaluar: métricas a nivel de tarea y canarios vivos.
Iterar a través del volante de datos.
Errores comunes: sobreajuste a conjuntos pequeños de SFT, dependencia de la memoria del modelo en lugar de la recuperación, descuido de la fidelidad de las citas.
Asistente de control de calidad de contexto largo
Objetivo: gestionar más de 128 tokens de especificaciones e hilos.
Movimientos clave:
Entrena o perfecciona con secuencias largas y escalado RoPE/ALiBi .
Utilice atención paginada y particionamiento de caché para el servicio.
Indexar documentos de todos modos. Un contexto extenso no reemplaza la recuperación.
Evaluar la búsqueda de información valiosa y la fundamentación en la documentación cruzada.
Atención al cliente multimodal
Objetivo: interpretar capturas de pantalla, registros y texto.
Diseño:
Codificador de visión que alimenta los adaptadores de tokens al LLM.
Herramientas para la recuperación de tickets , búsqueda en la base de conocimientos y creación de RMA.
SFT en captura de pantalla + texto → diálogos de acción estructurada.
Seguridad: protección contra filtraciones de contenido confidencial de capturas de pantalla.
El camino a seguir
Memoria a largo plazo : modelos híbridos que persisten entre sesiones con resúmenes concisos.
Ecosistemas de herramientas más inteligentes : modelos que planifican, verifican y se recuperan de los fallos de las herramientas.
Entrenamiento con conciencia energética : núcleos más ecológicos, mejor utilización y precisión adaptativa.
Veracidad : mayor acoplamiento entre la generación, la recuperación y la verificación.
Personalización en el marco de la privacidad : ajuste fino federado, adaptadores en el dispositivo, aumento sintético.
Listas de verificación y manuales de estrategias
Lista de verificación de curación de datos
Mapa de diversidad de fuentes con objetivos de cobertura
Registros de limpieza, deduplicación y contaminación
Auditoría de tokenización por dominio
Información de identificación personal (PII) y metadatos de licencia adjuntos por muestra
Plan de datos sintéticos con bucle de evaluación
Conjuntos de evaluación bloqueados y monitoreados para detectar fugas
Lista de verificación de arquitectura
Atención: la elección del kernel está validada en el hardware de destino
Estrategia posicional alineada con los objetivos del contexto
MoE o compensación densa decidida con el plan de servicio
Adaptadores multimodales, si es necesario
Especificación de la API de llamada de función y entorno aislado de herramientas
Lista de verificación de capacitación
Calentamiento y programación seleccionados con planes de lote/secuencia
Precisión mixta, recorte de gradiente y puntos de control
Planes ZeRO/TP/PP probados a pequeña escala
Conjuntos de datos SFT con ejemplos de adherencia al esquema
Preferencias de DPO/RLHF, incluidas la seguridad y los rechazos
Lista de verificación de inferencia
Caché KV y procesamiento por lotes verificados bajo carga
Cuantización A/B vs. precisión total
Configuraciones de decodificación especulativa ajustadas
Puesta a tierra de RAG con puntuación de citación
Paneles de observación y alertas
Lista de verificación de evaluación
Conjunto de capacidades para sus tareas objetivo
Sondas de seguridad y fuga de la cárcel
Métricas empresariales integradas en CI/CD
Detección de derivas y cuadros de mando semanales
Ejemplo de proceso de liberación
Congelación de datos con auditoría de contaminación.
Ensayo de entrenamiento a escala del 5% para validar la memoria, los gradientes y las curvas de pérdida.
Recorrido completo con puntos de control periódicos.
SFT con tareas estructuradas.
DPO utiliza pares seleccionados que abarcan la utilidad y la seguridad.
Evaluación fuera de línea de las capacidades y los conjuntos de seguridad.
Implementación Canary para usuarios de bajo riesgo con registro de actividad en segundo plano.
Desplazamiento A/B con barandillas de seguridad.
Actualización del ciclo de datos y plan para el próximo ciclo.
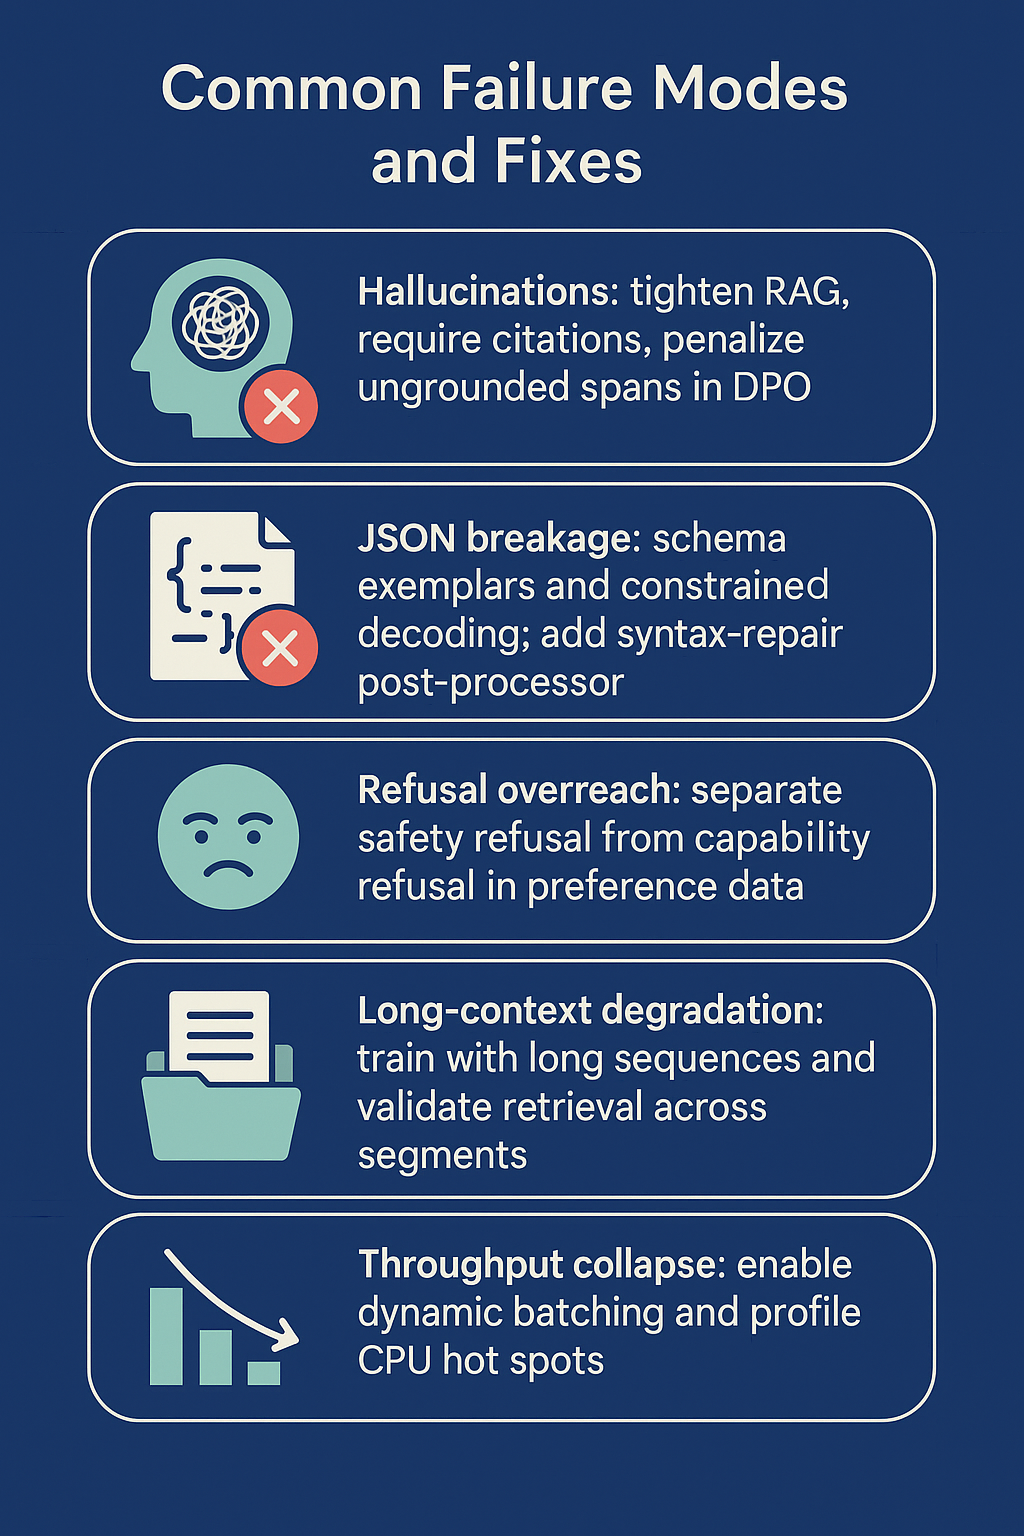
Modos de fallo comunes y soluciones
Alucinaciones : endurecer la RAG, exigir citas, penalizar los tramos sin fundamento en DPO.
Fallo en JSON : ejemplos de esquema y decodificación restringida; agregar un postprocesador de reparación de sintaxis.
Exceso de ambigüedad en el rechazo : separe el rechazo por motivos de seguridad del rechazo por motivos de capacidad en los datos de preferencias.
Degradación de contexto largo : entrenar con secuencias largas y validar la recuperación a través de segmentos.
Colapso del rendimiento : habilite el procesamiento por lotes dinámico y el análisis de los puntos críticos de la CPU.
Conclusión
Los modelos de aprendizaje basados en la lógica ( LLM) modernos triunfan gracias a una gestión de datos rigurosa, una arquitectura pragmática y una formación sólida . Los mejores equipos siguen un ciclo: implementar, observar, recopilar, sintetizar, alinear y reimplementar. La recuperación de datos fundamenta la verdad. La optimización de preferencias moldea el comportamiento. La cuantificación y el procesamiento por lotes permiten la escalabilidad. Sobre todo, la evaluación debe ser continua y estar alineada con los objetivos del negocio.
Utilice las listas de verificación para poner en práctica el proceso. Empiece poco a poco, instrumente todo y repita el proceso.