
Introducción
Antes de YOLO, las computadoras no veían el mundo como los humanos. Lo inspeccionaban lentamente, con cautela, analizando cada objeto individualmente. La detección de objetos funcionaba, pero era fragmentada, computacionalmente costosa y distaba mucho de ser en tiempo real.
Luego, en 2015, un solo artículo lo cambió todo.
El artículo “You Only Look Once: Unified, Real-Time Object Detection”, de Joseph Redmon y otros autores, presentó YOLOv1 , un modelo que redefinió la forma en que las máquinas perciben las imágenes. No se trató solo de una mejora gradual, sino de una revolución conceptual.
Esta es la historia de cómo nació YOLOv1, cómo funcionó y por qué su impacto aún resuena en los sistemas de visión artificial modernos de la actualidad.
Detección de objetos antes de YOLO: un mundo fragmentado
Antes de YOLOv1, la investigación en detección de objetos estaba dominada por complejos sistemas ensamblados a partir de múltiples componentes independientes . Cada componente funcionaba razonablemente bien por sí solo, pero el sistema en su conjunto era frágil, lento y difícil de optimizar.
La tubería de detección clásica
Un sistema típico de detección de objetos antes de 2015 se veía así:
Propuesta de región elaborada a mano o basada en heurística
Búsqueda selectiva
Cajas de borde
Ventanas corredizas (métodos anteriores)
Extracción de características
Características de CNN (AlexNet, VGG, etc.)
Ejecutar por separado en cada región propuesta.
Clasificación
Clasificadores SVM o softmax
Un clasificador por región
Regresión del cuadro delimitador
Ajuste fino de las coordenadas del cuadro después de la clasificación
Cada etapa se entrenó de forma independiente , a menudo con objetivos diferentes.
¿Por qué esto fue un problema?
Cálculo redundante
Las mismas características de la imagen fueron recalculadas cientos de veces.Sin contexto global
La modelo nunca “vio” realmente la imagen completa de una vez.Fragilidad de los oleoductos
Los errores en las propuestas regionales nunca podrían recuperarse posteriormente.Bajo rendimiento en tiempo real
Incluso Fast R-CNN tuvo dificultades para superar algunos FPS.
La detección de objetos funcionó, pero parecía una solución alternativa y no una solución limpia.
La filosofía YOLO: la detección como un problema de aprendizaje único
YOLOv1 desafió la suposición dominante de que la detección de objetos debe ser un problema de varias etapas.
Más bien, planteó una pregunta radical:
¿Por qué no predecir todo a la vez , directamente a partir de los píxeles?
Un cambio conceptual
YOLO reformuló la detección de objetos como:
Un único problema de regresión desde píxeles de imagen hasta cuadros delimitadores y probabilidades de clase.
Esto significaba:
No hay propuestas de regiones
Sin ventanas corredizas
No hay clasificadores separados
Sin costuras post-hoc
Sólo una red neuronal, entrenada de extremo a extremo.
¿Por qué este Matters
Este cambio:
Simplificó el objetivo de aprendizaje
Menor complejidad de ingeniería
Permitió que los gradientes fluyeran a lo largo de toda la tarea de detección.
Se habilitó la inferencia real en tiempo real
YOLO no solo optimizó la detección, sino que redefinió lo que era la detección.
Cómo funciona YOLOv1: una nueva gramática visual
YOLOv1 introdujo una forma estructurada para que las redes neuronales “describan” una imagen.
Asignación de responsabilidades basada en la red
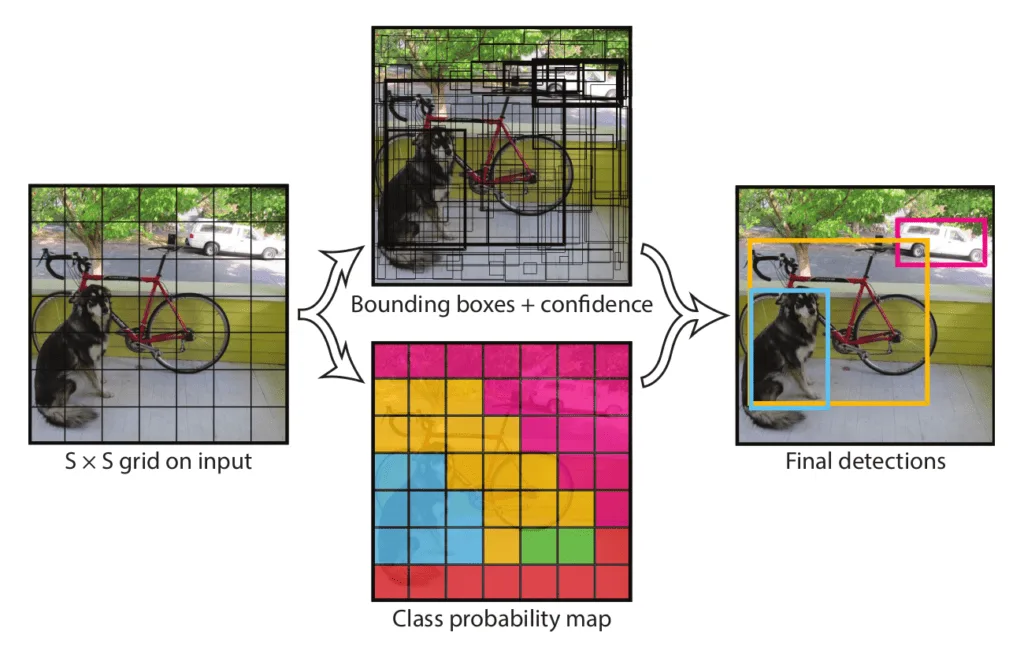
La imagen está dividida en una cuadrícula de S × S (normalmente de 7 × 7).
Cada celda de la cuadrícula:
Es responsable de los objetos cuyo centro se encuentra dentro de él.
Predice cuadros delimitadores y probabilidades de clase
Esto creó un conocimiento previo espacial que ayudó a la red a razonar sobre dónde tienden a aparecer los objetos.
Detalles de la predicción del cuadro delimitador
Cada celda de la cuadrícula predice B cuadros delimitadores , donde cada cuadro consta de:
x, y → coordenadas del centro (relativas a la celda de la cuadrícula)
w, h → ancho y alto (relativos a la imagen)
puntuación de confianza
La puntuación de confianza codifica:
Pr(object) × IoU(predicted box, ground truth)
Esto fue ingenioso, ya que obligó a la red a razonar conjuntamente sobre la naturaleza del objeto y la calidad de la localización.
Estrategia de predicción de clases
En lugar de predecir clases por cuadro delimitador, YOLOv1 predijo:
Un conjunto de probabilidades de clase por celda de la cuadrícula
Esto redujo la complejidad pero introdujo limitaciones en escenas concurridas, una compensación que YOLOv1 aceptó conscientemente.
Arquitectura YOLOv1: diseñada para el razonamiento global
La arquitectura de red de YOLOv1 fue diseñada intencionalmente para capturar el contexto global de la imagen.
Desglose de la arquitectura
24 capas convolucionales
2 capas completamente conectadas
Inspirado en GoogLeNet (pero más simple)
Preentrenado en la clasificación ImageNet
Las capas finales completamente conectadas permitieron a YOLO:
Combinar características espacialmente distantes
Comprender las relaciones entre objetos
Evite los falsos positivos causados por patrones de textura locales
Por qué es importante el contexto global
Los detectores tradicionales a menudo confundían:
Sombras para objetos
Texturas para regiones significativas
El razonamiento global de YOLO redujo estos errores al comprender la escena en su conjunto.
La función de pérdida YOLOv1: Equilibrio entre objetivos en pugna
El entrenamiento de YOLOv1 requirió resolver un delicado problema de optimización.
Componentes de pérdida de varias partes
Función de pérdida de YOLOv1 combinada:
Pérdida de localización
Errores en x, y, w, h
Muy ponderado para priorizar casillas precisas
Pérdida de confianza
Predicciones de objetividad incorrectas penalizadas
Pérdida de clasificación
Predicciones de clase erróneas penalizadas
Decisiones de diseño inteligentes
Mayor peso para la regresión del cuadro delimitador
Menor peso para mayor confianza en el fondo
Raíz cuadrada aplicada al ancho y la altura para estabilizar gradientes
Estas decisiones de diseño influyeron directamente en cómo se calcularon las pérdidas de detección futuras.
Velocidad vs. Precisión: Un equilibrio de diseño consciente
YOLOv1 fue explícito sobre sus prioridades.
La posición de YOLO
Una localización ligeramente peor es aceptable si permite una visión en tiempo real.
Impacto en el rendimiento
YOLOv1 funcionó un orden de magnitud más rápido que los detectores de la competencia.
Implementación habilitada en:
Transmisiones de cámara en vivo
Sistemas robóticos
Dispositivos integrados (con Fast YOLO)
Esta disyuntiva transformó la forma en que los investigadores evaluaban los sistemas de detección, no solo por su precisión, sino también por su facilidad de uso.
Dónde falló YOLOv1 y por qué es importante
Las limitaciones de YOLOv1 no fueron accidentales: revelaron conocimientos profundos.
Pequeños objetos
Granularidad de detección limitada por resolución de cuadrícula
Los objetos pequeños a menudo desaparecían dentro de las celdas de la cuadrícula.
Escenas concurridas
Una predicción de clase de objeto por celda
Los objetos superpuestos confundieron el modelo
Precisión de localización
Predicciones de cuadro delimitador grueso
Puntuaciones de IoU más bajas que las de los métodos basados en regiones
Cada debilidad se convirtió en una pregunta de investigación que impulsó YOLOv2, YOLOv3 y versiones posteriores.
Por qué YOLOv1 cambió la visión artificial para siempre
YOLOv1 no sólo introdujo un modelo, introdujo una mentalidad.
El aprendizaje de extremo a extremo como principio
Los sistemas de detección se convirtieron en:
unificada
diferenciable
Más fácil de implementar y optimizar
El tiempo real como métrica de primera clase
Después de YOLO:
La velocidad ya no era opcional
La inferencia en tiempo real se convirtió en una expectativa
Un plan para los detectores del futuro
Las arquitecturas modernas, tanto las basadas en CNN como las basadas en transformadores, heredan las ideas centrales de YOLO:
Predicción densa
Inferencia de una sola pasada
Diseño consciente de la implementación
Reflexión final: El día que la detección se convirtió en visión
YOLOv1 marcó el momento en que la detección de objetos dejó de ser un conjunto de trucos y se convirtió en un sistema de visión coherente.
Enseñó al campo que:
Ver rápido desbloquea nuevas realidades
La simplicidad escala
El aprendizaje de extremo a extremo cambia la forma en que las máquinas entienden el mundo
YOLO no sólo miró una vez.
Hizo que la visión artificial viera las cosas de forma diferente para siempre.
El dolor de ipsum de Lorem se sienta amet, consectetur adipiscing elit. Ut elit tellus, luctus null ullamcorper mattis, pulvinar dapibus leo.