Introducción
La visión artificial en tiempo real está evolucionando rápidamente. Desde vehículos autónomos y drones hasta robótica, inspección industrial, cámaras inteligentes e imágenes médicas, los sistemas de IA necesitan cada vez más comprender la información visual con alta precisión y una latencia extremadamente baja.
La familia YOLO ha desempeñado un papel fundamental en esta evolución. Tras años de mejoras en velocidad, precisión y despliegue, Ultralytics está preparando su familia de modelos de próxima generación: YOLO27.
YOLO27 está diseñado para continuar con la filosofía de YOLO de visión artificial rápida y práctica, a la vez que introduce nuevas ideas arquitectónicas. La próxima familia combina una arquitectura CNN optimizada para sus modelos más pequeños con una arquitectura de detección basada en consultas y sin NMS para sus modelos más grandes.
Según la documentación oficial de Ultralytics, YOLO27 se encuentra actualmente en la fase final de investigación y desarrollo. Se prevé que los modelos se lancen a finales de 2026, pero aún no se ha anunciado una fecha de lanzamiento oficial . Los pesos, las configuraciones y el código de implementación no están disponibles públicamente, y las características actuales y los resultados de las pruebas de rendimiento podrían cambiar antes del lanzamiento.
Para los desarrolladores interesados en la evolución de YOLO, nuestro artículo sobre YOLO26: La próxima evolución de la visión artificial en tiempo real proporciona información útil sobre la generación anterior y el movimiento de la industria hacia modelos de visión integrales y listos para su implementación.
¿Qué es Ultralytics YOLO27?
Ultralytics YOLO27 es una próxima familia de modelos de visión artificial en tiempo real diseñados para una amplia gama de tareas de visión.
La familia incluye cuatro tamaños de modelo previstos:
- YOLO27n – Nano
- YOLO27s - Pequeño
- YOLO27m - medio
- YOLO27l - Grande
Los modelos están diseñados para admitir:
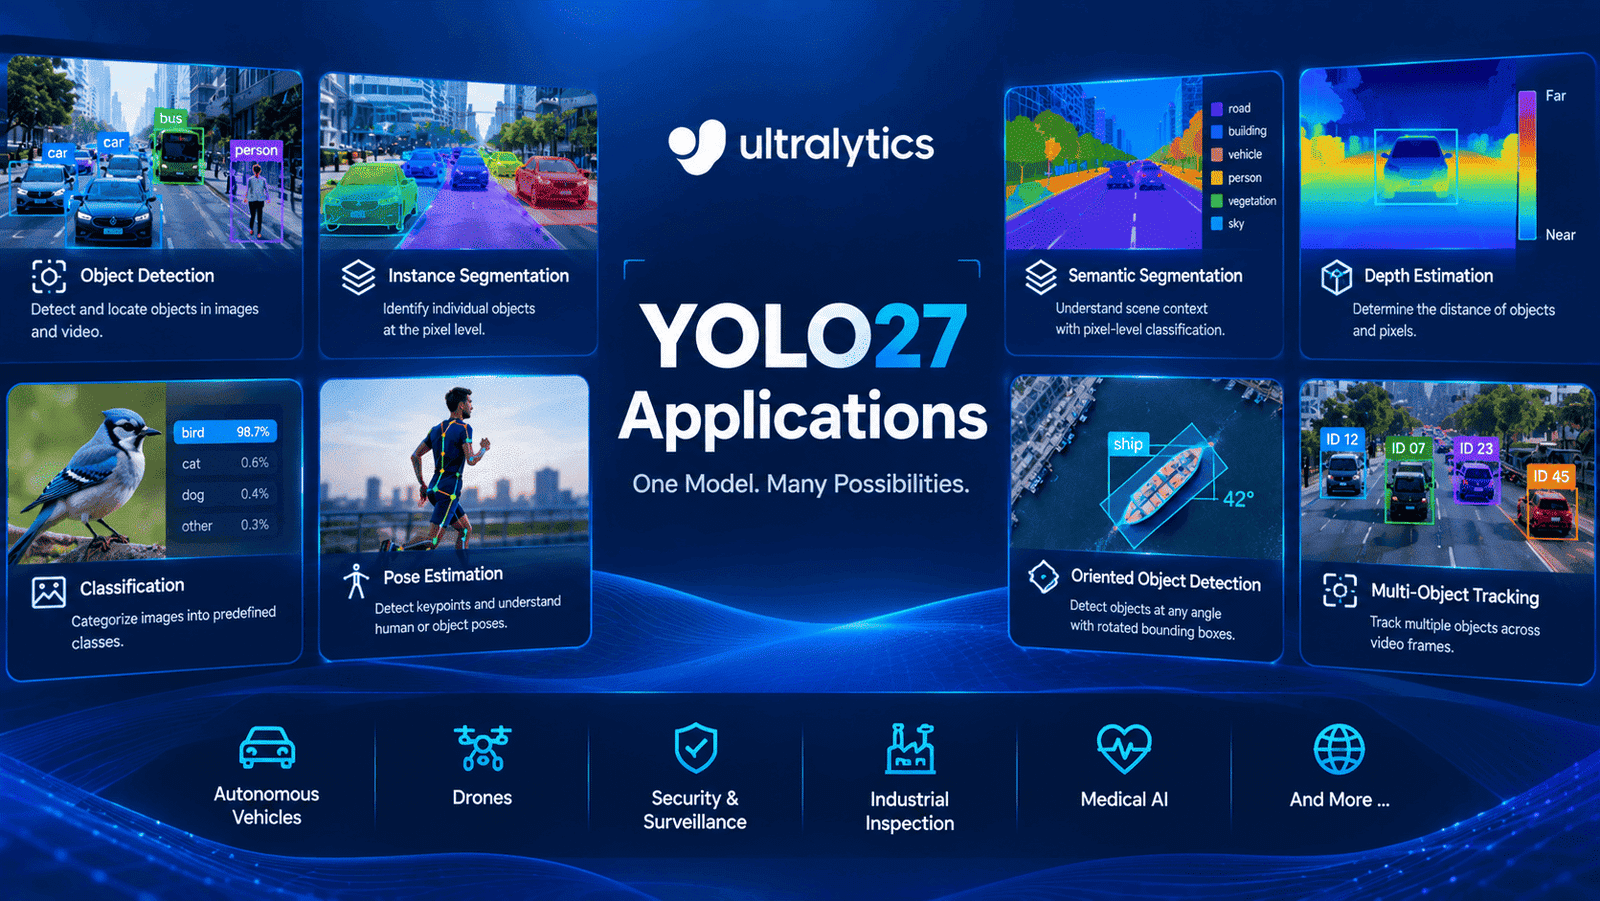
- Detección de objetos
- Segmentación de instancias
- Segmentación semántica
- Estimación de profundidad
- Clasificación de la imagen
- Estimación de poses
- Detección de objetos orientados
- Seguimiento de múltiples objetos para modelos compatibles
Uno de los aspectos más interesantes de YOLO27 es que sus modelos de detección utilizan dos enfoques arquitectónicos diferentes.
YOLO27n y YOLO27s utilizan un diseño simplificado basado en CNN optimizado para una inferencia eficiente, mientras que YOLO27m y YOLO27l utilizan una arquitectura basada en consultas que puede generar detecciones sin la supresión no máxima (NMS) tradicional.
Esto convierte al YOLO27 en algo más que una simple actualización de tamaño del modelo; es más bien una evolución arquitectónica de la familia YOLO.
YOLO27 y la evolución de los modelos YOLO
La arquitectura YOLO ha evolucionado significativamente desde su introducción.
Las generaciones anteriores se centraron principalmente en lograr una detección de objetos más rápida y precisa. Los modelos posteriores introdujeron mejoras en la extracción de características, el entrenamiento, la eficiencia del modelo y la implementación.
Los desarrolladores que quieran comprender la evolución práctica de YOLO también pueden consultar nuestra guía sobre cómo usar YOLOv11 para la detección de objetos.
YOLO27 continúa esta progresión abordando varios desafíos que siguen siendo importantes en la visión artificial moderna:
- Detección de objetos pequeños
- latencia de inferencia
- Sobrecarga del posprocesamiento
- Complejidad de implementación
- Precisión frente al tamaño del modelo
- Inferencia de borde eficiente
El resultado es una familia de modelos diseñada en función de diferentes requisitos de implementación, en lugar de una única arquitectura optimizada para cada situación.
YOLO27 contra YOLO26
YOLO27 se posiciona como el sucesor de YOLO26.
Sin embargo, la diferencia clave no radica simplemente en que YOLO27 sea más grande o más preciso.
La nueva generación introduce diferentes estrategias arquitectónicas para diferentes tamaños de modelos.
YOLO27n y YOLO27s
Los modelos más pequeños se centran en:
- Arquitectura CNN eficiente
- Detección de doble escala
- Detección de objetos pequeños
- Menor capacidad de cálculo del cabezal de detección
- Implementación de borde
- vídeo en tiempo real
YOLO27m y YOLO27l
Los modelos más grandes se centran en:
- Detección basada en consultas
- Decodificación de transformador
- inferencia sin NMS
- Alta precisión
- Implementación de GPU
- Contexto visual global
La documentación oficial recomienda actualmente seguir utilizando YOLO26 para proyectos de producción hasta que se publique YOLO27.
Para obtener una visión detallada de la generación anterior, consulte nuestra guía completa de YOLO26: La próxima evolución de la visión artificial en tiempo real.
Las dos arquitecturas de detección de YOLO27
Una de las mayores innovaciones de YOLO27 es que los cuatro modelos de detección no utilizan la misma arquitectura de detección.
Ultralytics los ha dividido en dos grupos.
YOLO27n y YOLO27s: Arquitectura CNN optimizada
Los procesadores YOLO27n y YOLO27s están diseñados para aplicaciones donde la velocidad de inferencia y la eficiencia computacional son fundamentales.
Los detectores de objetos tradicionales suelen predecir los objetos utilizando tres mapas de características:
- Características de alta resolución
- Características de resolución media
- Características de baja resolución
YOLO27n y YOLO27s eliminan la escala de predicción media.
En cambio, utilizan:
- Un mapa de características detalladas para objetos pequeños
- Un mapa de características aproximadas para objetos grandes
Eliminar el mapa de predicción medio reduce una parte significativa del cálculo del cabezal de detección, al tiempo que conserva las escalas de características consideradas más importantes para objetos pequeños y grandes.
Este diseño hace que los modelos más pequeños sean particularmente interesantes para:
- IA de borde
- Drones
- Robótica
- Cámaras inteligentes
- vídeo en tiempo real
- Los sistemas embebidos
Detección de objetos pequeños en YOLO27
La detección de objetos pequeños sigue siendo uno de los retos más difíciles en la visión por computadora.
Los objetos que ocupan solo un pequeño número de píxeles contienen menos información visual, lo que dificulta su clasificación y localización.
Esto es especialmente importante en:
- Imágenes de drones
- Monitoreo de tráfico
- Imágenes de satélite
- Vigilancia
- Vehículos autónomos
- Análisis de vídeo de grandes áreas
Nuestra guía detallada sobre la detección de objetos pequeños en visión artificial: desafíos, técnicas y tendencias futuras explora por qué los objetivos pequeños son difíciles de detectar y las técnicas utilizadas para mejorar su reconocimiento.
YOLO27n y YOLO27s abordan este desafío ampliando una etapa inicial de características de alta resolución para que la red pueda retener información más detallada.
En combinación con el mapa de predicción de alta resolución restante, esto tiene como objetivo mejorar la localización y la regresión de objetos pequeños.
Supervisión de la alineación en primer plano
YOLO27n y YOLO27s también introducen la supervisión de alineación del primer plano.
Durante el entrenamiento, una rama auxiliar ligera aprende a separar los objetos en primer plano de las regiones de fondo. Esto cierra la brecha entre la supervisión de entrenamiento intensivo y el cabezal de predicción final uno a uno.
Según Ultralytics, la diferencia de precisión se reduce aproximadamente de:
- De 0.9 mAP a 0.4 mAP para YOLO26n → YOLO27n
- De 0.8 mAP a 0.4 mAP para YOLO26s → YOLO27s
La rama adicional se utiliza únicamente durante el entrenamiento y se elimina durante la inferencia y la exportación, lo que significa que no añade cálculos en tiempo de despliegue.
YOLO27m y YOLO27l: Detección sin NMS
Los modelos YOLO27 de mayor tamaño adoptan un enfoque diferente.
En lugar de generar muchas predicciones superpuestas y filtrarlas mediante la supresión no máxima, YOLO27m y YOLO27l utilizan un decodificador transformador basado en consultas.
El decodificador trabaja con un conjunto fijo de consultas de objetos y las refina progresivamente para producir las detecciones finales.
Esto significa que las predicciones finales se pueden generar directamente sin el posprocesamiento NMS tradicional.
¿Por qué es importante la detección sin NMS?
Los sistemas tradicionales de detección de objetos suelen generar múltiples cuadros candidatos para un mismo objeto.
El sistema NMS se encarga entonces de eliminar las predicciones redundantes.
Aunque NMS funciona bien, añade un paso adicional de posprocesamiento al proceso de inferencia.
Eliminar este paso puede proporcionar potencialmente:
- Baja latencia
- Implementación más sencilla
- Inferencia más predecible
- Posprocesamiento reducido
- Mejor integración con sistemas de extremo a extremo
La detección sin NMS es una tendencia importante en la visión artificial moderna en tiempo real, y YOLO27 continúa en esta dirección.
Nuestro artículo anterior sobre YOLO26 también analiza la transición hacia la detección de extremo a extremo sin NMS.
YOLO27m: El equilibrio entre precisión y velocidad.
El YOLO27m se posiciona como un punto intermedio entre los modelos N/S, ligeros, y el modelo L, centrado en la precisión.
El modelo combina el decodificador transformador basado en consultas con una red neuronal convolucional basada en la arquitectura YOLO26.
Según la evaluación comparativa preliminar de Ultralytics, YOLO27m logra:
55.8 mAp con una resolución de entrada de 640 píxeles.
con aproximadamente:
Latencia de inferencia de 1.39 ms en una NVIDIA RTX PRO 6000 usando TensorRT 11.
Esto hace que YOLO27m sea particularmente interesante para aplicaciones de producción basadas en GPU, donde las organizaciones necesitan un equilibrio sólido entre precisión y latencia.
YOLO27l y UltraViT
YOLO27l es el modelo insignia de la nueva familia, que combina la detección basada en consultas con la arquitectura UltraViT . La etapa más profunda utiliza mecanismos de autoatención para capturar el contexto visual global en todo el fotograma.
Este campo receptivo global permite a la red reconocer con precisión relaciones complejas entre elementos visuales distantes. Según Ultralytics, YOLO27l es el primer modelo de su gama en superar el umbral de 60 mAP en COCO.
Informe de resultados preliminares:
- 60.4 mA a 640 píxeles
- 61.2 mA a 800 píxeles
- Aproximadamente 2.32 ms Latencia a 640 píxeles en una NVIDIA RTX PRO 6000
Estos resultados son preliminares y pueden cambiar antes de la publicación final.
Pruebas de rendimiento de YOLO27
Ultralytics ha publicado datos preliminares de referencia sobre la detección de los cuatro modelos YOLO27.
Modelo | Entrada | mAP50-95 | CPU ONNX | RTX PRO 6000 TensorRT | Parámetros | FRACASOS |
YOLO27n | 640 | 42.3 | 16.1 ms | 0.62 ms | 3.0 m | 7.2B |
YOLO27s | 640 | 49.6 | 33.2 ms | 0.79 ms | 11.8 m | 28.2B |
YOLO27m | 640 | 55.8 | 67.2 ms | 1.39 ms | 22.8 m | 65.0B |
YOLO27l | 640 | 60.4 | 149.6 ms | 2.32 ms | 72.3 m | 165.3B |
Las pruebas de rendimiento oficiales se realizaron con una NVIDIA RTX PRO 6000 utilizando TensorRT 11 y FP16 para la inferencia de la GPU, mientras que las mediciones de la CPU utilizaron un AMD EPYC 9655 con ONNX Runtime y FP32.
Estas cifras deben considerarse como puntos de referencia para la investigación, en lugar de como garantía de rendimiento en la producción.
El rendimiento real dependerá de:
- Componentes metálicos
- Resolución de entrada
- Runtime
- Precisión
- Conjunto de datos
- Tamaño del lote
- Configuración de optimización
- Entorno de implementación
¿Qué significan los números YOLO27?
Los cuatro tamaños de modelo están diseñados para satisfacer diferentes necesidades.
YOLO27n
YOLO27n tiene solo 3 millones de parámetros y está diseñado para una inferencia altamente eficiente.
Las aplicaciones potenciales incluyen:
- Dispositivos de borde
- Cámaras integradas
- Drones
- Robótica
- sistemas de visión IoT
YOLO27s
YOLO27s proporciona una mayor capacidad de modelado manteniendo una latencia muy baja.
Puede resultar útil cuando una aplicación necesita mayor precisión sin dejar de requerir rendimiento en tiempo real.
YOLO27m
YOLO27m es la opción intermedia.
Su resultado preliminar de 55.8 mAP lo hace atractivo para aplicaciones basadas en GPU que necesitan un equilibrio entre precisión y velocidad de inferencia.
YOLO27l
YOLO27l prioriza la precisión.
Con un valor preliminar de 60.4 mAP a 640 píxeles, está diseñado para aplicaciones donde la calidad de detección es más importante que la minimización del tamaño del modelo.
Tareas de visión artificial compatibles con YOLO27
YOLO27 está diseñado como un marco de visión multitarea unificado, en lugar de un detector de objetos independiente. Más allá de la detección de cuadros delimitadores, el ecosistema admite de forma nativa múltiples tareas posteriores dentro de la misma arquitectura:
Task | Capacidad básica | Aplicaciones clave |
Detección de objetos y OBB | Cuadros delimitadores estándar y orientados | Seguridad, análisis aéreo/satélite y de comercio minorista |
Segmentación | Enmascaramiento de instancias y semántico | Imágenes médicas, conducción autónoma, detección de defectos industriales |
Postura y seguimiento | Estimación de puntos clave y seguimiento de múltiples objetos | Análisis deportivo, seguridad laboral, videovigilancia |
Clasificación y profundidad | Categorización de escenas y estimación de distancias | Categorización de productos, robótica, comprensión de escenas 3D |
Para los desarrolladores que buscan comprender el panorama general de la detección de objetos, nuestra guía " Los mejores modelos de detección de objetos para visión artificial en 2026" compara los principales enfoques y modelos.
YOLO27 para vídeo en tiempo real
El vídeo en tiempo real es uno de los casos de uso más importantes para los modelos YOLO.
Un sistema de visión artificial que procesa vídeo puede necesitar analizar docenas de fotogramas por segundo manteniendo al mismo tiempo una detección precisa.
Esto crea una disyuntiva fundamental:
Una mayor precisión suele requerir más cálculos.
A menudo, una mayor velocidad requiere un modelo más pequeño.
YOLO27 soluciona este problema mediante la utilización de varios tamaños de modelo.
Los modelos YOLO27n y YOLO27s están diseñados para implementaciones de alta eficiencia, mientras que los modelos YOLO27m y YOLO27l ofrecen una mayor capacidad de modelado para aplicaciones basadas en GPU.
Esto permite a los desarrolladores seleccionar un modelo de acuerdo con sus requisitos de hardware y precisión.
YOLO27 para drones
Los drones requieren sistemas de visión artificial que puedan funcionar con recursos computacionales limitados.
Un dron podría necesitar detectar:
- Personas
- Vehículos
- Edificios
- Carreteras
- Obstáculos
- Otros aviones
- Objetos de interés
Al mismo tiempo, el hardware informático integrado debe funcionar dentro de las limitaciones de potencia y peso.
Los modelos YOLO27n y YOLO27s están específicamente diseñados para dispositivos periféricos, drones y vídeo en tiempo real.
La mejora en la detección de objetos pequeños de los modelos más pequeños también podría resultar valiosa para aplicaciones aéreas en las que los objetivos ocupen solo una pequeña parte de cada fotograma.
YOLO27 para vehículos autónomos
Los vehículos autónomos requieren una percepción continua de su entorno.
Un sistema de percepción puede necesitar identificar:
- Carros
- Camiones
- Los peatones
- Ciclistas
- Señales de tráfico
- Semáforos
- Obstáculos en la carretera
La latencia de inferencia es fundamental porque es posible que sea necesario tomar decisiones en cuestión de milisegundos.
La combinación de inferencia en tiempo real y precisión de detección mejorada de YOLO27 hace que esta familia de modelos sea potencialmente útil para sistemas de percepción automotriz.
Sin embargo, los resultados de las pruebas de rendimiento en COCO no deben interpretarse como prueba del desempeño de la conducción autónoma. Los sistemas automotrices reales requieren conjuntos de datos específicos del dominio, pruebas exhaustivas, validación de seguridad y optimización específica del hardware.
Para las organizaciones que desarrollan sistemas de percepción para vehículos autónomos, los datos de entrenamiento de alta calidad son igualmente importantes. Nuestro estudio de caso sobre la anotación de sistemas de percepción para vehículos autónomos explora cómo la anotación a gran escala puede contribuir al desarrollo de la visión artificial.
YOLO27 para seguridad y vigilancia.
Los sistemas de seguridad dependen cada vez más de la visión artificial para procesar grandes cantidades de vídeo.
Las posibles tareas de detección incluyen:
- Detección de personas
- Detección de vehículos
- Vigilancia de zonas restringidas
- Análisis de multitudes
- Detección de objetos abandonados
- Monitoreo de seguridad
Los modelos ligeros como YOLO27n y YOLO27s podrían instalarse cerca de las cámaras, reduciendo la cantidad de vídeo sin procesar que debe transmitirse a servidores centralizados.
El procesamiento en el borde puede reducir potencialmente:
- Ancho de banda de la red
- Costos de procesamiento en la nube
- Latencia de respuesta
También puede admitir arquitecturas orientadas a la privacidad, donde el vídeo se procesa localmente en lugar de subirse continuamente.
YOLO27 para inspección industrial
Los fabricantes utilizan cada vez más la visión artificial para automatizar el control de calidad.
Un modelo YOLO entrenado puede detectar defectos como:
- Arañazos
- Grietas
- Componentes faltantes
- Montaje incorrecto
- Daños en la superficie
- Defectos de fabricación
Para las líneas de producción de alta velocidad, la latencia de inferencia es especialmente importante.
Un modelo que tarda demasiado en procesar cada imagen puede convertirse en un cuello de botella en el flujo de trabajo de fabricación.
La variedad de tamaños de modelos de YOLO27 podría permitir a los fabricantes equilibrar la precisión de detección y la velocidad de la línea de producción.
YOLO27 para IA médica
La visión artificial también está adquiriendo cada vez más importancia en la IA médica.
Las aplicaciones potenciales incluyen:
- Detección de estructuras anatómicas
- Detección de lesiones
- Segmentación de órganos
- Clasificación de imágenes médicas
- Análisis celular
- control de calidad de imágenes médicas
El soporte previsto de YOLO27 para la detección, segmentación, clasificación y estimación de profundidad proporciona una amplia base técnica para sistemas especializados de visión artificial en el ámbito médico.
Sin embargo, la IA médica requiere mucha más validación que las aplicaciones de visión artificial convencionales.
Una buena puntuación de referencia no significa automáticamente que un modelo sea clínicamente seguro, diagnósticamente preciso o adecuado para su uso reglamentario.
Los proyectos de IA médica requieren conjuntos de datos cuidadosamente seleccionados, anotaciones de expertos, validación y una supervisión clínica adecuada.
Entrenamiento de YOLO27 con conjuntos de datos personalizados
Una de las mayores ventajas del ecosistema Ultralytics es su enfoque en la formación personalizada.
Una vez que YOLO27 se lance oficialmente, se espera que los desarrolladores puedan usar la conocida API de Ultralytics para entrenar modelos con conjuntos de datos personalizados.
La documentación oficial actualmente proporciona un flujo de trabajo planificado similar a:
de ultralytics importar YOLO
# Cargar un modelo YOLO27
modelo = YOLO(“yolo27n.pt”)
# Ejecutar inferencia
resultados = modelo(“imagen.jpg”)
# Entrenar con un conjunto de datos
resultados = modelo.entrenar(
datos="coco8.yaml",
épocas = 100,
imgsz=640
)
Sin embargo, este código no funcionará con el paquete público actual, ya que los pesos y la implementación de YOLO27 aún no se han publicado.
Antes de entrenar un modelo YOLO para producción, la calidad del conjunto de datos debe ser una consideración fundamental.
Nuestra guía " Ajuste fino de modelos YOLO con un proceso automatizado de etiquetado de datos" explora cómo se pueden combinar el etiquetado automatizado, la verificación humana y la mejora iterativa del modelo para crear flujos de trabajo de entrenamiento YOLO eficientes.
Por qué la calidad de los datos es importante para YOLO27
Un modelo más avanzado no elimina la necesidad de datos de entrenamiento de alta calidad.
Si los datos de entrenamiento contienen:
- Cuadros delimitadores incorrectos
- Objetos perdidos
- Etiquetas inconsistentes
- Mala calidad de imagen
- Desequilibrio de clases
- Máscaras de segmentación incorrectas
Entonces, incluso un modelo potente puede producir resultados poco fiables.
En los sistemas de visión artificial para producción, el flujo de datos puede ser tan importante como la arquitectura del modelo.
Un flujo de trabajo típico puede incluir:
- Recopilación de datos
- Limpieza de datos
- Anotación
- Control de calidad
- Entrenamiento modelo
- de calidad
- Análisis de errores
- Recopilación de datos adicionales
- Reentrenamiento
- Despliegue de producción
Esto es especialmente importante para aplicaciones especializadas como la conducción autónoma, las imágenes médicas, la inspección industrial y la inteligencia artificial geoespacial.
YOLO27 y anotación de datos
El rendimiento potencial de YOLO27 depende en última instancia de la calidad y la diversidad de los datos utilizados para entrenarlo y evaluarlo.
Para aplicaciones de visión artificial personalizadas, las organizaciones pueden necesitar:
- Anotación de cuadro delimitador
- Segmentación de polígonos
- Segmentación semántica
- Anotación de puntos clave
- Cuadros delimitadores orientados
- Anotación LiDAR
- Anotación de vídeo
- Clasificación de la imagen
SO Development proporciona servicios de anotación de imágenes Para proyectos de visión artificial que requieren datos de entrenamiento a gran escala y listos para la producción.
La combinación de anotaciones de alta calidad con el preetiquetado automatizado y el control de calidad humano puede ayudar a los equipos a crear conjuntos de datos adecuados para el ajuste preciso de modelos de visión especializados.
Una interfaz para diferentes arquitecturas YOLO27
A pesar de las diferencias arquitectónicas entre YOLO27n/s y YOLO27m/l, se espera que los desarrolladores interactúen con los modelos a través de la misma interfaz Python de YOLO.
Esta es una importante ventaja en cuanto a usabilidad.
Por ejemplo, después del lanzamiento, un desarrollador podría cargar un modelo Nano con:
modelo = YOLO(“yolo27n.pt”)
y luego cambiar a:
modelo = YOLO(“yolo27m.pt”)
sin rediseñar toda la aplicación.
Ultralytics afirma que la secuencia correcta de entrenamiento, validación, predicción y exportación se selecciona automáticamente en función de la arquitectura del modelo.
Esto debería facilitar la comparación de diferentes tamaños de modelos con la misma aplicación y conjunto de datos.
¿Qué modelo de YOLO27 debería elegir?
El modelo adecuado depende del entorno de implementación.
Aplicación | Opción potencial |
IA de borde | YOLO27n |
Drones | YOLO27n / YOLO27s |
Cámaras inteligentes | YOLO27n / YOLO27s |
vídeo en tiempo real | YOLO27n / YOLO27s |
Producción de GPU | YOLO27m |
Equilibrio entre precisión y velocidad | YOLO27m |
Aplicaciones que requieren precisión | YOLO27l |
Detección de alta resolución | YOLO27l |
Según las directrices actuales de Ultralytics, YOLO27n y YOLO27s están diseñadas para dispositivos periféricos, drones y vídeo en tiempo real; YOLO27m se posiciona como la opción de precisión y velocidad para la implementación de GPU; y YOLO27l está dirigida a aplicaciones que requieren una precisión crítica.
YOLO27 frente a otros modelos de detección de objetos
YOLO27 se incorpora a un ecosistema de visión artificial cada vez más competitivo.
Los desarrolladores pueden elegir entre:
- Modelos YOLO
- RT-DETR
- Detectores basados en transformadores
- Modelos de vocabulario abierto
- Modelos de la Fundación Visión
- Modelos de borde especializados
La elección de la mejor arquitectura depende de los requisitos del proyecto.
Los factores a considerar incluyen:
- Exactitud
- Estado latente
- Componentes metálicos
- Tamaño del conjunto de datos
- Costo de formación
- Entorno de implementación
- Requisitos de vocabulario abierto
- Requisitos de segmentación
- Requisitos de seguimiento
Nuestra guía " Los mejores modelos de detección de objetos para visión artificial en 2026" ofrece una comparación más amplia de los principales modelos y enfoques de visión artificial.
¿Deberías actualizar de YOLO26 a YOLO27?
Aún no.
YOLO27 aún no ha sido lanzado.
Ultralytics recomienda actualmente utilizar YOLO26 para los proyectos existentes y evaluar YOLO27 después de su lanzamiento final.
Una vez que YOLO27 esté disponible públicamente, los equipos deberían comparar su rendimiento con sus propias cargas de trabajo en lugar de basarse exclusivamente en los resultados de COCO.
Las métricas importantes incluyen:
- mapa
- Precisión
- Recordar
- latencia de inferencia
- Uso de memoria
- Rendimiento de la CPU
- Rendimiento de la GPU
- Compatibilidad de exportación
- Consumo de energía
- Tasas de error en el mundo real
Un modelo que funciona mejor en COCO no necesariamente funcionará mejor en un conjunto de datos de producción especializado.
¿Cuándo se lanzará YOLO27?
Según la documentación actual de Ultralytics, YOLO27 se encuentra en la fase final de investigación y desarrollo, y se prevé su lanzamiento a finales de 2026.
Sin embargo, no se ha anunciado ninguna fecha de lanzamiento oficial.
Los pesos del modelo, los archivos de configuración y el código de implementación no están disponibles actualmente. Ultralytics también advierte que las características y los puntos de referencia mostrados en la vista previa pueden cambiar antes del lanzamiento.
Los desarrolladores interesados en la versión pueden consultar la documentación oficial de YOLO27 y esperar a que se publique el paquete público y los pesos preentrenados.
El futuro de la visión artificial en tiempo real.
YOLO27 pone de relieve una dirección importante en la visión por computadora: la convergencia de arquitecturas CNN eficientes, detección basada en transformadores e inferencia de extremo a extremo.
En lugar de utilizar una única arquitectura para cada tamaño de modelo, Ultralytics emplea diferentes enfoques en función de los requisitos.
Modelos más pequeños
YOLO27n y YOLO27s se centran en:
- Baja latencia
- Computación eficiente
- Detección de objetos pequeños
- Implementación de borde
Modelos más grandes
Los modelos YOLO27m y YOLO27l se centran en:
- Detección basada en consultas
- inferencia sin NMS
- Decodificación de transformador
- Mayor precisión
- Implementación de GPU
Este enfoque refleja un cambio más amplio en la visión por computadora hacia modelos optimizados no solo para la precisión en las pruebas de referencia, sino también para su implementación práctica.
Conclusión
Ultralytics YOLO27 representa un interesante paso adelante en la evolución de la visión artificial en tiempo real.
En lugar de limitarse a aumentar el tamaño del modelo, la próxima familia YOLO27 introduce diferentes arquitecturas para diferentes requisitos de implementación.
Los modelos YOLO27n y YOLO27s están diseñados en torno a una detección eficiente basada en redes neuronales convolucionales (CNN), predicción a doble escala y una representación mejorada de objetos pequeños.
YOLO27m y YOLO27l introducen la detección basada en consultas y sin NMS mediante la decodificación por transformador.
En la gama alta, YOLO27l combina este enfoque con una arquitectura UltraViT y actualmente reporta un rendimiento preliminar de 60.4 mAP a 640 píxeles y 61.2 mAP a 800 píxeles en COCO.
Sin embargo, es importante recordar que YOLO27 aún no ha sido lanzado al público.
Sus parámetros de referencia actuales son preliminares, su implementación no está disponible y las especificaciones finales pueden cambiar.
Para proyectos de producción actuales, YOLO26 sigue siendo la opción recomendada. Una vez que se lance YOLO27, los desarrolladores deberían evaluar el rendimiento de los nuevos modelos con sus propios conjuntos de datos y hardware antes de migrar.
La lección más importante es que la arquitectura del modelo es solo una parte de un sistema de visión artificial exitoso. Los datos de entrenamiento de alta calidad, la anotación precisa, el control de calidad riguroso, el hardware adecuado y la evaluación continua siguen siendo esenciales.
Para las organizaciones que desarrollan sistemas de visión especializados, la combinación de modelos avanzados, datos de alta calidad y anotaciones verificadas por humanos seguirá siendo un factor clave para lograr un rendimiento de producción fiable.
A medida que YOLO evoluciona hacia arquitecturas más rápidas, precisas y cada vez más integrales, YOLO27 podría convertirse en un paso importante hacia la próxima generación de percepción de IA en tiempo real.
Preguntas frecuentes
¿Qué es YOLO27?
YOLO27 es una próxima familia de modelos de visión artificial en tiempo real de Ultralytics. Incluye variantes Nano, Pequeña, Mediana y Grande, y está diseñada para admitir detección, segmentación, clasificación, estimación de pose y profundidad, y detección de objetos orientados.
¿Ya está disponible YOLO27?
No. YOLO27 se encuentra actualmente en la fase final de investigación y desarrollo. La documentación oficial indica que se prevé su lanzamiento a finales de 2026, pero aún no se ha anunciado una fecha de lanzamiento definitiva.
¿Cuál es la principal mejora de YOLO27?
Las principales mejoras incluyen la detección de doble escala para YOLO27n/s, una detección de objetos pequeños más robusta, supervisión de alineación del primer plano y detección sin NMS basada en consultas para YOLO27m/l.
¿Es YOLO27 mejor que YOLO26?
Las pruebas preliminares demuestran una mayor precisión en toda la familia de detectores YOLO27, pero YOLO27 aún no se ha lanzado. Ultralytics recomienda actualmente utilizar YOLO26 para proyectos de producción.
¿Qué modelo de YOLO27 es el mejor para dispositivos periféricos?
Los modelos YOLO27n y YOLO27s son los que actualmente se utilizan en dispositivos periféricos, drones y vídeo en tiempo real.
¿Qué modelo YOLO27 tiene la mayor precisión?
Entre las pruebas de detección preliminares de 640 píxeles, YOLO27l presenta la mayor precisión reportada, con 60.4 mAP, que aumenta a 61.2 mAP a 800 píxeles.
¿Se puede entrenar YOLO27 con conjuntos de datos personalizados?
La documentación oficial proporciona ejemplos de capacitación destinados a ser utilizados después del lanzamiento de YOLO27 y cuando el paquete tenga soporte. El paquete público actual aún no es compatible con YOLO27.
¿Por qué son importantes los datos de entrenamiento para YOLO27?
Incluso los modelos avanzados de visión artificial dependen de datos de entrenamiento precisos y representativos. Las anotaciones incorrectas, la falta de objetos, las etiquetas inconsistentes y las imágenes de baja calidad pueden reducir significativamente el rendimiento del modelo.
Relacionado: SO Development Artículos
Si quieres saber más sobre YOLO y la visión artificial, explora:
- YOLO26: La próxima evolución de la visión artificial en tiempo real
- Cómo utilizar YOLOv11 para la detección de objetos
- Detección de objetos pequeños en visión artificial
- Ajuste fino de modelos YOLO con un proceso automatizado de etiquetado de datos
- Los mejores modelos de detección de objetos para visión artificial en 2026
- Aceleración del desarrollo de modelos de percepción de vehículos autónomos mediante anotaciones a gran escala.
- SO Development Servicios de anotación de imágenes
Fuente oficial: Documentación de Ultralytics YOLO27